主题
第 1 章 沿一次训练看完整仓库
1.1 我们到底要把什么训练起来
假设手里只有一段文字,希望模型读到“ab”以后,能给下一个字符一个概率分布。模型不直接保存一张“前缀到答案”的字典,而是把文字变成整数、把整数查成向量,再经过多层计算。训练时,程序知道每个位置后面实际出现的 token,用它来纠正模型。生成时,程序从模型给出的概率分布中抽取一个 token,接回输入,继续预测。
nanoGPT 把这条链分成了几个文件。data/*/prepare.py 负责把文字写成整数文件,model.py 定义可求导的计算,train.py 组织数据、梯度、优化器和保存,sample.py 负责把训练结果再变成文字。最值得学习的是这些文件之间的约定:训练脚本相信二进制文件使用正确的整数类型,模型相信编号没有超过词表,采样脚本相信解码器与训练时一致。任何一处“各自看起来没错”的改动,都可能破坏整条链。固定版本仓库
本书讲解固定提交 3adf61e154c3fe3fca428ad6bc3818b27a3b8291。该版本 README 已在 2025 年 11 月注明项目旧且已弃用,并指向 nanochat。本书保留这个历史边界:我们用 nanoGPT 学会核对一个训练系统,不把它当作持续更新的生产训练框架,也不悄悄把章节改写成 nanochat 使用说明。
1.2 训练的一个最小闭环
全书用同一组符号。x 和目标 y 都是形状
例如整数流为 [2, 3, 1, 4, 2],取长度为 4 的窗口:输入为 [2,3,1,4],目标为 [3,1,4,2]。一个前向传播同时产生四道“下一个 token 是什么”的题。因果掩码保证第一道题看不到后面的答案,但训练仍可把四道题并行计算。交叉熵把分数压缩成一个损失,反向传播求参数梯度,AdamW 用梯度和历史统计量更新参数。这才是一次优化器更新。
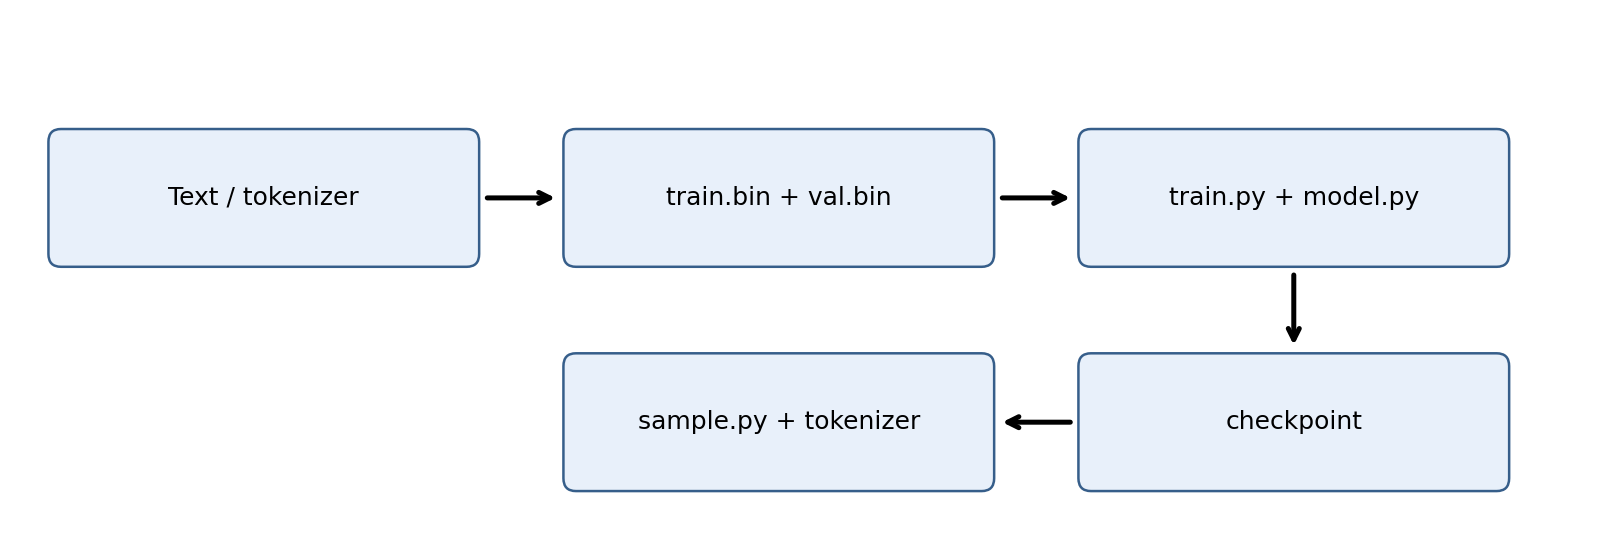
图中 checkpoint 并不是一个只装权重的袋子。它还装有优化器状态、模型结构参数、迭代编号和部分训练配置;但没有保存完整随机数状态。第 9 章会用实际恢复实验说明,这个差别为什么会让“能接着训练”与“逐位复现未中断训练”成为两个问题。
1.3 文件地图与阅读顺序
| 文件或目录 | 它回答的问题 | 重点章节 |
|---|---|---|
data/ 三条流水线及说明 | token 从哪里来,如何切分和写盘 | 2、7 |
configurator.py 与 7 个配置文件 | 谁可以覆盖默认值,何时生效 | 3、10、12 |
model.py | 每层算什么,参数如何组织 | 4—6、11、13 |
train.py | 哪一步读取数据、求导、评估和保存 | 7—10 |
sample.py | 如何加载并生成,如何还原文字 | 11 |
bench.py | 测的到底是哪段时间 | 13 |
| 两份 notebook | 参数、算力和数据规模怎样估算 | 14 |
| README、许可、Git 配置及资产 | 历史报告、分发和证据边界 | 1、15 |
仓库不是按执行顺序排列的课程。直接从 train.py 第一行读到最后,容易在不熟悉模型时陷入配置细节,也容易在没有数据约定时误读损失。本书先确认数据和配置,再拆模型,再回到训练循环。每章都能指回源文件;第 14 章把两份 notebook 的 43 个单元逐一登记,第 15 章给出完整测试入口和覆盖台账。
1.4 哪些结果已经实际运行
本书在 Python 3.12.14、PyTorch 2.6.0+cpu、NumPy 2.3.5 上使用单 CPU 线程验证。完整入口 examples/tiny_pipeline.py 会复制四份固定源码到隔离目录,构造五字符合成语料,运行原版训练、恢复和采样。训练使用
真实输出中,初始验证损失为 1.6728,step 20 为 1.0560,恢复后的 step 25 为 0.9835。这说明程序能在这组简单模式上降低交叉熵,也说明保存、加载和生成链路接通了。它没有证明模型会写自然语言,更没有复现 README 报告的 GPT-2 训练。GPU、NCCL、混合精度和大规模性能在本书中是源码分析,不是实测结论。
读者可先运行闭环,再回来逐章解释每个开关:
sh
python examples/tiny_pipeline.py
python examples/verify_mechanics.py
python examples/check_notebooks.py
配套包包括固定源码及 MIT 许可,路径均相对于本书根目录;依赖版本和安装边界见第 15 章。所有书中新实验、图解、推导和习题均为教学补充。原始 notebook 的已有输出若未经此次重跑,不作为本次实测。
1.5 练习:先建立可核对的问题
补充练习。 修改模型宽度后,旧 checkpoint 一定能恢复吗?只把 sample.py 的提示换成中文,又可能在哪里失败?
提示。 先问“谁定义了张量形状”,再问“谁定义了字符编号”。
答案。 恢复训练时,脚本会用 checkpoint 覆盖宽度等结构参数,所以命令行改宽度通常不会产生新结构;手工强行加载不匹配的权重会报形状错误。字符模型的 stoi 只包含训练字符,中文提示若不在其中会触发 KeyError。这两类失败分别发生在参数协议和编码协议,不能都归为“模型不够大”。
本章来源
- 固定 README:定位、运行路径、历史数字与弃用通知
- 固定 train.py
- 本书实测:
qa/author/tiny_pipeline.json及tiny_train.log、tiny_resume.log、tiny_sample.log。