主题
第 5 章 逐层推导因果注意力、MLP 和残差
5.1 LayerNorm 沿哪个维度计算
一个位置的特征为
LayerNorm 的主要原因是提供可选偏置接口,归一化运算仍调用 F.layer_norm。LayerNorm
分母中的
5.2 Q、K、V 是三次线性投影,合成一次执行
输入 c_attn 输出
对某个批次与头,查询位置
点积把
| 操作 | 输入形状 | 输出形状 |
|---|---|---|
q @ k.transpose(-2,-1) | ||
| 行 softmax | 相同,每行和为 1 | |
att @ v | ||
| 合并各头 | 转轴、连续化、view | |
| 输出投影 |
transpose 通常只改变步幅,不把数据重新排成连续存储。源码在合并头之前显式 .contiguous(),然后 .view(B,T,C);如果省掉连续化,view 可能因步幅不兼容报错,或者不得不用能复制的 reshape。
5.3 掩码必须在 softmax 之前作用
自回归训练在位置
例如第二个位置可以看到第一个和第二个位置。若未归一化分数为
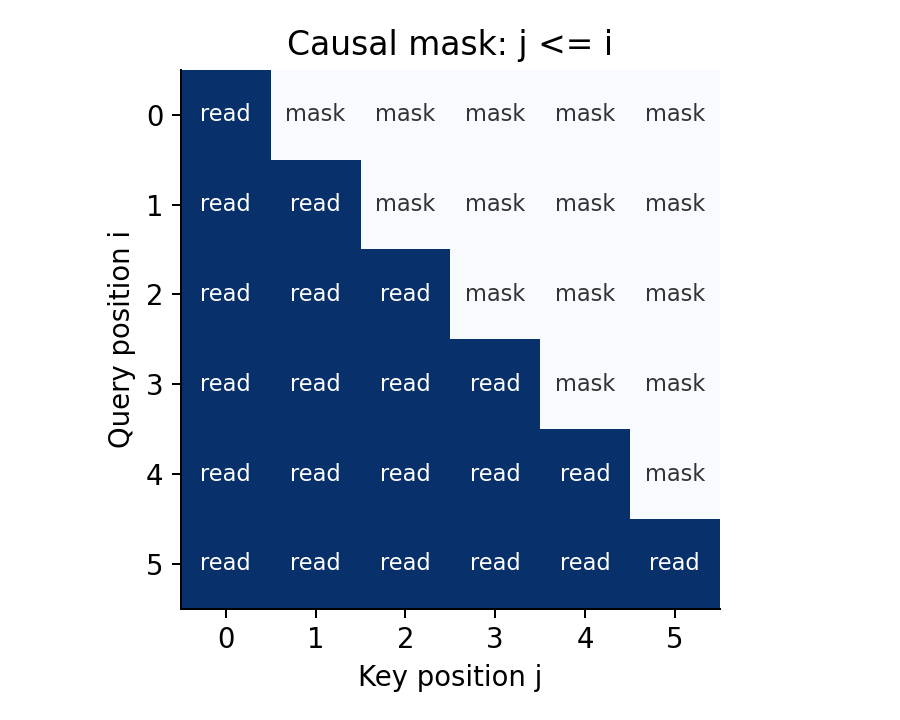
源码的手工实现把 mask 注册为 buffer,形状 masked_fill 是对分数设置禁区,不是把未来的输入 embedding 清零。层与层都保持同一因果关系,才能保证深层也不泄漏。
本书修改输入后半段、比较前半段 logits,最大误差实际为 0。这检验的是“在固定权重下,前缀输出不依赖后缀”,比只看掩码图更接近真正需要的性质。测试时关闭 dropout,否则两次前向可能因随机掩码不同而出现差异。
5.4 名为 flash,不保证用了 FlashAttention 内核
self.flash 只是检查 PyTorch 是否有 scaled_dot_product_attention 函数。存在时传入 is_causal=True,训练态使用配置 dropout,评估态明确传 0。这个标记不探测硬件,也不证明 CPU 上运行 CUDA FlashAttention。具体后端由 PyTorch、设备、dtype 和形状决定;本书 CPU 测试只能验证 SDPA 接口结果。固定实现
为了核对两条路径,本书复制同一个 double 模型,给副本显式注册下三角 buffer,再设 flash=False。仅翻转标记会失败,因为初始化时有 SDPA 的模型没有建立手工 mask。两条路径 logits 最大差为
手工路径显式保留
5.5 MLP 改每个位置,注意力连接位置
MLP 的第一层把
MLP 对每个位置使用同一组参数,但位置之间不直接通信。位置间混合由注意力承担,特征间非线性组合由 MLP 承担。Block.forward 依次执行
这是 pre-LN 结构:先归一化,再计算分支,最后加回原始残差流。每次相加双方都是
补充练习。 将 attention 输出投影改成 x + attn(...),会怎样?若把因果 mask 去掉而训练 loss 更低,能说模型更好吗?
答案。 残差相加的形状不兼容,需要额外投影才能定义运算,而那已经改变结构。去掉 mask 后模型可读到目标对应的未来输入,训练任务变得泄漏;更低损失不能作为自回归生成改善的证据。用前缀不变性测试可直接揭示这种反例。
本章来源
- model.py:LayerNorm、CausalSelfAttention、MLP、Block
- PyTorch SDPA 官方接口
- 本书核对程序:
examples/verify_mechanics.py,结果qa/author/mechanics.json。