主题
第 7 章 memmap 批次与下一 token 对齐
7.1 原始二进制没有自我说明能力
get_batch(split) 把 train.bin 或 val.bin 以 dtype=np.uint16, mode='r' 打开。memmap 让操作系统按需映射文件页,不要求先把整个语料读成一个常驻 NumPy 数组。它并不消除磁盘读取,也不保证任何随机访问模式都快。源码每次取批重新建立映射,注释将原因指向一个内存增长问题;本书把它当作该版本的工程选择,不把旧讨论里的现象推成所有 NumPy 版本的普遍定律。get_batch
文件里没有 dtype 或词表标识。若读错 dtype,模型不一定立刻报错。第一步检查应包括:文件字节数能否被元素字节数整除、token 总数是否大于 block_size、编号是否非负且小于词表、训练与验证文件是否真的来自不同切分。随机抽几个值只能发现显眼错误,完整范围检查要在准备数据时完成。
7.2 最后一扇窗口为什么从 N−T−1 开始
设文件有
torch.randint(N-T, (B,)) 的上界不包含在内,恰好得到这组合法起点。不是少取了一项,而是要给下一 token 留出一个位置。若 randint(0,...) 会失败。必须有
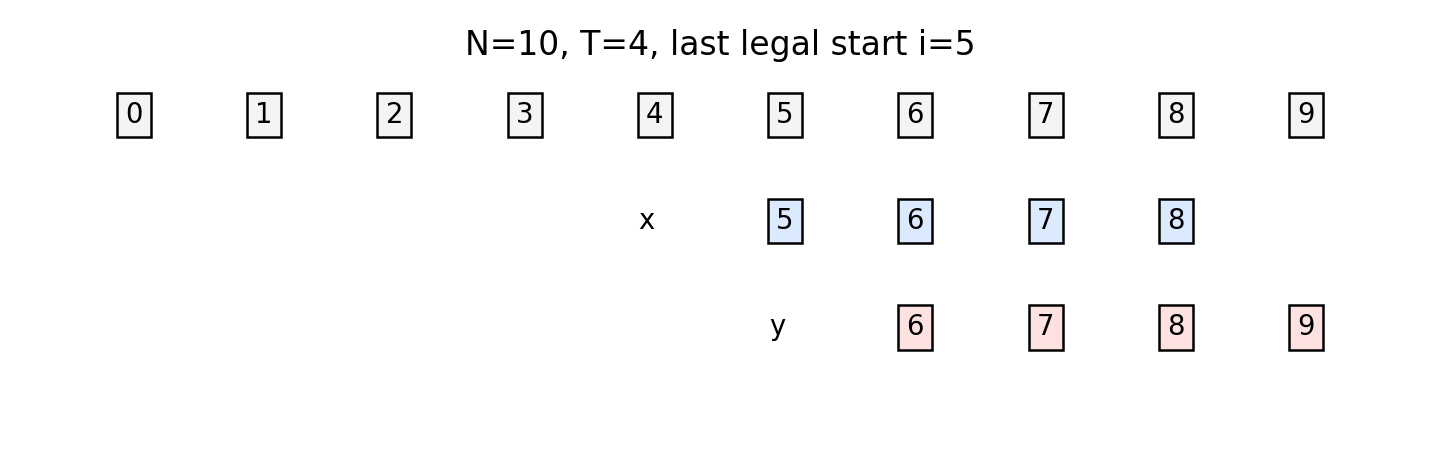
图中 [5,6,7,8],目标 [6,7,8,9]。如果错误地允许起点 6,输入有四项,目标只剩三项;如果把目标也从 5 开始,则模型在做复制当前 token,不再是预测下一个。两种错误的损失都不能与正常训练相提并论。
7.3 为什么磁盘上是 uint16,模型前是 int64
代码逐窗 .astype(np.int64),然后 torch.from_numpy,最后 stack 成
CUDA 路径先 .pin_memory(),再 .to(device, non_blocking=True)。固定页内存有助于支持主机到设备的异步复制;non_blocking=True 是允许异步的请求,实际重叠程度还取决于设备、流和工作安排。CPU 路径直接 .to(device)。MPS 虽然在配置注释中列为设备示例,但脚本把不含 cuda 的设备都划到 device_type='cpu' 分支,本书没有验证其性能或完整支持情况。
本书完整流水线的两个文件分别含 7168 与 1792 个 token,长度远大于
7.4 训练批次与验证批次共享随机数发生器
get_batch 使用 PyTorch 的全局随机数发生器。estimate_loss() 也调用同一函数。因此改变 eval_iters 或 eval_interval,即使不改变模型结构和初始 seed,也会改变后续训练窗口的随机序列。这解释了一个常见困惑:“我只是多验证几次,为什么之后训练不完全一样?”评估本身不求梯度,却会消耗随机状态。
最初的 X,Y 在主循环前已经取好。每次前向之后又预取下一批,再执行反向;循环结束时还留有一批等待下次使用。若要设计严格可恢复训练,仅保存 RNG 还不够,还要记录或重建这份已预取批次的位置。本书第 9 章将这项状态与 checkpoint 一起核对。
补充练习。 数据长度为 9、窗口长度为 8,合法起点有几个?改成长度为 8 呢?
答案。 前者只有起点 0,一个输入窗和一个错位目标窗;后者没有合法起点。增大 batch_size 会重复抽同一起点,不会凭空创造新样本。verify_mechanics.py 穷举了
本章来源
- train.py:memmap 与窗口
- bench.py 的另一份 get_batch,差异见第 13 章。
- 本书对齐测试:
qa/author/mechanics.json的last_legal_window。