主题
第 14 章 参数估算与 scaling laws:逐单元核对
14.1 先把 notebook 当成待验证的计算记录
transformer_sizing.ipynb 有 17 个单元,scaling_laws.ipynb 有 26 个。它们混合了可执行公式、实验假设、历史测量、绘图和未解决疑问。不能因为某个公式印在 notebook 里,就把旁边的 GPU 时间也当成自己测过。
本书用 examples/check_notebooks.py 按原顺序执行全部代码单元,只删除 Jupyter 专用的 %matplotlib inline 显示指令,图使用离线 Agg 后端保存。没有改变模型公式或网格范围,没有下载数据或权重。每个单元的 stdout 单独保存在 qa/author/notebook_execution.json;Markdown 单元只阅读和解释,不标为执行成功。下文单元编号从 0 开始,与原始 JSON 索引一致。两份 notebook 的固定版本
14.2 sizing:精确参数、近似 FLOPs 与假设时间
14.2.1 参数与存储:单元 0—7
单元 0 声明目标是估参数、FLOPs、峰值内存和 checkpoint。实际后续并没有完成完整峰值内存模型,最后还留下带宽 TODO;开头的目标不能替代实现。
单元 1 引入 OrderedDict,保证分项表顺序稳定。单元 2 选
单元 3 的 params() 按第 4 章的无偏置公式累加:位置、token embedding、注意力 LN/QKV/投影、MLP LN/扩展/压缩、最后 LN。dense=0 是因为共享矩阵已在 token embedding 算过。表中 embedding、block 等是小计,不能把所有行再相加,否则重复计数。源码把 position 键拼成 emebedding/position,其他函数沿用同一键,虽拼写不规范却不影响程序。本次得到 124337664,与单元硬编码的期望数一致。
单元 4 估计 FP32 参数占
单元 5 引出显存比例,6 用 40e9 字节作 GPU 容量分母,得参数加优化器约占 3.73%;7 据此讨论小模型中激活可能占较大份额。这里的 40 GB 使用十进制近似,不是通过设备查询得到的可用容量。完整训练显存还应算梯度约
14.2.2 FLOPs:单元 8—10
单元 8 过渡到前向成本,9 定义 flops()。一次
反向被近似为前向两倍,训练为前向三倍。这个估算未逐算 LayerNorm、softmax、GELU、dropout 与优化器,也按完整方阵成本计注意力,不模拟具体因果内核跳过哪些操作。本次前向 291648307200 FLOPs,前后向合计 874944921600 FLOPs,都是公式结果,不是 profiler 读取的硬件计数。
单元 10 的 palm_flops() 用
14.2.3 历史速度与预算:单元 11—16
单元 11 说明作者曾以总 batch=100、单次 0.755 秒测量;12 将这些固定数字代入
单元 14 用
| sizing 单元 | 本书解释位置 | 本次证据或边界 |
|---|---|---|
| 0、1、2 | 14.2.1 的目标、容器、无偏置配置 | 1、2 已执行;0 为说明 |
| 3 | 14.2.1 的参数分项与共享 | 已执行,124337664 |
| 4、5、6、7 | 14.2.1 的 checkpoint 与显存口径 | 4、6 复算;历史字节数未实测 |
| 8、9、10 | 14.2.2 的逐矩阵与 PaLM 近似 | 9、10 已执行 |
| 11、12、13 | 14.2.3 的历史 MFU | 12 复算;无 GPU 实测 |
| 14、15、16 | 14.2.3 的预算和未完成带宽估计 | 14 已执行;15 历史,16 TODO |
14.3 scaling:参数口径中藏着的差异
单元 0 就承认无法精确匹配所有 Chinchilla 数字,这个限制应随结果保留。单元 1 导入 matplotlib、NumPy、pandas 和 notebook 显示 magic;本书仅移除 magic。单元 2 引出参数分析,3 定义 gpt_params,4 声称与 124M 相符。scaling_laws.ipynb
gpt_params 虽然计算了 embeddings,最终却不加它,而另外加一个 sum(model.parameters()) 的 124439808。单元 4 的“完全匹配”文字应按这个口径纠正,不能只把四舍五入后的 124M 当精确一致。
单元 5 的 chinchilla_params 加入一项相对位置参数 num_heads 没有参与公式。单元 6 存入从论文表格转录的 50 个模型,每行包括参数量、模型宽度、MLP 宽度、KV 宽度、头数、层数;7 只打印末五行估算对照;8 承认近似。计算函数没有接收独立 KV 宽度,部分表行的投影维数关系不能靠
14.4 scaling 的 FLOPs 不计哪两项
单元 9 引出 FLOPs,10 的 chinchilla_flops 把每头宽度设为 d_model // num_heads,计算 QKV、QK、softmax、AV、输出投影及 MLP。它还算了 embedding 和 logits 两项,但最终 forward_flops 只取层数乘 attention+MLP,不把这两项加进去。源码注释把这个选择归于作者通信,本书没有独立核实该私人通信,不将其升级成“论文官方勘误”。
因此这里的“精细 FLOPs”与 sizing notebook 含输出头的公式不完全同口径。单元 11 构造论文表 A4 的六组结构,计算上述 FLOPs 除以
在小模型、大词表下,省掉输出头可能很重要;在大模型主干占比很高时,相对影响可能变小。若拿这些估算安排预算,至少先说明是否包含 embedding、输出 logits、反向、优化器和重计算。
14.5 Approach 3:从固定预算推最优 N、D
单元 13 提出损失拟合,14 定义
其中
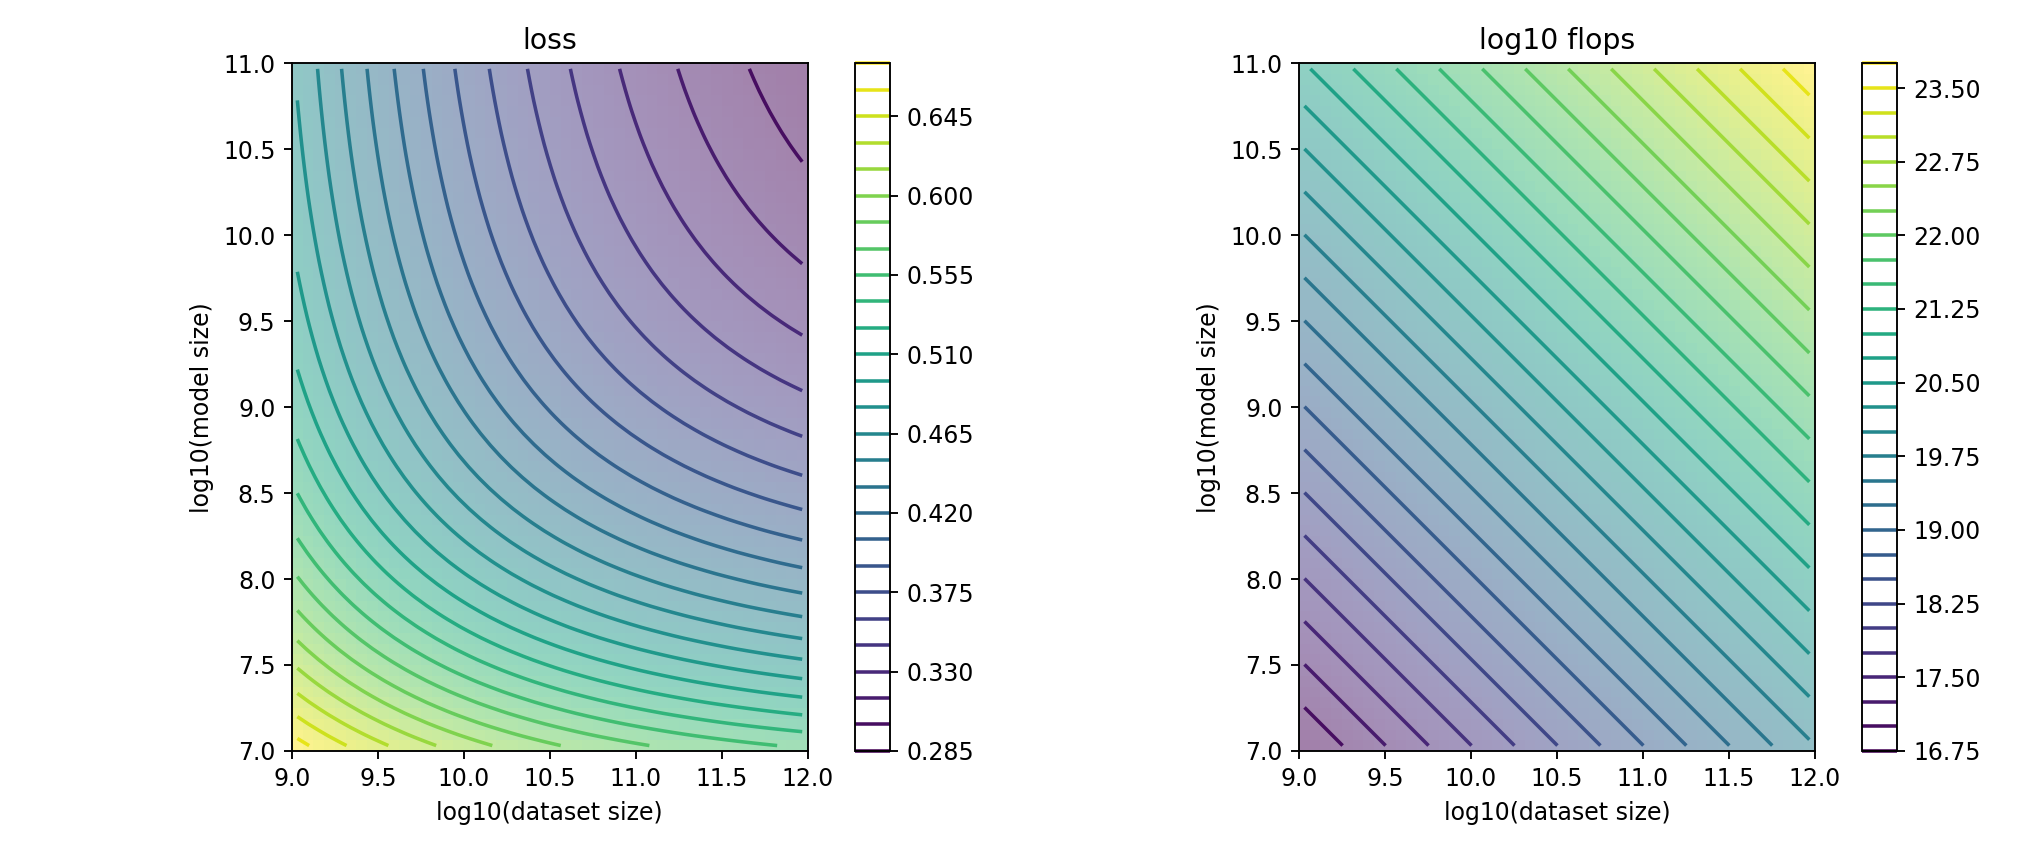
单元 15 问固定预算
对
所以
这一步展示了权衡:模型太小,第一项偏大;模型太大,同预算下数据变少,第二项偏大。
单元 16 用
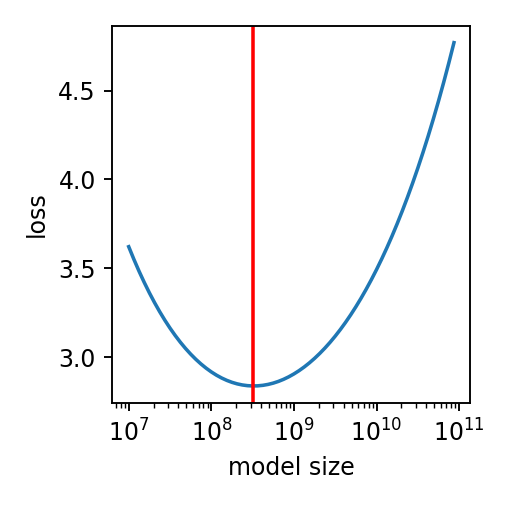
单元 18 对从
14.6 Approach 2:对表格作回归,不是重新训练模型
单元 21 描述另一种按固定算力实验拟合的思路,22 录入九组参数/token 对;注释还保留另一组 Approach 1 数据,但实际运行使用 Approach 2。23 在对数空间最小二乘拟合
设计矩阵每行为
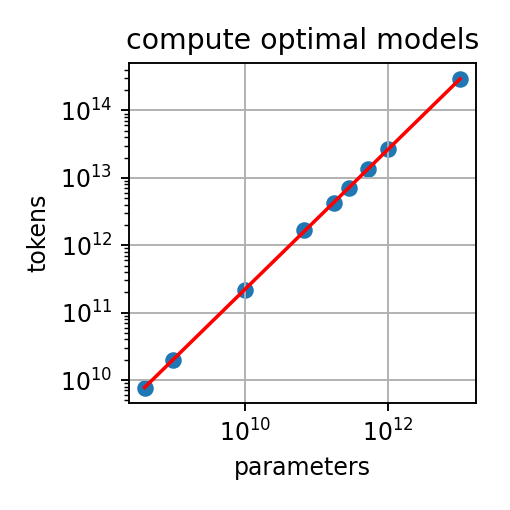
最后单元打印文字把 parameters 和 tokens 的角色写反了;按代码,输入是参数量,输出是预测 token 数。124M 还小于录入表的最小模型 400M,因此这是向下外推,不是数据区间内插值。这个约 2.29B 也不与 train_gpt2 配置的约 300B 构成代码矛盾:一个是特定近似下的计算最优建议,另一个是仓库为历史 GPT-2 复现目标设定的训练曝光量。目标不同,预算和评价也不同。
| scaling 单元 | 本书解释位置 | 执行与限定 |
|---|---|---|
| 0、1、2 | 14.1、14.3 | 1 执行,显示 magic 移除;0、2 为说明 |
| 3、4 | 14.3 GPT 参数口径 | 3 执行;纠正 4 的精确匹配措辞 |
| 5、6、7、8 | 14.3 Chinchilla 参数近似 | 5—7 执行,50 行数据保留;8 为说明 |
| 9、10、11、12 | 14.4 FLOPs 排除项与六行对照 | 10、11 执行;9、12 为说明 |
| 13、14、15 | 14.5 损失拟合及预算 | 14 执行并保存图;13、15 为说明 |
| 16、17 | 14.5 单预算网格与解析解 | 16 执行;17 的不一致保留 |
| 18、19、20 | 14.5 多预算与近邻 | 18、19 执行;20 为差异提醒 |
| 21、22、23、24、25 | 14.6 表格回归、图及查询 | 22—25 执行,纠正 25 的打印标签 |
14.7 练习:公式一致不等于问题一致
补充练习 1。 为什么 sizing 的 124337664 与 scaling 的 123653376 不同,不能只归咎于舍入?
答案。 前者无偏置、包含位置表,后者有偏置、不含位置表。两者字段口径不同,差值是可逐项计算的,远不只是 M 单位显示精度。
补充练习 2。 若预算固定,直接把
答案。 不在,
本章来源
- transformer_sizing.ipynb 固定源码
- scaling_laws.ipynb 固定源码
- Training Compute-Optimal Large Language Models
- PaLM: Scaling Language Modeling with Pathways
- 全单元 stdout、数值表、解析解:
qa/author/notebook_execution.json;完整可运行入口examples/check_notebooks.py。