主题
第 15 章 小规模复现、故障定位与仓库的历史边界
15.1 一条能在普通 CPU 上走完的路线
本书的首要验证目标是让原版的数据读取、模型、训练、保存、恢复和生成接成闭环,并用独立断言检查关键数学性质。运行规模刻意很小:五字符合成序列、2 层、2 头、宽度 16、窗口 8、微批次 2、累积 2。它不需要网络、API、预训练权重或大型语料。
配套目录应保留以下结构:
text
nanogpt_book/
  chapters/                  分章正文
  examples/                  四个完整可运行入口
  figures/                   原创图与 notebook 重绘图
  requirements-cpu.txt       本次验证依赖
  research/upstream/         固定 MIT 源码与 notebook
  research/UPSTREAM_LICENSE.txt
  research/author/           逐文件、定义、单元和配置覆盖
  qa/author/                 实验 JSON;日志与隔离运行目录由执行生成
在可信的本地目录解压。建议创建独立虚拟环境,依赖安装需联网,但下面四个实验本身离线。下面命令对应本书已经验证的 Linux CPU 环境,PyTorch 使用其 CPU 官方源;不要把不同 CUDA 构建的结果混为本次环境。
sh
python -m venv .venv
. .venv/bin/activate
python -m pip install torch==2.6.0 --index-url https://download.pytorch.org/whl/cpu
python -m pip install -r requirements-cpu.txt
export OMP_NUM_THREADS=1
export MKL_NUM_THREADS=1
export OPENBLAS_NUM_THREADS=1
export MPLBACKEND=Agg
export MPLCONFIGDIR="$PWD/qa/author/mpl_cache"
python examples/tiny_pipeline.py
python examples/verify_mechanics.py
python examples/check_notebooks.py
python examples/make_figures.py
macOS 不应照抄上面的 Linux CPU 索引安装行。按 PyTorch 2.6.0 官方历史安装页 的 OSX 路径,可将该行替换为 python -m pip install torch==2.6.0,其余依赖另装;本书不需要 torchvision 或 torchaudio。是否有匹配的 wheel 还取决于 Mac 架构与 Python 版本,若提示无匹配版本,先核对官方支持条件。本书没有在 macOS 或 MPS 上实测,四个教学入口仍明确使用 CPU。
配套 ZIP 不包含 checkpoint、虚拟环境、缓存或 tiny_run 隔离运行目录;这些由运行脚本在本机创建。
本次真实环境是 Linux、Python 3.12.14、PyTorch 2.6.0+cpu、NumPy 2.3.5、Matplotlib 3.10.8、pandas 2.2.3、tiktoken 0.9.0,CPU 线程 1。版本约束用于复现记录,不声称这些版本对所有操作系统都是最合适的新安装选择。跨硬件、BLAS 或库版本时,不要求 loss 最末位与本文一致,应优先核对断言和误差范围。
15.2 四个完整程序各负责一件事
tiny_pipeline.py 从固定上游复制 train.py、model.py、sample.py、configurator.py 和 LICENSE 到隔离 qa/author/tiny_run,四份 Python 的执行副本哈希与源文件逐一相等。它生成 train/val 二进制及字符元数据,写小配置,然后用 subprocess 运行原 train.py。训练 seed 为原版的 1337,采样 seed 为 17,子进程限制 CPU 线程并禁用在线日志。脚本不会执行原数据下载器。
第一阶段 max_iters=20,checkpoint 在 step 20 保存;第二阶段从该文件恢复,设置 max_iters=25,确认保存编号变成 25、至少一个权重发生变化。然后两次独立启动 sample.py 并比较完整输出。只加载本次自身创建的 checkpoint,不接收任意文件路径作为反序列化入口。
verify_mechanics.py 检查参数计数、共享身份、优化器去重、因果性、SDPA/手工路径、整批/累积梯度、共享参数有限差分、上下文裁剪、非连续目标反例、学习率边界、窗口尾端、uint16 和配置解析反例。它用 AST 从可信 train.py 抽取 get_lr,而不是 import train.py 后意外启动训练。所有数学比较都记录实际误差。
check_notebooks.py 顺序执行两份 notebook 全部代码单元,单元级记录 stdout,保留原公式和表格。它只是复算历史 GPU 数字,不执行 GPU 训练。make_figures.py 绘制数据流、因果掩码、窗口错位、学习率、微型验证曲线和 DDP 计数图;图中 DDP 是解释图,不是性能记录。
所有入口都按 __file__ 找本书根目录,不依赖作者机器上的绝对路径。源码包保留这些完整文件,可打印附录由清单的 appendix=true 项生成;必要数据、原始大源码、图和日志分别列出,不把一份日志冒充另一份程序。
15.3 真实输出怎样支持结论
| 检查 | 结果 | 能支持什么 |
|---|---|---|
| 小模型参数计数 | 1864,全数;1816,扣位置 | 公式和实现计数一致 |
| 修改后缀后的前缀误差 | 0 | 测试输入下没有未来泄漏 |
| SDPA 对手工 attention | 最大差 | double、dropout=0 时数值一致 |
| 累积对整批梯度 | 最大差 | 等有效样本、无 dropout 的平均梯度一致 |
| 共享参数有限差分 | 误差 | 同时涵盖输入/输出路径的梯度正确 |
| 训练→恢复 checkpoint | 20→25 | 原版状态加载和继续更新通畅 |
| 同 seed 两次采样 | 完整 stdout 一致 | 本机同环境的这次抽样可复现 |
| 两份 notebook | 所有代码单元执行 | 公式可运行;不等于硬件历史重测 |
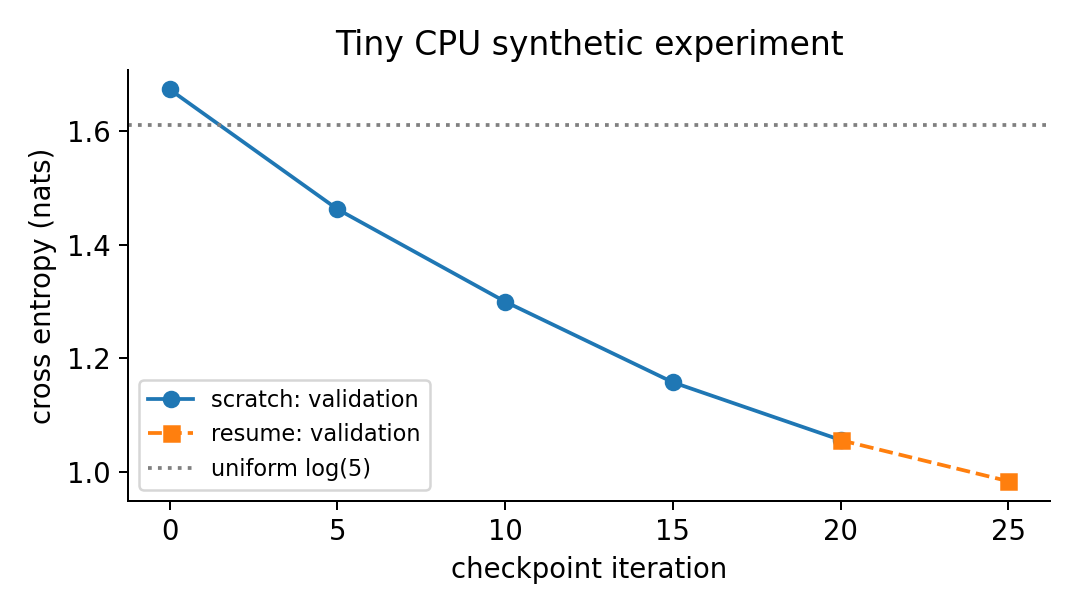
曲线的 step 20 有两个接近但不同的评估值,是恢复时重新抽样造成的。首次 train loss 从 1.6792 降到 1.0649,val 从 1.6728 降到 1.0560;恢复 step 25 的 train 为 1.0005,val 为 0.9835。时间日志保留供审计,但这里不把数毫秒的小模型循环转写为 GPU 性能承诺。
15.4 按失败发生的位置排查
| 现象 | 先核对什么 | 不要直接做什么 |
|---|---|---|
Unknown config key | 参数名是否由该入口定义 | 不要假定 train、sample、bench 开关相同 |
| 类型断言失败 | Python 字面值、大小写、原类型 | 不要把所有数字都加小数点 |
| randint 上界错误 | 文件 token 数是否大于窗口 | 不要只看文件存在 |
| embedding 越界 | dtype、最大编号、词表一致性 | 不要盲目扩词表掩盖读盘损坏 |
| targets.view 报错 | 裁切后连续性 | 不要怀疑所有权重都损坏 |
| 恢复模型形状不符 | model_args、词表、前缀清理 | 不要随意忽略缺失键 |
| 恢复后优化器形状不符 | 是否裁了位置表而没迁移状态 | 不要认为权重加载成功就足够 |
| loss 极低但生成很差 | 目标错位、因果泄漏、编码器 | 不要只增大模型 |
| 最后状态未保存 | 保存间隔、更新前保存、停止条件 | 不要把正常退出等同最终落盘 |
| 多卡挂起或断言 | A/W、rank、设备、collective 次序 | 不要立即改网络安全设置 |
排查时先复现最小失败,再分清数据、数学、状态与系统。第 6 章的非连续目标就是一例:原 loader 正常,自己切片后失败。用具体张量步幅解释,比泛泛“升级 PyTorch”更有效。
15.5 仓库外围文件也有工程含义
.gitignore 忽略 .DS_Store、IDE 目录、notebook checkpoint、Python 缓存、*.bin、*.pkl、*.pt、input.txt 以及 env/venv。它防止常见大数据和运行产物意外进入版本库,却不会自动备份这些文件,也不能保证敏感数据永不提交。复现实验应另行保存数据来源、哈希、配置和必要 checkpoint;Git 工作区干净不代表实验可重建。
.gitattributes 将 *.ipynb 标为 linguist-generated,只影响 GitHub 语言统计等展示判断,不代表 notebook 没有教学内容、更不代表它会自动生成或经过测试。本书因此仍逐单元审计。
assets/nanogpt.jpg 是 README 的展示图,assets/gpt2_124M_loss.png 是上游历史损失图。它们在覆盖清单中保留路径、哈希与用途,正文不直接复用未单独核验的图片权利,也不从像素反推出精确训练数值。本书图形来自原创绘制或 MIT notebook 公式重绘。
LICENSE 为 MIT,版权归属 Andrej Karpathy,完整副本在 research/UPSTREAM_LICENSE.txt。重分发上游实质性源码时保留版权及许可,正文的新解释、习题与图解不暗示得到上游作者认可。README 的安装、快速开始、GPT-2 复现、基线、微调、采样、效率、待办、排错、社区和致谢均在覆盖清单中映射到相应章节;社区入口和赞助致谢是项目背景,不是运行依赖。
15.6 能继续研究的边界
原 README 待办包括 FSDP、零样本评测、微调调参、动态 batch、其他位置编码、优化器状态分离和更多训练健康日志。它们解释了固定仓库尚未覆盖的方向,不是已经验证的功能。本书也没有完成 GPU AMP、fused AdamW、编译收益、NCCL、跨节点、GPT-2 权重导入或完整 OWT 训练。
下一步若有合适硬件,可以从一个清楚的问题开始:同一小模型的 GPU 前向是否与 CPU 在容差内一致?双卡全局 batch 是否与单卡累积一致?恢复运行保存哪些额外状态才能匹配连续运行?每次只扩大一个边界,记录实际证据,比直接启动几天训练后只留下一个 loss 数字更可控。
补充练习。 为“严格恢复”设计一个验收,而不改训练算法。
答案。 固定代码、硬件、数据及全部随机源,比较连续运行 K 步与先运行 J 步、保存完整状态、再恢复 K−J 步。逐步比较下一批数据、学习率、scaler、参数及优化器状态。若任何一项不同,先定位首次分叉点。原版 checkpoint 不满足完整状态要求,因此这应标为后续扩展实验,不能在本书现有恢复测试上直接打“严格复现通过”。
本章来源
- 固定 README 与完整文件树
- MIT LICENSE
- Git 忽略规则、Git 属性
- 本书完整结果:
qa/author/tiny_pipeline.json、mechanics.json、notebook_execution.json;逐项覆盖:research/author/coverage.json。