主题
第 10 章 单机多卡与跨节点 DDP 的状态约束
10.1 多张卡复制模型,分担的是数据
DDP 的基本思路是每个进程持有完整模型,用不同数据求局部梯度,再同步梯度,使各副本作相同更新。它并不把一个大模型的参数自动拆到多张卡上;如果单卡放不下模型和优化器状态,增加 DDP 卡数未必解决。固定 README 把 FSDP 列为未来工作,不能把它视为已经实现的能力。固定训练入口
脚本通过环境变量 RANK 判断是否进入 DDP。全局 RANK 标识全部进程中的编号,LOCAL_RANK 是当前节点上的编号,WORLD_SIZE 是进程总数。初始化进程组后,脚本把设备强制设为 cuda:LOCAL_RANK,选卡,令 rank 0 负责主要日志和保存。即使把 backend 改成 gloo,也不意味着这份 DDP 分支就成为 CPU DDP:它仍显式设置 CUDA 设备。本书未启动此路径。
10.2 配置里的累积次数先除以 world size
令命令行配置的累积次数为
train_gpt2.py 设置
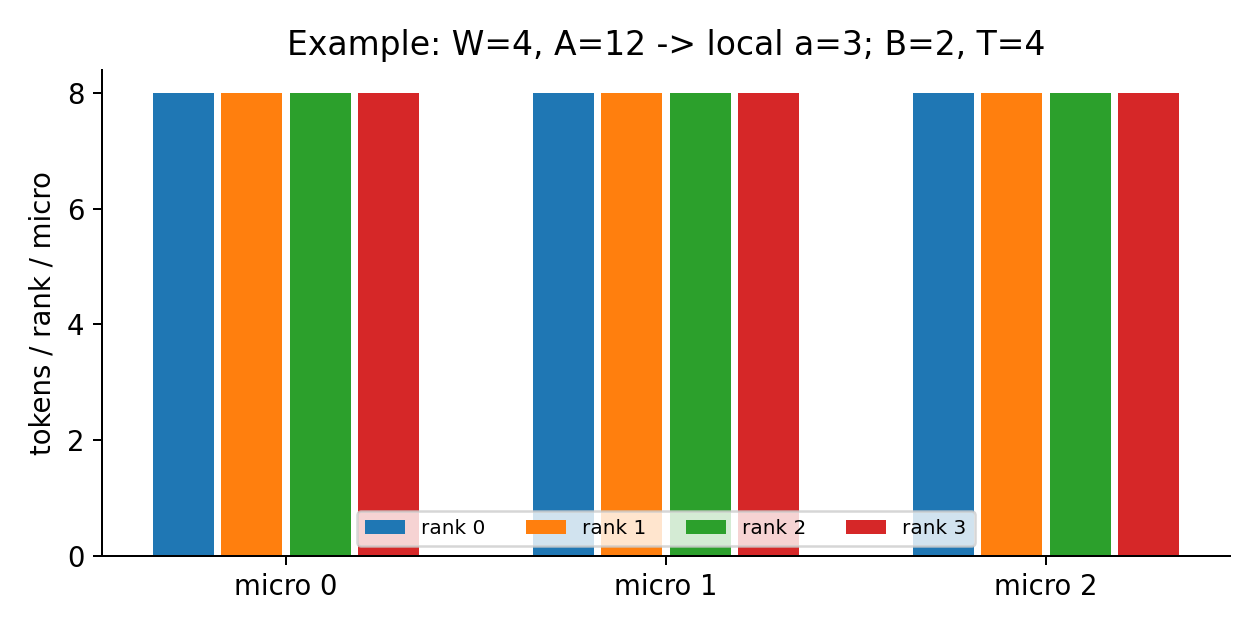
图示另一组小数值:
在各进程、各微批次有效 token 数相等时,DDP 平均梯度后得到
如果设备数改变而配置
10.3 seed 不同,权重为什么仍应相同
脚本使用 torch.manual_seed(1337 + rank)。不同 rank 会从不同随机状态生成初始化、数据和 dropout;之后创建 DDP 包装时会同步模型状态,使各进程从一致权重出发。数据抽样仍由各自 RNG 驱动,不存在显式 DistributedSampler,也没有保证不同 rank 永不抽到同一窗口。
rank 0 额外运行评估,消耗更多随机数,因此它与其他 rank 的抽样流还会进一步分开。不同数据流是需要的,但这不构成一个记录完整、可逐位恢复的数据调度器。复现实验要固定进程数、评估频率、软件和硬件环境,并保存必要状态。
10.4 为何只在最后一个微步同步
每次微步都进行梯度 all-reduce 会多次支付通信成本。源码将 model.require_backward_grad_sync 设为“是否最后一个微步”,之前只在本地累加,最后一次统一同步。官方通常推荐用 no_sync() 上下文;该仓库直接改属性,是作者为缩短代码选择的实现方式,不应推广为跨版本稳定扩展接口。
forward 也必须处于相应同步策略下,因为 DDP 在前向时会准备部分反向同步状态。原代码在 forward 之前设置属性,顺序不可随意后移。所有 rank 还必须执行相同数量、相容次序的训练同步操作;一个 rank 提前退出或抛异常,其他 rank 可能一直等通信。
rank 0 单独评估也值得审查:现代 SDPA 分支没有手工注意力 mask buffer,而旧手工分支存在注册 buffer。DDP 默认可能在 forward 广播 buffer;仅 rank 0 多做评估前向、其他 rank 进入训练,可能造成 collective 次序不匹配。这是由源码状态推得的兼容风险,本书未进行旧版多卡复现,不把它报告为所有运行必然死锁。设计更稳健的验证流程时,应明确让所有 rank 协同评估,或在受控同步边界使用合适的非 DDP 模型调用,并实际测试。
10.5 跨节点时,先核对进程数和通信条件
torchrun --nproc_per_node=8 --nnodes=2 表示每节点 8 个进程、共 16 个,不是“总共 8 张卡”。两个节点的 node_rank 不同,master 地址与端口应相同且可达。源码开头有“四卡”文字与八进程命令不一致的注释,计算应以具体参数为准。
默认
网络带宽、延迟、节点间可达性会影响训练;README 提到的 InfiniBand 与 NCCL_IB_DISABLE 是历史环境建议,不应未经诊断就一律关闭某种传输。先验证设备、进程组和最小通信,再测训练。所有 worker 使用同一数据、源码和模型配置,rank 0 可写输出目录;共享路径是否真实共享也要确认。
补充练习。 从 8 卡改到 16 卡,保留
答案。 需要
本章来源
- train.py:DDP 初始化、同步与销毁
- config/train_gpt2.py
- PyTorch DDP 官方接口
- 本章 DDP 行为为静态审计;没有 GPU、NCCL 或跨节点实测。