主题
第 9 章 学习率、验证、checkpoint 与恢复
9.1 逐段读学习率,而不是只说“余弦退火”
令 get_lr 的精确行为是
第一步不是 0。若
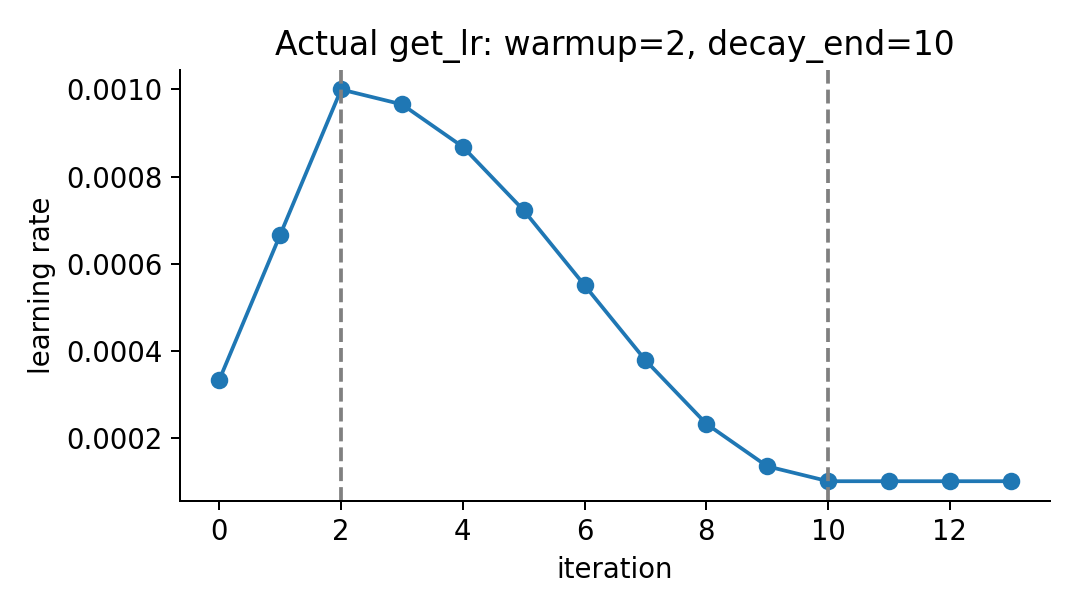
d=w 会使余弦分母为 0,本书已测试其 ZeroDivisionError;d<w 也不构成合理日程。decay_lr=False 直接使用固定学习率,不调用这段函数。max_iters 决定程序何时停,lr_decay_iters 决定学习率何时降到底,两者只是通常设为相近,不存在自动绑定。
9.2 验证估计了什么
estimate_loss 加了 @torch.no_grad(),暂时切到 eval,分别对 train、val 各取 eval_iters 个随机批次,把各批次 loss 存进向量后取平均,最后切回 train。关闭梯度节省图和内存,eval 关闭 dropout;两者是不同开关。
这是随机窗口平均损失估计,不是遍历验证文件中每个 token 一次的精确值。相邻窗口可以重叠,短文件也会重复抽样。增大 eval_iters 通常降低抽样波动,但增加耗时并消耗更多 RNG。指标下降很小的时候,需要判断差值是否超过抽样噪声;原脚本没有置信区间或多 seed 比较。
本书初次运行 step 20 的 val 为 1.0560,恢复后重新评估同一 checkpoint 的 step 20 为 1.0557。权重相同也能得到不同抽样估计,这正是上述机制的可见结果,不应伪造为逐步严格下降曲线。
9.3 保存时机、best 字段与最后一步
每轮先设置学习率,再按间隔验证和保存,然后训练更新。checkpoint 中 iter_num=20 表示保存时尚未执行编号 20 的更新。在从 0 开始的正常路径上,此刻已经完成编号 0 到 19 的 20 次更新。
保存条件是“验证改善,或者 always_save_checkpoint=True”。进入这个分支时,代码无条件把 best_val_loss 改成当前值。因此打开 always_save 时,这个字段其实是最近保存评估值,不保证是历史最优;关闭它才更接近名字所说的意义。另有 iter_num>0 限制,所以 step 0 不保存。
停止条件位于更新后:先 iter_num += 1,再判断 iter_num > max_iters。设 max_iters=20、从 0 开始,会实际执行编号 0 到 20,共 21 次更新。最后 checkpoint 若在更新前 step 20 保存,它不包含这最后一次更新。训练正常退出不意味着最后内存状态已经落盘。这是原版边界,若自行改为 >=,应同时明确你想让编号代表已完成步数还是当前索引。
eval_only 也不是无条件退出:源码只有 iter_num == 0 and eval_only 时 break。因此从迭代 20 的 checkpoint 恢复并设 eval_only=True,不会按直觉只评估一次,而可能继续训练。对预训练初始化的评估配置,iter_num 为 0,才符合原设计。
9.4 checkpoint 有什么,没有什么
| 保存字段 | 作用 | 不应推断出的能力 |
|---|---|---|
model | 参数及 buffer | 不包含 tokenizer 文件本体 |
optimizer | AdamW 统计量和参数组 | 不等于保存全部 AMP 状态 |
model_args | 重建结构 | 不允许任意修改层数仍兼容 |
iter_num | 恢复计数和日程位置 | 不说明最后一次内存更新已保存 |
best_val_loss | 保存判断参考 | always-save 时不保证历史最小 |
config | 部分原始配置快照 | 不是全部运行时状态 |
恢复时先从 checkpoint 覆盖层数、头数、宽度、block_size、bias、vocab_size,dropout 可使用本次配置。重新建模型、清除 state dict 键的 _orig_mod. 前缀,再载权重和优化器状态。原配置与新配置冲突时,要检查实际采用的是哪一方。加载优化器还会恢复它的参数组设置;随后学习率每步被日程重新赋值,但其他组字段不能假设必然使用命令行的新值。
checkpoint 未保存 Python、NumPy、CPU/CUDA RNG 状态、GradScaler 状态、数据抽样游标或已经预取的 X/Y。恢复又重新执行 seed 初始化和模型构造,随机状态与未中断路径不同。因此这是“恢复模型和优化器继续训练”,不是严格逐位续跑。若要后者,应设计完整状态协议,并用连续运行与中断运行的参数哈希比较检验,而不是仅看 loss 大致接上。保存与恢复代码
9.5 可信文件与版本边界
torch.load 和 pickle 元数据都有信任边界。本书只加载自身生成的文件;在 PyTorch 2.6.0 中,这个由张量和简单字典组成的 checkpoint 能通过默认加载,检查脚本还显式使用 weights_only=True。这不代表任意旧 checkpoint 都可安全加载。遇到安全加载错误时,不应把“设 weights_only=False”当成对陌生文件的通用修复。PyTorch 序列化说明
补充练习。 max_iters=7、eval_interval=5、从零开始,若始终保存,最后 checkpoint 的编号是什么?共更新几次?
答案。 step 0 不保存,step 5 保存;编号 0 到 7 共更新 8 次。最后 checkpoint 是更新编号 5 之前的状态,后续三次更新并未保存。解决方法可以是增加明确的退出前保存,但那是源码改动,需说明与原版的差异。
本章来源
- train.py 全部状态转移
- 本书恢复记录:
qa/author/tiny_pipeline.json、tiny_resume.log。 - 本书学习率边界:
qa/author/mechanics.json。