主题
第 4 章 把名字变成字符数据
现在给模型一批字符串,希望它继续生成风格相近的字符串。程序不必先理解名字的含义,只需回答一个局部问题:已经写到这个字符,下一个字符更可能是什么?把这个问题重复提出,就可以生成一个完整名字。
这种逐个预测再接回输入的方式叫自回归生成。本章先做最简单的 bigram 模型:预测下一个字符时,只看前一个字符。bigram 指由两个相邻元素组成的组合,这里两个元素都是字符。课程 bigram notebook
4.1 读文件后,先弄清记录代表什么
课程数据每行是一个名字,用 read().splitlines() 得到字符串列表。先查看若干条、总条数、最短和最长长度,再建立字符表。这几步是模型输入契约检查:有没有空行、大小写混杂、标点和没预料到的字符,都比晚一点的张量报错更容易在这里定位。
本书读取的 固定版本 names.txt 有 32,033 行,最短长度 2、最长 15,只含小写英文字母。按 “每个名字的字符数加一次结束预测” 统计,共 228,146 个训练对。唯一字符串有 29,494 个,因此这份文件存在重复名字。统计脚本的结果与文件 SHA-256 保存在 qa/part1/names_stats.json。
这个重复事实会影响后面的数据切分。随机按行切分可以复现课程的记录级任务,但同名字符串可能出现在训练和测试两边。如果评估目标是生成从未见过的名字,应按字符串分组后切分,而不是把记录级结果解释成严格的新名字泛化。本书主要运行的 40 条小样本是明确编写的测试数据,不是对真实人群命名习惯的抽样。
4.2 边界字符让长度也成为预测对象
只有 a→b、b→a 这样的内部转移,模型不知道何时开始,也不知道何时结束。对名字 aba,加上起止标记后得到
text
. a b a .对应四个训练对:.→a、a→b、b→a、a→.。长度为 3 的名字产生 4 个训练对。最后一对的标签是结束符,它同样要计入损失,否则模型没有停止学习信号。
课程最初使用 <S> 与 <E> 两个标记,随后改用同一个点号 .。在 bigram 中,起始符只需要作为当前字符,结束符只需要作为下一个字符,合并可以去掉无用行列。这里的点号是专用 token,不是字符串里真正出现的标点。若原始数据包含点号,应另外保留一个不会与普通字符混淆的 ID。
这种合并允许模型从起始符直接预测结束符,产生空串。训练数据若没有空名字,计数中这一格为零;后面加平滑后,它仍可能获得少量概率。是否允许空串,应作为生成规则的明确选择,而不是以为 “训练数据没有,所以绝不会生成”。
4.3 字符 ID 是地址,不是数值特征
排序后的不同字符构成词表,词表大小记为
python
chars = sorted(set(''.join(words)))
stoi = {char: i + 1 for i, char in enumerate(chars)}
stoi['.'] = 0
itos = {i: char for char, i in stoi.items()}
V = len(stoi)
stoi 是 string-to-index,itos 用于把结果解码回字符。排序保证同一字符集合在不同运行中有相同编号。课程数据的 .,a,b,d,n,v,所以
编号 2 比编号 1 大,不代表对应字符具有更强的某种属性。ID 仅用于查表。直接把整数当成一个连续输入特征,会人为引入编号之间的距离;第 6 章的神经网络版用 one-hot 或查表消除这个假设。
4.4 字典和矩阵记录的是同一件事
先用字典最容易确认逻辑:
python
counts = {}
for word in words:
    seq = ['.'] + list(word) + ['.']
    for left, right in zip(seq, seq[1:]):
        pair = (left, right)
        counts[pair] = counts.get(pair, 0) + 1
zip(seq,seq[1:]) 把原序列和错开一格的序列配对。长度
把字典改成形状
python
N = torch.zeros((V, V), dtype=torch.int64)
for left, right in pairs:
N[stoi[left], stoi[right]] += 1第一维是当前字符,第二维是下一字符。热力图里纵轴对应行,横轴对应列。imshow 后再在每格写出字符对和数字,能同时检查映射方向与计数逻辑。
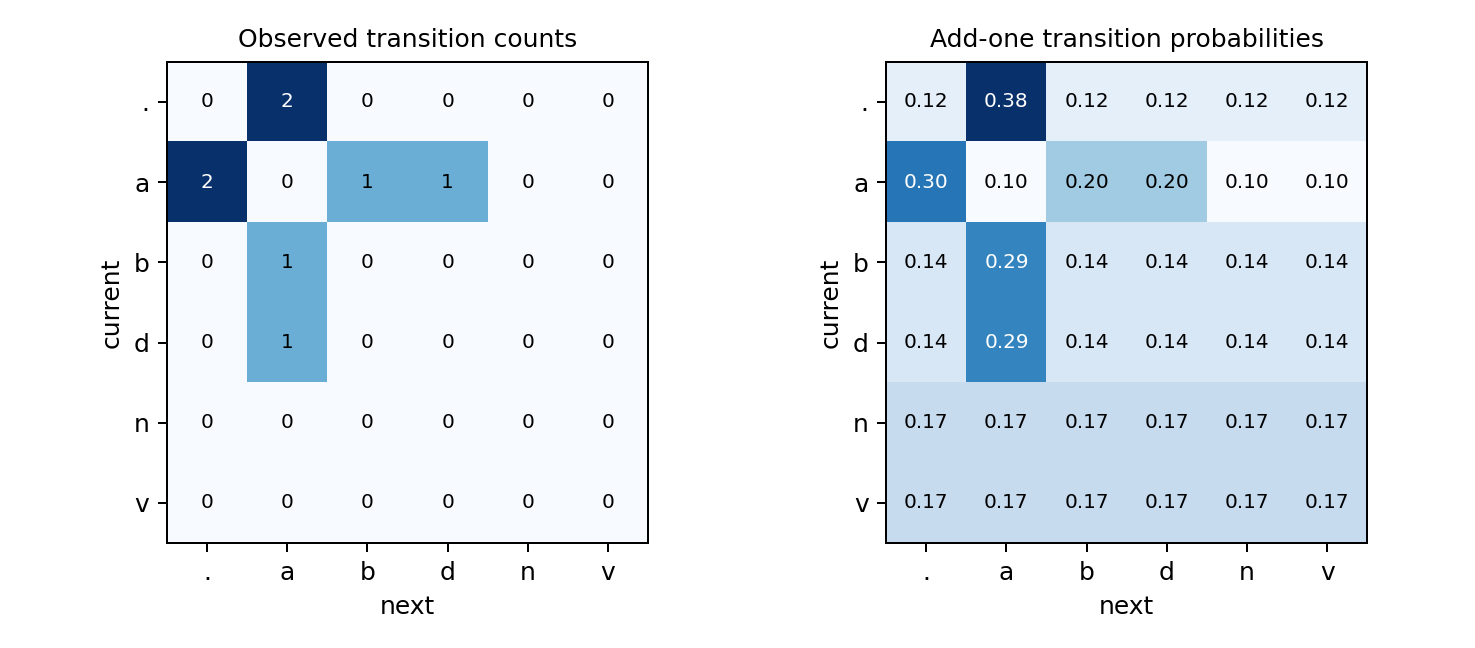
这张图使用 aba、ada 两个名字,但保持小实验完整的六字符词表。未出现的字符行全为零,后面需要平滑才能得到分布。左图全部计数之和应为
torch.Tensor 可以理解为带形状和数据类型的多维数组,但运算时还要关心设备与自动求导。本章计数用整数,后面概率用浮点数;标签和索引保持整数,不能因为 “神经网络都用浮点” 就把所有张量都转换。整数计数本身不需要梯度。
4.5 完整模型还差哪一步
计数表已经从数据提取了信息,但一行 [0,10,30,...] 仍不是概率。下一章会把每一行除以行和,得到 “给定当前字符,下一字符如何分配概率” 的表。它只能使用一个字符的历史,所以 ana 和 ava 后面的最后一个 a 在 bigram 看来完全一样。它无法根据更早的 n 或 v 改变下一步判断。
练习与解答
补充题:为 aba、ada 手写非零格。答案是 N[.,a]=2,N[a,b]=1,N[b,a]=1,N[a,d]=1,N[d,a]=1,N[a,.]=2。a 行和为 4,并不等于字符 a 作为名字中任意位置的计数以外的某种独立量;这里每个 a 都有一个后继,包括结束符。
补充题:删掉结束符会怎样?计数总数会从 8 变成 6,模型没有任何结束标签。给生成循环硬加长度上限可以防止无限执行,却没有修复概率模型。
官方 bigram E01 要把输入扩展成两个字符,预测第三个字符;先想清楚它需要多少行,再看第 9 章的完整答案。两个 ID
来源与运行
本章覆盖 bigram notebook 的文件探索、字典计数、排序、词表、整数矩阵、可视化和起止标记处理。数据读取与统计来自上述固定文件,并非引用 README 的样本说明代替核验。完整小实验见 examples/part1/language_lab.py 的 dataset、count_model,所有字符、样本和随机种子都在源文件中明确列出。