主题
第 21 章 模型看到的不是屏幕上的文字
前四章把字符直接编号,足以讲清 Transformer,但这套办法不方便处理开放世界的文本。新语言、新 emoji、代码、空格与控制字符不断出现。如果只给训练时见过的字符留编号,就会遇到未知字符;如果把所有 Unicode 码点都放进词表,词表又很大,而且许多位置很少训练。
实际 GPT 系列的 tokenizer 常从 UTF-8 字节出发,再把经常一起出现的字节段合成 token。本章先把文字的几层表示分开,第 22 章才开始学习合并规则。这部分对应《Let's build the GPT Tokenizer》的 Unicode、编码和 tokenizer 独立训练部分。官方课程;官方 minbpe 固定版本
21.1 可见字形、码点、字节和 token 是四件事
拿 中 做例子。它的 Unicode 码点是 U+4E2D,十进制为 20013。UTF-8 编码把它变成三个字节,十六进制为 E4 B8 AD,十进制为 [228,184,173]。如果 tokenizer 还没有学习任何合并,这三个字节就分别是三个 token;学到合并后,可能用一个 token 表示整个字,也可能仍分成几段。
python
text = '中'
print(ord(text))               # 20013
print(list(text.encode('utf-8'))) # [228, 184, 173]| 层次 | 回答的问题 | 示例 |
|---|---|---|
| 可见字形或字素簇 | 用户看见几个“字符”? | 一个带重音的字母可能由多个码点组成 |
| Unicode 码点 | 抽象文本元素的编号是什么? | 中 为 U+4E2D |
| UTF-8 字节 | 按什么规则存储或传输? | 中 为三个字节 |
| token ID | 特定词表将哪段字节映射到哪个编号? | 依 tokenizer 文件而定 |
Unicode 为字符和相关元素分配码点;UTF-8 是一种编码方式。UTF-16 使用 16 位代码单元,某些字符要用代理对;UTF-32 使用 32 位代码单元。它们不是三套不同语言词表。UTF-8 与 ASCII 在 0–127 范围兼容,常见英文字符因此通常占一个字节,但汉字和 emoji 常需要更多字节。Unicode 17.0 第 3 章:编码形式
Python len(s) 统计码点数,不直接等于字节数或用户感知字符数。对文本系统做长度限制时,先问自己限制的是哪一层。对语言模型而言,上下文预算最终落在 token 数上。
21.2 看起来相同,不保证字节相同
é 可以写成单一码点 U+00E9,也可以写成 e 后接组合重音 U+0301。它们的 UTF-8 字节分别是 c3 a9 和 65 cc 81。本书脚本真实检查了这两种形式,原始字节不同,因此未经归一化的 tokenizer 可以产生不同 token。
归一化是一种明确的文本变换,例如把某些等价表示统一起来;它不是无条件免费的清洗步骤。若任务要求逐字节还原原输入,归一化会改变这个目标。处理代码、密码式字符串、标识符或保真文本时尤其需要审慎决定,而不是看着“长得一样”就悄悄替换。
本书的 ByteBPE 不做 Unicode 归一化,输入必须是可以严格编码为 UTF-8 的 Python 字符串。孤立代理码点这类特殊 Python 字符串不属于我们声明的可逆输入范围。实际库可能有自己的修复策略,兼容测试要把策略写出来,不能只比较常见英文句子。
21.3 从 256 个字节开始,未知词的问题就变了
一个字节只有 256 种可能值。让基础词表包含全部 0–255,就能表示任意字节串,而不需要先见过其中的文字。对于良构 Unicode 文本,先严格 UTF-8 编码,再用字节 token 表示,总能找到基础编号。
代价是序列长。一个汉字可能先拆成三个 token;一段英文常用词也可能每个字母一个 token。Transformer 的普通全注意力需要构造随长度平方增长的注意力矩阵,长序列增加训练和推理成本。因此 byte-level BPE 的目标是在保留基础字节覆盖能力的同时,用额外词表项压缩常见片段。
这里的“压缩”首先指 token 数减少,不代表连同词表和元数据计算后的文件压缩率,也不保证得到最少 token 的切分。BPE 使用一种贪心合并规则,优先考虑训练数据中反复相邻的片段,不理解单词的语言学边界。
21.4 一个 token 的字节不必单独组成合法字符
这是最容易让 decode 写错的地方。假设三个 token 分别对应 E4、B8、AD,它们拼在一起才是合法 UTF-8 的 中。若对每个 token 单独 .decode('utf-8', errors='replace'),会得到三个替换符 ���。再拼接这些替换符,原来的字节已经丢失,无法恢复 中。
正确顺序是先取得所有 token 对应的字节片段,拼成一条完整 bytes,再解码:
python
raw = b''.join(vocab[token_id] for token_id in ids)
text = raw.decode('utf-8', errors='strict')
本书测试 check_bpe.py 实际展示了错误写法输出 ���,正确写法输出 中。如果任意采样产生的 token 序列最终不构成合法 UTF-8,strict 会报错;使用 replace 可以便于展示,但输出替换符意味着发生了信息损失。不要把宽松显示函数当作字节保真证明。
21.5 tokenizer 训练和语言模型训练是两个阶段
训练 tokenizer 时,输入是文本,学习结果主要是词表和合并规则。它不通过 Transformer 的交叉熵反向传播学习这些合并。训练语言模型时,tokenizer 通常已经固定,文本被转成 token ID,网络学习下一项分布。
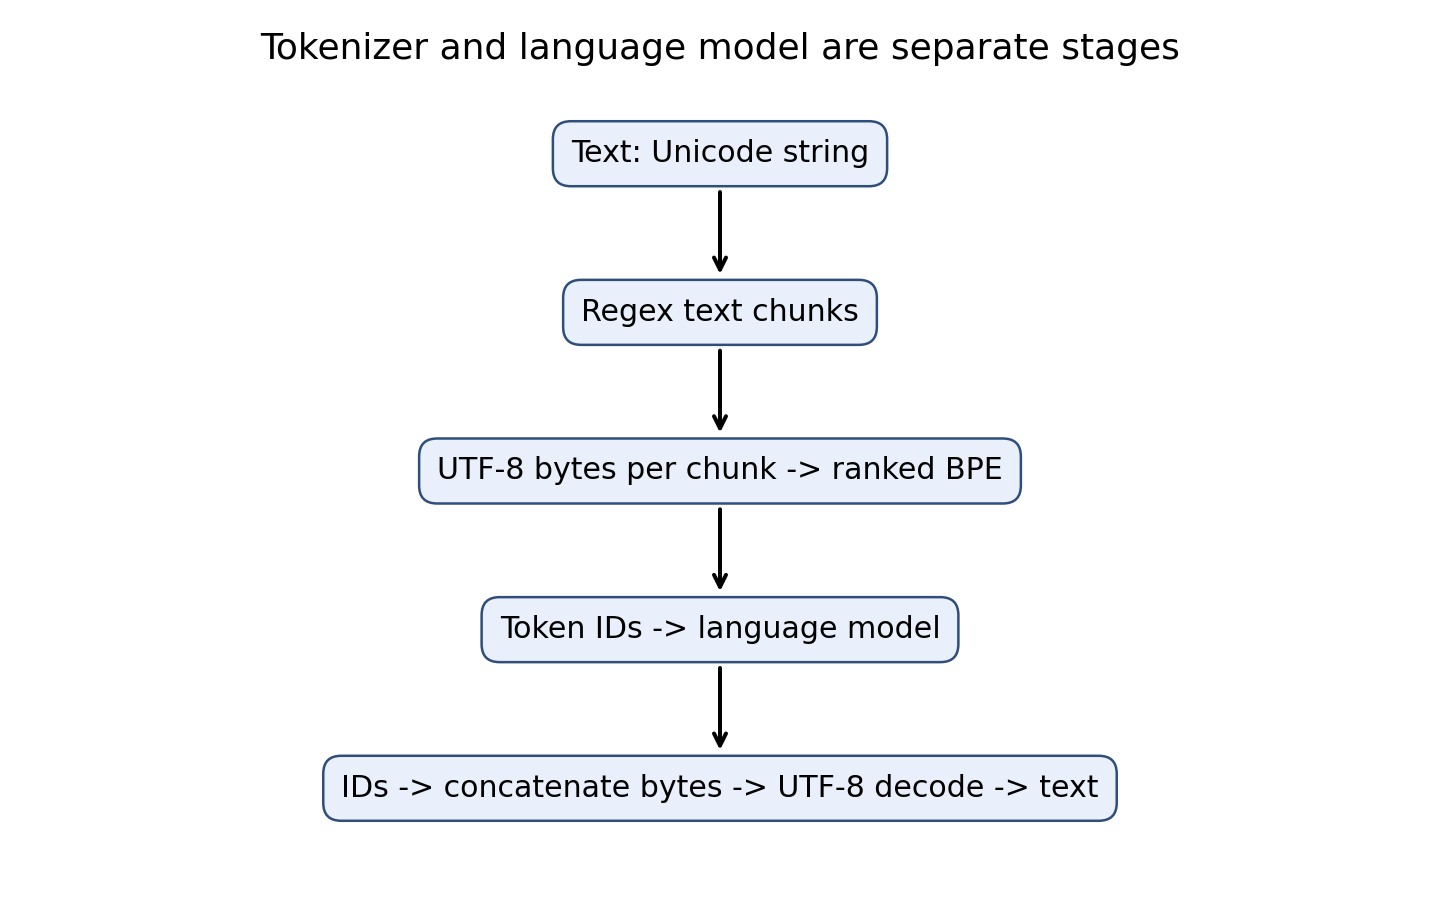
可以分别更换两个阶段的数据集,但二者应匹配预期语言与领域。一份对英文高效的 tokenizer 不保证对中文、代码或特定科学符号同样高效。若在模型训练后任意调换 token ID 对应关系,embedding 与输出层的语义会错位;网络不是只认“词表大小”,而是认每个编号在训练中的实际用途。
因此一个可复现的模型包至少要记录 tokenizer 名称或文件、版本、预处理方式和特殊 token 约定。只保存模型参数而忘了 tokenizer,像保存数据库数据却丢了字段定义。
练习与答案
- 补充题: “字节级 tokenizer 永远没有未知字符”需要什么限定?
- 补充题: 先把
é归一化再编码,decode 后能保证得到原始码点序列吗? - 补充题: 为什么一个 token ID 不能脱离词表解释为某个字?
答案。 第一题要求基础词表真的包含所有字节,输入编码策略明确,并且没有中途丢失字节;良构 Unicode 文本可先用 UTF-8 转换。特殊 token、错误输入和自定义过滤仍可能抛异常。第二题不能,归一化后的表示可能与原始表示不同;只能承诺还原规范化后的文本。第三题 ID 是词表里的地址,同一整数在不同 tokenizer 中可以表示完全不同的字节段,甚至是控制标记。
本章来源:除文中 Unicode 标准和课程链接外,编码/解码的实现边界可查 minbpe basic.py。本书没有复制原 notebook 引用的第三方 Unicode 长文,使用自编的中英文小例子替代。