主题
第 10 章 让信号穿过网络:从初始损失到权重尺度
一个程序能完成前向计算,也能调用 backward(),还不等于它适合训练。上一部分的字符 MLP 就会遇到这种情况:损失在下降,但开头一大段训练只是在修复随机初始化造成的坏状态。本章要学会在第一次更新前检查它。我们沿用“若干历史字符 → embedding → 隐藏层 → 下一字符”的任务,先处理输出过于自信,再处理隐藏层饱和。
本章对应课程第 4 讲的初始化部分。后面的数值实验由本书重新设计,使用小型随机张量,不把它们当作原课程姓名数据的成绩复现。固定版本 notebook
10.1 先把张量的角色摆清楚
设一个批次有
| 名称 | 形状 | 一个具体配置 | 含义 |
|---|---|---|---|
| 字符编号 | 整数索引,不能对它求普通连续梯度 | ||
| embedding 表 | 要学习的字符向量 | ||
| 查表结果 | 每个位置得到一个向量 | ||
| 拼接结果 | 把同一上下文排成一行 | ||
| 第一层权重 | 将上下文变成隐藏特征 | ||
| 激活前数值 | 将进入 tanh 的信号 | ||
| 隐藏激活 | 值在 −1 与 1 之间 | ||
| logits | 每个候选字符一个未归一化分数 |
这里使用 x @ W,所以权重的输入维度在前。PyTorch 原生 nn.Linear 的权重存为“输出维度 × 输入维度”,内部相当于 x @ weight.T。两种写法都正确,初始化时必须知道自己采用哪一种。PyTorch 2.6 初始化约定
10.2 还没学过,就不该对随机答案很有把握
模型刚开始时没有证据偏爱某个类别。把全部 logits 设成同一个数,softmax 就会给每个类别
27 个字符的参照值是
对比一个三分类样本。标签是第二类,logits 却是
课程把最后一层权重乘上较小系数、把输出偏置设成零,使初始分布更接近均匀。缩小最后一层,比把网络所有权重一起缩小更有针对性:前面的层仍需要保留区分输入的信号。也不要为了恰好得到
10.3 tanh 的输出有界,不代表计算稳定
tanh 把任何实数压进
当
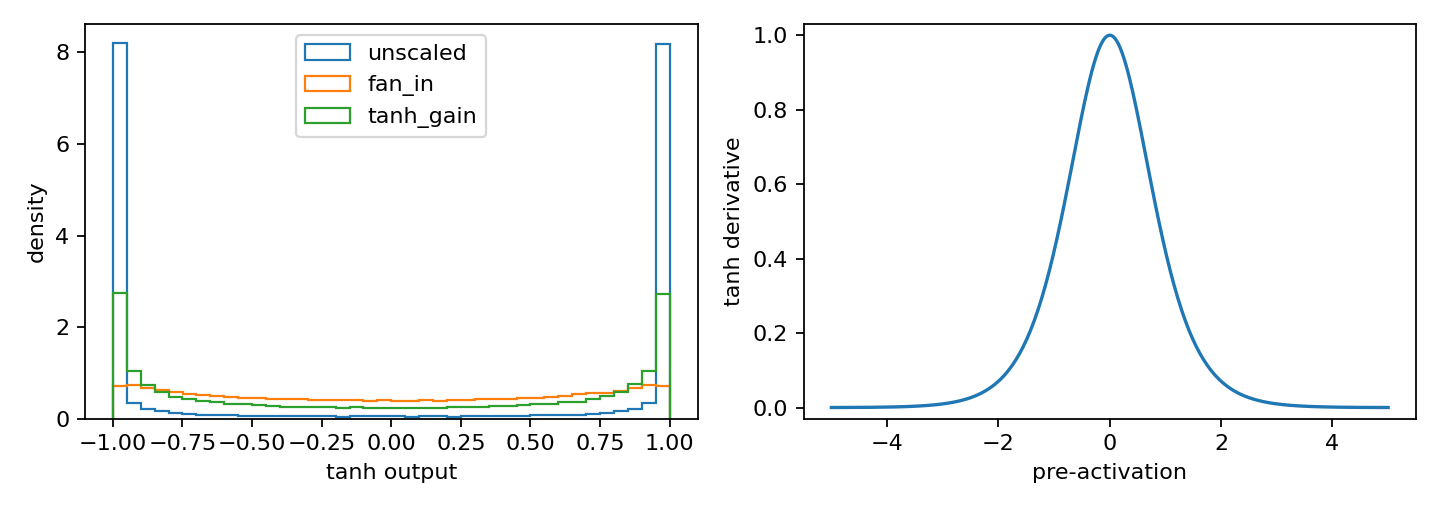
图左固定输入与基础权重,只改变权重的乘数;图右显示为什么两端堆积值得警惕。完整实验在 examples/part2/experiments.py 的 scaling() 中。它生成
| 权重缩放 | 激活前标准差 | tanh 标准差 | 绝对值超过 0.97 的比例 |
|---|---|---|---|
| 不缩放 | 8.10476 | 0.94940 | 79.47% |
| 除以 | 1.01309 | 0.62970 | 3.97% |
| 再乘 tanh gain | 1.68849 | 0.76044 | 21.28% |
第三行的饱和比例比第二行高,并不与初始化建议矛盾。初始化需要在“传得太弱”和“压到两端”之间取得合适尺度;某一层饱和比例最低,不保证一个深网络的信号传播最好。第 12 章会沿深度看它们的变化。
10.4 为什么除以输入宽度的平方根
先忽略偏置。一个输出分量是 fan_in,即参与这个输出求和的输入个数。假设各项相互独立,输入与权重也独立,均值为零,输入方差为
因此,若想让线性层前后的方差大致相当,可令
这是一个基于独立性和分布假设的估算。训练后,输入会相关,权重也不再是独立随机数,不能把它当作永久保证。非线性还会改变方差:ReLU 会截去负半边,tanh 会压缩大数。因此初始化常加入一个与非线性相关的增益 gain。PyTorch 的建议值包括线性层的 1、tanh 的
python
W1 = torch.randn(fan_in, fan_out) * (5/3) / fan_in**0.5称它为半原则化的 Kaiming 风格初始化较妥当:fan_in 缩放有方差推导,tanh 的
如果直接调用库函数初始化本章方向的 W.T,使库能正确识别 fan-in;手动除以 fan_in**0.5 则没有这个转置约定问题。
10.5 全零初始化为什么还能下降一点
这是第 4 讲的官方练习 E01。考虑没有 BatchNorm 的两层网络:
把两组权重和两组偏置全设为零。隐藏激活
本书用四个样本,其中三项标签为 0、一项为 1,训练这个全零网络。初始损失为 0.693147,100 次更新后的检查值为 0.562335,输出概率约为
若加入 BatchNorm,务必区分普通线性偏置与归一化的 beta,也不要把所有状态混成“权重”。running_var 通常从 1 开始,gamma 通常从 1 开始,稳定项 eps 必须保留。E01 的目的在于追踪哪些路径有梯度,而不是把无稳定项的零方差除法误当成对称性实验。
10.6 动手检查与答案
- 官方 E01,扩展检查。 在完整代码的
zero_init()中把标签改成[0,0,1,1],用全批次训练。先预测哪个参数能动,再运行。 - 补充。 对一个
的自定义权重,用 x @ W做前向,fan-in 是 20 还是 80?若误用后者,初始标准差缩小多少? - 补充。 最后一层权重若恰好为零,而隐藏层随机初始化,第一次反传能否更新隐藏层?第二次呢?
答案与检查方法:第一题所有梯度都为零,输出维持均匀;用每个参数梯度的最大绝对值验证,别只看四位小数的 loss。第二题是 20,错误缩放使标准差成为正确值的 dh=0,但 dW2=h.T @ dZ 通常不为零;更新后
本章运行:在书的根目录执行 .venv/bin/python examples/part2/experiments.py,查看输出中的 scaling 与 zero_init。完整日志保存在 qa/part2/experiments.json。初始化检查通过后,我们仍不能保证训练期间尺度不漂移;下一章处理的正是这个问题。
来源与范围
- 第 4 讲官方视频及练习描述:初始损失、tanh 饱和、初始化尺度与 E01。
- 固定版本源码:单元 0–8、11 中的前半实验。
- PyTorch 2.6 初始化文档:gain 与权重方向约定。
- He 等,2015:初始化原论文。本章数值例子与推导独立编写,不转录视频。代码改编许可见
examples/part2/NOTICE.txt。