主题
第 25 章 从小 GPT 到 GPT-2:先把模型对上,再谈训练
上一部分已经把字符模型变成了 Transformer。现在的问题更具体:如果别人交给你一份 GPT-2 的参数文件,你写的程序能否接住它,并算出同样的预测?这比“网络层数差不多”严格得多。模块名称、矩阵方向、归一化位置、激活函数和词表都得一致。一个模型可以顺利运行,也可以正常降低损失,却仍然不是你想复现的那个模型。
本章开始对应 Karpathy 的 GPT-2(124M)复现课。第 25—28 章以仓库 build-nanogpt 的固定版本 6104ab1 为代码依据,结合视频官方章节表组织内容。视频逐字字幕未取得,因此不能声称逐句覆盖;代码和 31 个官方章节主题的对应关系列在配套覆盖表。本书的 CPU 实验另写了微型模型,没有下载或运行 124M 预训练权重。
25.1 “124M”究竟描述什么
GPT-2 小模型有 12 个 Transformer 块,每个块的隐藏宽度是 768,分成 12 个注意力头,因此每头宽度为 64。上下文窗口是 1024 个 token。原权重的词表大小为 50257。这里的 token 不是汉字数或英文单词数,而是由特定 tokenizer 划分出的符号编号;换 tokenizer,即使词表大小碰巧相同,编号的意义也可能完全不同。配置依据:固定版 train_gpt2.py。
先约定形状。B 是一次送入网络的序列条数,T 是每条序列的长度,C 是隐藏宽度,V 是词表大小,H 是注意力头数,D=C/H 是每头宽度。输入 idx 的形状是 B×T,每个元素是 0 到 V−1 的整数。词嵌入表 E 的形状为 V×C,位置嵌入表 P 的形状为 1024×C。第 b 条序列第 t 个位置的初始向量为
两个查表结果都得到长度为 C 的向量,可以直接相加。位置表的同一行会广播到批中的所有序列。这里使用可学习的绝对位置嵌入,不能悄悄替换成别的位置编码,再指望原权重照常工作。
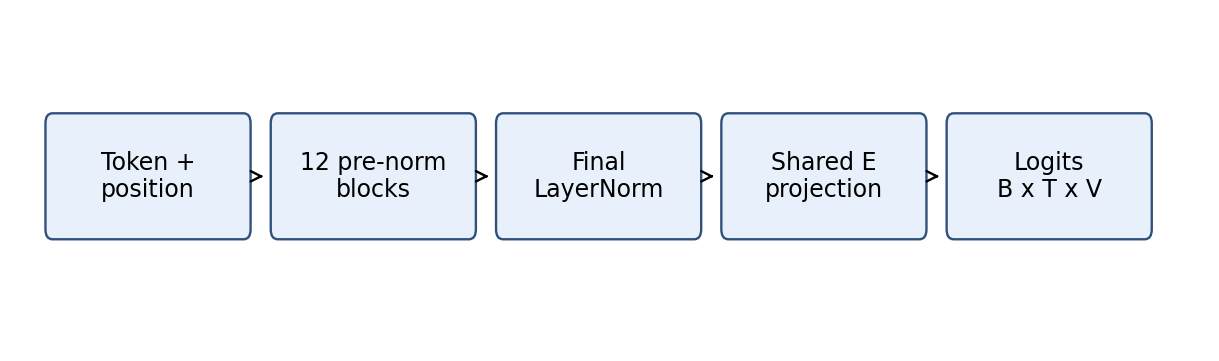
一个块有两次残差相加:
LN 是 LayerNorm,沿最后的 C 个通道归一化,每个位置独立计算。归一化发生在子层之前,这叫 pre-norm。12 个块之后还要经过 ln_f,才进入输出头。若把它改成“子层之后归一化”,形状不会报警,但函数已经变了。
先观察一份权重文件,但不要过度解释图案
上游 play.ipynb 的前六个单元做了一个实用的探索:导入 Hugging Face 模型,列出 state_dict 的名称和形状,查看位置嵌入的少量数值,再把整个位置矩阵、若干通道随位置变化的曲线,以及一小块注意力投影权重画出来。位置矩阵的行是位置,列是通道;取 [:,150] 才是在看第 150 个通道跨位置如何变化,而不是在看第 150 个 token。
这种图能帮助检查矩阵大小、数值范围和可见结构,却不能仅凭某条曲线就断言一个通道表示某种语义。注意力投影权重的局部灰度图也不是输入相关的注意力概率图:前者是固定参数,后者要对具体输入计算 QKᵀ、遮罩和 softmax 才得到。本书没有下载实际权重,因此不伪造这些图或其数值;配套微型图只说明架构,二者用途不同。
25.2 把多头注意力压进一次矩阵乘法
旧版教学模型往往给每个头单独写三个线性层。固定版 GPT-2 代码把它们合并:c_attn 将 B×T×C 一次投影成 B×T×3C,然后沿最后一维切成 Q、K、V 三份。这里的 V 是 value 张量;为免与词表大小混淆,下面把 value 写成 U。
每份先变成 B×T×H×D,再交换 T、H 两维,得到 B×H×T×D。交换不是装饰。注意力要为每个头独立计算 T×T 的相关程度,所以 H 必须在矩阵的批次维上。每头的注意力计算是
其中 s 是被读取的位置,M 在 s>t 时为负无穷,其余为零。随后计算 Y=AU。把各头结果交换回 B×T×H×D,连续存储后合并为 B×T×C,再用 c_proj 混合不同头的信息。PyTorch 的 transpose 通常只改变视图的步长;接着调用 contiguous 再 view,是为了让合并后的内存排列符合预期。
举个极小例子:B=2、T=5、C=8、H=2,则 D=4。c_attn 的输出是 2×5×24;切片后每份为 2×5×8;拆头后为 2×2×5×4;相关矩阵为 2×2×5×5。最后一维的 softmax 表示“当前这个位置从哪些已有位置取信息”,不是在通道之间分配权重。
代码使用 scaled_dot_product_attention,并传入 is_causal=True。第 26 章会检查它与手写版本的前向和梯度是否相同。这里先记住:API 名叫 SDPA,不意味着每次都会调用 FlashAttention;实际后端还取决于设备、数据类型和输入条件。PyTorch 2.6 SDPA 文档。
25.3 MLP 没有处理相邻位置,却仍然很重要
MLP 对每个位置分别做 C→4C→C 的变换。对 GPT-2 小模型就是 768→3072→768。中间使用 tanh 近似的 GELU:
a 是一个标量,公式逐元素作用于张量。它让不同大小、不同符号的输入得到平滑的非线性处理。若去掉激活函数,两次线性变换可以合成一次,宽到 4C 的中间层就失去了这一层非线性表达能力。注意力把其他位置的信息送到当前位置,MLP 则根据已有信息做通道内的转换;两者承担不同工作。
复现时需要保留近似方式。精确 GELU 与 tanh 近似很接近,却不完全相同。短序列上“肉眼看起来一样”的文本,也不等于 logits 在数值上完全吻合。实现中的 GELU 与模块位置。
25.4 一份权重为什么会出现两次
输入时,我们从 E 里按 token 编号取出一行。输出时,对于隐藏向量 h∈ℝ^C,词表中的第 j 个 logit 是
因此输出头可以直接使用同一张 E,而不再维护独立的 V×C 权重。这叫 weight tying,权重共享。PyTorch 的关键语句是让两个模块指向同一个 Parameter:
python
self.head.weight = self.wte.weight这与把数值复制一次不同。copy_ 或 clone 只能保证某一刻数值相等,下一次更新后,两份独立参数就可以分开。共享参数的梯度会把所有使用路径的贡献相加:输入查表路径产生一部分梯度,输出分类路径产生另一部分,最终共同更新 E。同一份参数也只能在优化器里注册一次,否则可能被重复更新。
来算一下参数量。一个块中,注意力的四个投影合计 4C²+4C 个参数;MLP 合计 8C²+5C;两层 LayerNorm 合计 4C。所以一个块为 12C²+13C。模型还有 VC 个 token embedding 参数、1024C 个位置参数和最终 LayerNorm 的 2C 个参数。共享输出头不再另加 VC。因此
代入 V=50257、C=768,得到 124439808,约 1.244 亿。如果独立添加输出头,会多出 38597376 个参数。这个计算也解释了为什么只看模块打印结果容易误判:state_dict 可以出现两条指向同一底层权重的名称,而统计唯一 Parameter 才是实际可训练参数总量。
本书微型模型用 V=17、C=16、T 上限 12、2 个块,实际唯一参数为 7056。实验检查了对象身份和存储地址,两者都确认共享;同时构造数值相同的独立参数,验证其地址不同。完整代码在 lab.py,实际输出在 results.json。
25.5 导入权重时,矩阵的名字相同还不够
原 GPT-2 相关实现把某些投影叫 Conv1D,但这里并不是沿序列做卷积。关键区别在于权重存储方向。设输入 X 为 B×C_in,源实现保存 W 为 C_in×C_out,计算 XW;PyTorch Linear 保存的是 C_out×C_in,计算 XW_linearᵀ。因此应该令 W_linear=Wᵀ。
固定版导入函数只对四类后缀转置:attn.c_attn.weight、attn.c_proj.weight、mlp.c_fc.weight、mlp.c_proj.weight。Embedding、LayerNorm 和偏置不应该一律转置。对方存储的因果掩码等 buffer 也不是待学习参数,要先从比较键列表里过滤。
导入检查最好分三层。先检查预期名称集合,再检查每个张量的形状,最后在固定输入上比较 logits。仅检查键数量不充分:两个不同的键集合可能拥有相同数量。课程固定代码检查数量并在逐键访问时检查形状;写自己的加载器时,可以进一步显式比较键集合,给出更容易定位的报错。
对于方阵,错误转置尤其隐蔽。C×C 转置后形状仍然是 C×C,形状断言根本发现不了。应该构造一个不对称矩阵,让 XW 与 XWᵀ产生不同结果。本书实验验证 XW 与 F.linear(X,W.T) 的最大误差为 0;这只验证存储方向的代数关系,没有执行真实 Hugging Face 权重导入。
25.6 初始化不能只说“随机一点”
随机初始化决定训练开始时信号和梯度的尺度。固定代码给 Linear 和 Embedding 的权重使用标准差 0.02 的正态分布,线性层偏置置零。对每个残差分支最后的投影,再把标准差乘以 (2L)^−1/2,L 是块数。GPT-2 小模型有 12 个块,每块两个残差分支,所以系数为 1/√24。
可以用一个粗略方差模型理解这个选择。假设每个分支加入均值为零、互相独立、方差为 σ² 的增量,连续加上 2L 个分支后,增量方差约为 2Lσ²。把每份增量尺度缩小到原来的 1/√(2L),总方差就不会仅因分支数增加而线性膨胀。上游 notebook 也用连续相加 100 份随机向量来观察标准差。本书补做了固定种子的 float64 CPU 实验:768 维向量相加后的样本标准差为 9.428062,每份先除以 √100 后为 0.942806。比例为 10,接近单位量级的结果来自抽样,不要求恰好等于 1。真实网络的分支并不独立,这不是严格证明,更不是所有架构通用的最佳初始化;它解释的是这个缩放因子的动机。
共享权重还带来一个细节:用 apply 遍历模块初始化时,同一个共享参数可能因两个模块入口而被写入两次。最终仍是同一份参数,但随机数消耗顺序会变化。因此,即使使用相同种子,不同构造顺序也可能产生不同初值。种子是复现实验的一部分,不能代替代码版本和初始化顺序。
25.7 先让一个批次被记住
在昂贵训练之前,课程先把同一个批次反复送入模型。若损失连这个批次都降不下来,问题通常不在数据规模不足,而在标签对齐、梯度流、优化器或模型实现。这个检查要求模型有足够容量、学习率合理,但不要求它泛化。
输入 token 流为 0、1、2、3、4 时,可以取 x=[0,1,2,3]、y=[1,2,3,4]。网络输出每个位置对下一个 token 的分布。logits 的形状 B×T×V 被展平为 BT×V,标签展平为 BT。交叉熵按 BT 个位置求平均。不能把标签再左移一次,否则模型学到的是跨两个位置的预测。
设备选择也要区分两个概念。device 可以是 cuda:3,表示具体设备;autocast 的 device_type 应是 cuda,表示设备种类。固定脚本优先 CUDA,其次 MPS,最后 CPU;但它把非 CUDA 的 device_type 统一设为 cpu,README 对 MPS 路径也保留疑问。因此本书不声称该脚本在 Apple Silicon 上已经兼容验证。
采样则只取最后一个位置的 logits,转换为概率后选择下一个 token,追加到输入再循环。top-k=50 是课程采样设置:只保留概率最高的 50 个候选,然后按它们的相对概率抽样。multinomial 接受非负、总和大于零的权重,不要求传入的权重已经归一化。play.ipynb 还把高层 text-generation pipeline 与手工循环并列比较,设置种子 42、生成 5 条总长度上限 30 的序列。相同种子只有在随机数消费顺序、采样选项与实现都相同时才有逐位复现意义;不能据此保证不同版本 pipeline 与手工代码文本完全一致。它随后读取 Tiny Shakespeare 的前 1000 个字符,编码后取 25 个 token,构造 4×6 的输入与移位标签,这是本书批次例子的课程来源。
采样是查看模型行为的补充,不能取代验证损失;第 28 章会解释为什么有趣的句子不是可靠指标。
练习与答案
以下为本书补充练习。
- 一个模型的隐藏宽度为 24、头数为 6,QKᵀ 的形状是什么?设输入 B=3、T=10。
- 为什么把 head.weight.copy_(wte.weight) 换成共享赋值后,唯一参数数目会变化?
- 你有一个 C×C 的导入权重,形状检查通过了,如何设计测试来发现漏转置?
- 删除 ln_f 后损失仍会下降,是否能称为 GPT-2 权重兼容模型?
答案:第 1 题每头宽度为 4,相关矩阵为 3×6×10×10。第 2 题复制仍有两份 Parameter,共享赋值让两个入口指向一份参数。第 3 题使用不对称权重和非特殊输入,比较源算式 XW 与目标 F.linear(X,W.T),并比较完整模型固定输入 logits。第 4 题不能;可训练与架构、权重兼容是不同检验。
下一章保留这个函数不变,检查如何减少运行它的成本。先证明算对,再测算快,这个顺序能省掉很多没有意义的性能调试。
本章来源与验证边界
- GPT-2 复现课:官方章节主题。
- 固定 train_gpt2.py:架构、参数导入、初始化、共享与采样。
- PyTorch 2.6 SDPA:注意力接口。
- 本书 CPU 实验:微型共享参数、转置代数关系与模型训练检查。
本章没有加载真实 GPT-2 权重,没有执行完整 checkpoint 对齐验证。