主题
第 28 章 数据、评估和恢复:什么才算复现了一次训练
模型结构相同,不代表训练实验相同。把原始网页换成另一个语料库、训练不同数量的 token、用不同方式切分验证集,都会改变结论。复现 GPT-2 的教学价值,在于把这些选择摊开,而不是只得到一个文件名里带 GPT-2 的权重。
本章把课程最后一部分拆成一条可核对的路径:文本如何进入分片,分片如何变成输入和标签,损失如何汇总,模型如何接受独立评估,以及中断后能恢复到什么程度。数据处理以固定版本的 fineweb.py、train_gpt2.py 和 hellaswag.py 为依据。本书没有执行下载大语料的脚本。
28.1 先把“GPT-2 复现”说准确
原 GPT-2 论文使用 WebText。课程采用 FineWeb-Edu 的 sample-10BT 数据配置,并参考 GPT-2、GPT-3 的模型与训练设置。因此它是在新的公开数据和工程实现上复现相近规模的自回归语言模型训练,不是逐字节重建原 GPT-2 的全部训练材料与权重。
这一区分很实际。如果新模型在某个指标上接近旧模型,可以报告在明确评估设置下的结果;不能直接推断两个模型拥有相同知识、相同偏差或相同训练经历。课程视频展示的训练结果和样本属于讲者的运行,本书的 tiny GPT 则是另一组缩小实验。下面出现的 CPU 数字不会被冠以“124M 复现结果”。
官方资料可分别查看 GPT-2 论文、GPT-3 论文 与 FineWeb-Edu 数据卡。涉及新下载时,应重新核对数据版本、许可和存储需求;本书固定的是教学代码,不是假定数据托管服务永不变化。
28.2 从文档到磁盘分片
fineweb.py 对每份文档先加入一个文档边界 token,再用 GPT-2 tokenizer 的 encode_ordinary 编码正文。普通文本编码不会把正文中恰好出现的特殊 token 字符串自动当成控制符;边界 token 是程序显式加入的。把文档拼成连续 token 流,可以充分利用定长训练块。
GPT-2 的 token 编号小于 65536,因此脚本使用 uint16 存储,每个 token 两字节。一个 1 亿 token 分片仅编号数组就约 2 亿字节,尚未计文件头、原始数据和缓存。若换成更大词表,必须重新检查编号范围;超界后直接转 uint16 会破坏数据。代码中的范围断言是在防止这种静默损坏。
脚本按 1 亿 token 写分片,第 0 片标记为 val,其余标记为 train,最后一片可能较短。使用多进程池做 tokenization,imap 按输入顺序返回结果;这一点有助于让分片顺序可解释,但实际数据集版本和输入顺序仍须记录。
教学实现为了简单,允许一篇文档跨越两个分片边界。如果刚好跨越第 0 片与第 1 片,同一文档的不同部分会同时出现在验证流与训练流。它不是逐文档随机划分,也不能据此声称没有文档级泄漏。更严格的实验应先按文档划分,必要时还要去重,再分别编码与分片。本书在这里提出改进理由,没有重新构建或检验 FineWeb-Edu 全部数据。
还有一个实现前提:分片代码主要处理“当前文档剩余内容能放入下一个分片”的情况,并没有用任意多次循环处理一个超过分片大小很多的文档。1 亿 token 的分片使这个问题在普通文档中很少出现,但可靠的通用分片器不应依赖“应该不会那么长”。测试时应刻意构造超长文档与恰好填满分片的边界。
28.3 B×T+1 个 token 如何变成一批训练样本
要得到 B×T 个输入和同样数量的下一个 token 标签,需要从连续流里取 B×T+1 个 token。设 B=2、T=3,缓冲区为 [0,1,2,3,4,5,6],则
text
x = [[0,1,2],
     [3,4,5]]
y = [[1,2,3],
     [4,5,6]]
每一行都有自己的因果注意力窗口,不能读到上一行的隐藏状态。因此 token 3 虽然在连续流中紧接 token 2,在第二行中仍作为一个新窗口的起点。标签重叠并不是输入泄漏:第一行最后位置预测 3,第二行使用 3 作为已知输入预测 4,这正是相邻预测任务应有的关系。
有 R 个进程时,第 r 个进程初始位置为 BTr,每次向前移动 BTR。B=2、T=3、R=2 时,rank 0 读取输入 0…5,rank 1 读取 6…11;下一次分别从 12 和 18 开始。两者的输入区间不重叠,但一个区间的末尾标签可能等于下一个区间的首个输入。实际 CPU 测试把两批 x、y 和下一位置完整写入 results.json。
固定加载器读取 NumPy 分片,先把 uint16 转成 int32,再构造成 torch.long,这是仓库对旧版 PyTorch 类型转换兼容性所作的勘误。训练时 embedding 和交叉熵需要正确的整数编号,不能为了节省内存把标签当浮点数直接送进去。
分片末尾不足以读取下一批时,加载器切到下一片,最后一片结束后循环到第一片。它为分布式步幅保留余量,会舍弃部分尾部 token;小分片尤其要注意这个比例。正式计量“训练了多少 token”时,应区分优化器实际处理数量与磁盘数据名义总量,不能仅用文件名里的 10B 当作精确消费量。
28.4 验证损失应该保持一个稳定的问题
验证时 model.eval() 关闭依赖训练模式的行为,torch.no_grad() 避免保存反向图,两者解决不同问题。eval 并不会自动禁止梯度,no_grad 也不会自动切换 dropout 等模块状态。
课程每隔 250 个步骤及最后一步做验证,重置验证加载器,再读取 20 个批次。这样每次比较的是相同的起始窗口,有利于观察趋势。它没有遍历整个验证语料;因此报告应写“固定验证批次平均损失”,而不是暗示完整数据集精确均值。不同 world size 会改变这 20 次读取覆盖的全局 token 数,跨运行比较时也要记录。
若各批次含同样数量的有效 token,把 20 个均值再平均是正确的。变长批次或 mask 后 token 数不同,就需要按 token 数加权,理由与梯度累积相同。记录 nll_sum 与 valid_token_count,再求总和之比,比依赖“这里每批应该一样大”更稳健。
若自然对数交叉熵为 L,困惑度定义为 exp(L)。它把平均对数损失换成另一个尺度,但仍依赖 tokenizer、数据处理和评估文本。两个模型若使用不同 tokenizer,直接比较每 token 困惑度可能没有共同单位。换一个 tokenizer 把同一段文字拆成更多 token,任务的计数单位已经改变。
28.5 HellaSwag 问的是另一件事
HellaSwag 提供一个上下文和四个候选续写,要求选出合理的续写。课程不把它改成聊天式问答,而是用基础语言模型为每个候选计算条件损失。这个测试补充了“模型是否能预测一般文本”,但不能概括全部语言能力或安全表现。HellaSwag 原论文。
假设上下文 token 为
固定实现先把 logits 去掉最后一列位置,把 tokens 去掉第一个位置,使两者对齐。mask 标记的是“哪些目标 token 属于续写”,所以也应使用 mask[...,1:]。之后对未屏蔽位置的负对数概率求和,再除以续写 token 数,选择均值最小的候选。
这相当于按长度归一化的评分,不能笼统称为“整个字符串概率最大”。不归一化时比较的是负对数概率总和,两者可能选不同候选。例如候选 A 有两个 token,损失各为 0.7,总和 1.4、均值 0.7;候选 B 有三个 token,损失各为 0.5,总和 1.5、均值 0.5。总和选 A,均值选 B。本书实际测试确认这个差异。
候选长度不同,组成张量时需要 padding。padding token 的损失必须被 mask 排除。课程还在每个候选正文前加一个空格,再单独编码,因为 GPT-2 的分词与前导空格有关。评估模板、空格、上下文编码方式都属于指标定义的一部分,不能在比较模型时随意改动。
本书增加了一个真实 logits、tokens、mask 的微型测试。正确移位后的两个续写分数约为 0.026595 和 6.387977;用错位 mask 时,第二个分数变成 1.609438,已经不是同一个问题。再只扰动上下文目标位置的 logits,正确的续写分数变化为 0。这个性质检查能发现把上下文损失混进候选评分的错误。本书没有下载 HellaSwag 数据,也没有得到任何真实模型的 HellaSwag 准确率。
分布式评估让编号 i 的样本交给 i mod R 对应的 rank。各进程样本数可能不同,所以最后应汇总正确个数与总个数,再相除;不能无条件平均各 rank 的准确率。
28.6 checkpoint 是快照,还是能继续走的状态
固定课程 checkpoint 保存 model、config、step 和 val_loss。它足以支持某些加载和推理工作,但不包含 AdamW 状态、随机数状态与数据读取位置,因此不能保证精确续训。代码注释也明确提出这一扩展方向。
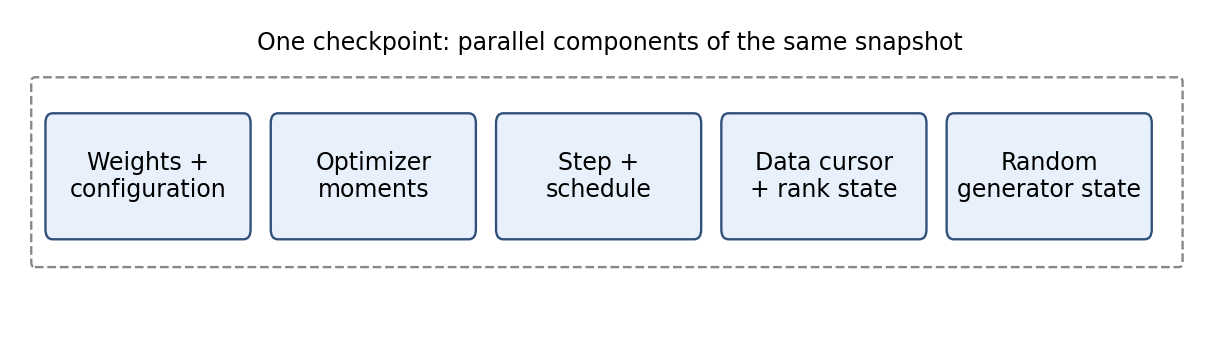
为了恢复下一次更新,至少要知道模型参数和架构、优化器内部状态、下一次更新的索引、日程配置、数据版本与游标,以及实际使用的随机数生成器状态。使用 scaler、分布式 sampler 或独立采样 RNG 时,还要保存相应状态。只保存“seed=1337”不等于保存当前 RNG 状态:程序可能已经消耗了成千上万个随机数。
本书的微型恢复实验先执行一次 AdamW 更新,保存参数、优化器和 CPU RNG,生成下一批随机输入并再更新一次。随后重新构造模型,恢复状态与 RNG,重新生成同一批输入,再做同一步更新。所有参数的最大误差为 0,共享参数关系也保留。它证明这个封闭的 CPU 实验能精确恢复;不证明跨 GPU、跨版本、跨进程拓扑都逐位一致。
还有一个时间点细节:课程在循环开头验证和保存,随后才执行该 step 的训练更新。因此 step=5000 的保存位于本轮更新之前,恢复代码应明确记录 next_step,而不是看见一个 step 字段就猜它代表“已经完成”还是“即将开始”。最后一次保存也发生在最后一轮更新之前;若要保存真正最终训练权重,应在训练循环结束后再保存。
加载文件同样有边界。只打开可信来源的 checkpoint;本书示例保存普通字典和张量,用 weights_only=True 加载,不为了加载陌生文件而关闭安全约束。原脚本将 dataclass 配置对象直接保存,与本书转换成普通字典的格式不同,不能把两种加载方式当作完全可互换。
28.7 怎样报告一个诚实的复现结果
一次结果至少应该同时回答四个问题:使用了什么代码与数据,消耗了多少 token,评估了什么,哪些条件尚未验证。课程最终视频回看结果、比较不同模型训练,并介绍 llm.c 的 C/CUDA 路线;这些是学习后续工程的入口,不构成本书已经复现同样速度、成本或分数的证据。
本书实际完成的是 7056 参数 tiny GPT 在固定循环 token 任务上的 100 次 CPU 更新,损失由 2.840298 降至最后更新后的 0.535705。标签规则是“当前 token 加一,再对 17 取模”。这验证了前向、反向和优化循环能学习一个简单关系,不检验自然语言泛化,更不意味着训练出了一个小型聊天助手。
把日志画出来,也要保留比较条件
上游 play.ipynb 的日志单元读取既有训练日志,将每行的 step、stream、value 分开,再按 train、val、hella 分类和步骤排序。它分别画训练/验证损失和 HellaSwag 准确率,加入预先填写的 GPT-2、GPT-3 参考水平线。损失轴使用对数刻度:曲线的垂直距离不能再按普通线性差值理解。若重复步骤被存入字典,后出现的值还会覆盖前值;续训日志应避免让这一行为悄悄掩盖重复记录。
图中的历史基线是 notebook 所载比较配置下的参考,不是本书测得的分数。不同评估提示模板、长度归一化和数据切分都可能改变数值,画在同一图上不自动证明可比。本书没有重绘不存在的 124M 长跑日志;实际小实验按其真实更新索引和损失输出报告。
练习与答案
以下为本书补充练习。
- x、y 都由同一连续流产生,为何取 B×T 个 token 不够?
- 为什么 HellaSwag 的 mask 要与目标 token 一起移位?
- 一份 checkpoint 只有模型参数,能否继续训练?能否严格续训?
- 验证损失下降但训练数据与验证文档有重复,能否据此证明泛化增强?
答案:还需要最后一个输入的下一个 token 标签,所以多取一个;logit t 预测 token t+1,mask 必须标记这个目标的位置;可以重新启动优化,但没有原优化器与数据/RNG 状态,不能声称严格续训;不能,应先排查泄漏,并用独立、版本明确的评估数据检验。
本章来源与验证边界
- 固定 fineweb.py、训练脚本、HellaSwag 脚本:逐段核对的实现。
- GPT-2 论文、GPT-3 论文、HellaSwag 论文:历史背景与评估定义。
- 本书完整实验结果:批次移位、completion mask、恢复和微型训练。
未执行:10B 语料处理、124M 权重训练或下载、真实 HellaSwag 全集评估、GPU/DDP/编译性能基准。