主题
第 8 章 让训练过程可比较
一个模型能把训练损失降下去,还不能回答三个实际问题:它对没用来训练的数据怎样?当前学习率是否合适?这次修改真的比上次好吗?这些问题需要一套不会随手改变的实验流程。
8.1 先切字符串,再展开成训练对
课程按 80%、10%、10% 切出训练、验证和测试集。训练集用来更新参数;验证集用来选择学习率、宽度和训练轮数;测试集用于最后评价。三者的作用不同,不只是把一个数组切成三段。课程数据划分与训练单元
先固定随机种子,把名字列表打乱,再分段,最后各自构造窗口。若先把名字拆成高度重叠的上下文,再随机切窗口,同一个名字的大部分相邻片段可能落在训练和测试两边。这个评估的独立性会弱于按名字划分。
第 4 章还指出真实文件有重复字符串。若要测试未见过的字符串,应先按名字分组再划分。本书小实验的 40 个自编字符串互不重复,按 32/4/4 条划分,最终得到 193/20/19 个字符预测样本;样本比例不恰好为 80/10/10,因为名字长度不同。这是正常现象。
词表如何建立也需要说明。课程先从全部字符建立固定字母表,然后切分名字,标签分布与参数训练仍只使用训练集。这对已知 26 个小写字母的任务很自然;真实产品若会遇到未知字符,应事先约定未知 token 或明确报错,而不是测试时悄悄扩展嵌入矩阵。
8.2 全批量正确,小批量实用
全批量训练每次计算所有训练样本的平均损失,梯度稳定,但更新一步的成本较高。小批量每次随机抽
python
indices = torch.randint(0, Xtr.shape[0], (batch_size,), generator=g)
logits = model(Xtr[indices])
loss = F.cross_entropy(logits, Ytr[indices])
正式随机抽批之前,可以固定一批做调试。本书 training_diagnostics.py 固定 16 条字符预测,反复训练同一批 500 次;损失从 1.798500 降到 0.348659。这说明该前向、反向和更新链条至少能拟合这批数据。它不是泛化成绩,也不要求必然降到零:重复上下文可能对应不同标签。
这里是有放回抽样,同一条样本可以在一个批次里重复出现。它不保证每固定次数的更新都恰好看遍数据一次,因此记录时说 “更新了 700 步” 比随意叫 “700 轮” 更准确。另一种实现是每轮打乱后切成互不重叠的批次,两者都合理,但随机过程不同。
在均匀抽样、每条记录权重相同的前提下,小批量平均梯度是全体平均梯度的无偏估计。单步仍有波动,训练曲线不必每一步下降。批量更大一般降低这种抽样噪声,但同时改变内存需求、每步成本和适用学习率,不能只按 “越大越稳定” 选择。
8.3 学习率扫描:观察范围,不把最低点当定理
学习率太小,正确方向走得很慢;太大,可能在低谷两边跳动,甚至产生非有限值。课程构造
python
exponents = torch.linspace(-3, 0, 1000)
learning_rates = 10 ** exponents
使学习率从
可以运行 python examples/part1/training_diagnostics.py 检查这个过程。脚本在同一个小模型上做 200 步扫描,学习率从 0.001 增至 1.0,保存每一步的学习率和小批量损失到 qa/part1/training_diagnostics.json。本次首尾损失为 1.822012 和 0.579722,末端没有发生非有限值;两端既不是同一批数据,也不是同一组参数,不能据此说 1.0 是最佳学习率。
这种扫描中,模型参数也在持续变化,横轴改变的不只是学习率,因此不能把曲线上最低的一点当成严格最优参数。它更像一个快速排除极端值的工具。正式比较若要公平,应从同一初始参数和相同批量序列重新训练多个候选,使用验证集选择。
本书的小模型固定初始参数种子 123、批量抽样种子 456,前 70% 步数用 0.15,之后降到 0.03。后期减小步长可以让已经找到的区域得到更细的调整;它不是所有模型都必须遵守的比例。课程最后演示的 20 万步、先 0.1 后 0.01 是另一个实验设置,不能与本书 700 步实验混为一谈。
8.4 记录损失时,记录的是哪一个模型
训练循环计算的 loss 通常对应更新前参数和当前小批量。它适合观察优化过程,但不应直接当成更新后模型对完整验证集的成绩。
python
with torch.no_grad():
    train_loss = F.cross_entropy(model(Xtr), Ytr).item()
    dev_loss = F.cross_entropy(model(Xdev), Ydev).item()
评估时不更新参数,也不需要建立反向图,因此使用 no_grad。本章网络没有 dropout 或 BatchNorm,尚不存在训练/评估模式的行为差异;后面引入这些模块后,还要设置正确模式。当前习惯不能无条件搬到所有网络上。
数据较大时,将评估集拆成多批。累加每批损失总和,再除以总样本数,而不是直接平均每批的均值;最后一个小批次可能较短,后者会给它过大权重。
课程记录 loss.log10() 方便展示跨量级变化。这是对已经算出的平均损失再取一次十进制对数,改变的只是图轴显示,不是把训练目标从自然对数 NLL 改成了十进制交叉熵。图标题应写清记录量。
8.5 保存验证集最好的参数,不能只保存那个数字
训练到最后一步不一定最好。本书每 50 步评估一次,遇到更低验证损失时复制所有参数:
python
if dev_loss < best_dev:
    best_dev = dev_loss
    best_state = [p.detach().clone() for p in parameters]
只写 best_state=parameters 保存的仍是原对象引用;后续训练会继续修改它们。detach().clone() 得到不带求导关系的新存储。结束后把这份状态复制回模型,再计算最终训练、验证与测试损失。
评估间隔意味着我们只在检查点之间选择最优,不能声称找到了所有训练步的最低验证损失。本书三组模型都在相同检查频率下比较,使这一限制一致。
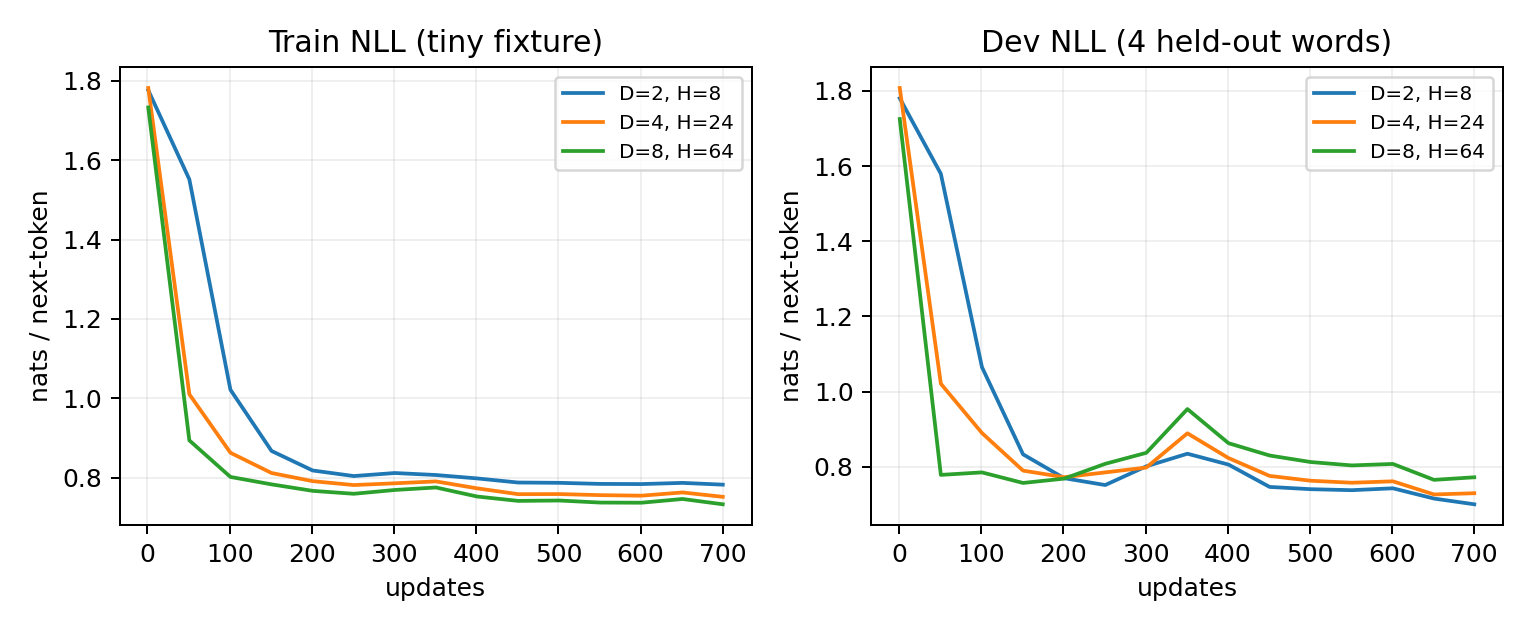
图里的验证集只有四个名字,曲线会受样本组成明显影响。它适合教学流程,不支持对一般名字分布作统计上稳健的排名。
8.6 从均匀预测检查初始化
官方 MLP E02 指出课程早期初始化比较随意,要求先算均匀预测损失,再把起始损失调得接近它。若有
最直接的实验是把输出权重 1.7917594692280547,与
本书真实测试中,第一次隐藏权重梯度范数为 0,输出层更新一次后为 0.00010357489509842373。因此更常用的教学折中是让输出权重从小随机数开始,使预测接近均匀,同时保留初始反传信号。把所有层都设为零则会引入前面讨论的对称问题,不能用 “均匀预测好” 推导出 “全部零初始化好”。
练习与解答
补充题:模型 A 在 32 个样本批次损失 1.0,在最后 8 个样本批次损失 2.0。全体平均是多少?答案为
补充题:对同一验证集反复选了上百次配置,还能把它当成完全没参与选择的数据吗?不能。验证结果已经影响设计。保留最终测试集的目的,就是减少这种选择造成的乐观判断;若连测试结果也用于继续选配置,应重新安排独立评价,而不是继续把它称为最后一次测试。
来源与复现
本章对应 MLP notebook 的 build_dataset、切分、小批量、学习率数组、训练循环、曲线、训练和验证评价,以及官方 Colab 新增的测试集评价。可运行流程在 language_lab.py 的 fit、mlp;初始化答案在 exercises.py。本书默认 CPU 单线程、float64,小规模对照优先精度;完整名字实验另用 float32,并在自己的日志明确记录。