主题
第 9 章 容量、泛化与一套完整实验
增加隐藏单元,通常会让网络有更多方式拟合数据。但 “有更多参数”、“训练得更好” 和 “对新数据更好” 是三件事。最后一章用同一套数据和明确日志,把它们分开检查,并完成前三讲的官方练习。
9.1 先看同一条件下的三个小模型
本书在 40 个自编、互不重复的名字上固定 32/4/4 划分,比较三组嵌入维数
| 参数数 | 选中步数 | 训练 NLL | 验证 NLL | |
|---|---|---|---|---|
| 2,8 | 122 | 700 | 0.781980 | 0.700446 |
| 4,24 | 486 | 651 | 0.762310 | 0.726584 |
| 8,64 | 2,038 | 151 | 0.782686 | 0.757191 |
按验证集选择第一组以后,才对该模型测最终测试集,NLL 为 0.773943。这里小模型的验证结果最好,但验证集只有 20 个字符预测,不能据此认定小网络普遍优于大网络。不同宽度的随机初始化也不是完全等价的模型起点。这个实验可靠回答的是:在这套明确的小数据、预算和选择规则下,选中了哪一个模型。
训练损失高、验证损失也高,可能是表达能力不足,也可能是优化没完成或代码有错。训练损失继续下降、验证损失却上升,是过拟合的常见迹象;它意味着继续利用训练集细节没有改善当前留出数据上的预测。但只有一次随机切分时,也要考虑验证样本过少的波动。诊断要结合曲线、数据规模与基线,不能只凭一个数字给模型贴标签。
9.2 生成样本与嵌入图能告诉我们什么
选中的小模型以采样种子 888 得到了以下结果:
text
dana
aba
dada
dada
dababanababanaba
dana
nababanana
bana
这些字符串来自真实日志,其中有重复,也有明显变长的模式。我们完整保留它们,不只挑几个看起来像名字的样本。模型用固定长度上下文预测,并没有直接记住 “一个名字应该几字符” 的全局规则;它可能不断抽到仍能继续的局部片段。
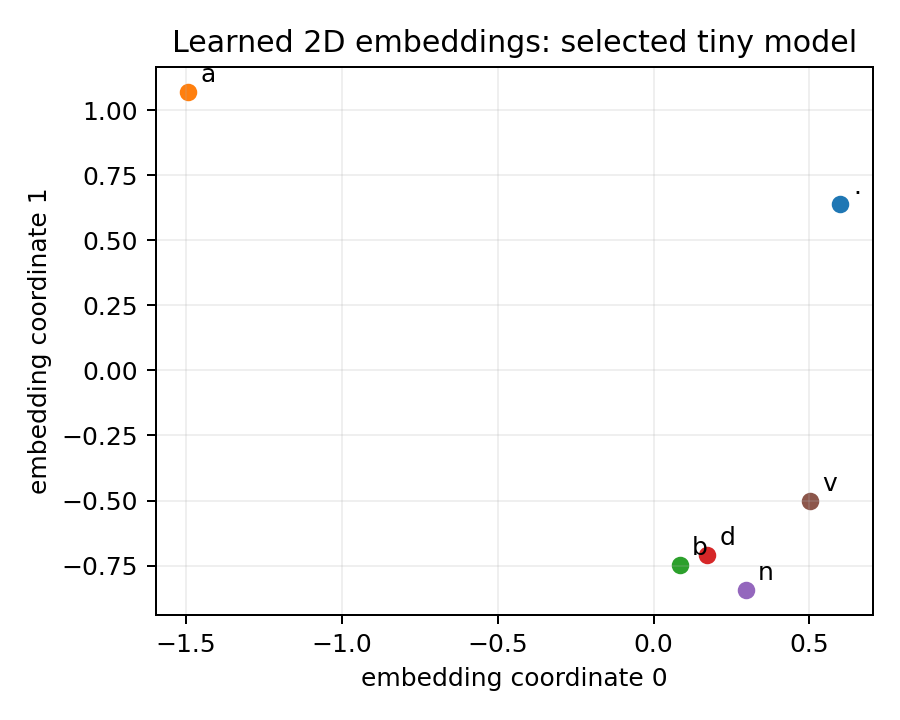
二维嵌入可以直接画点,标上字符。课程也用这种方式观察字符表示。若维数是 10,只画第 0、1 维看到的是一个坐标投影,可能漏掉其他维度的关系,不能凭投影距离断言所有字符的总体相似度。
即便二维,也不要给每个方向过度命名。嵌入坐标可以与后续权重共同变换而保持模型输出;单独一维未必有固定语义。图有助于提出 “哪些字符被相似使用” 的问题,真正的证据仍要回到预测变化和留出损失。
9.3 官方 bigram E01–E03:更长的表不一定更好
官方题目依次要求实现 trigram、按 80/10/10 切分、用验证集选择平滑强度,最后再测测试集。trigram 的上下文有两个字符,若它们的 ID 为
python
row = X[:, 0] * V + X[:, 1]
counts = torch.zeros((V * V, V))
for context_id, target_id in zip(row, Y):
    counts[context_id, target_id] += 1
probs = (counts + alpha) / (counts + alpha).sum(1, keepdim=True)
完整实现 examples/part1/exercises.py 同时支持一字符和两字符上下文。下面是同一份小数据划分的真实结果,平滑候选事先设为 0.01、0.1、1、10:
| 模型 | 平滑 | 训练 NLL | 验证 NLL |
|---|---|---|---|
| bigram | 0.01 | 0.914378 | 0.877875 |
| bigram | 0.1 | 0.924438 | 0.887531 |
| bigram | 1 | 1.010324 | 0.970934 |
| bigram | 10 | 1.365221 | 1.331284 |
| trigram | 0.01 | 0.844999 | 0.970105 |
| trigram | 0.1 | 0.866030 | 0.988154 |
| trigram | 1 | 1.023043 | 1.121372 |
| trigram | 10 | 1.470516 | 1.505692 |
trigram 以更低训练损失拟合数据,却没有获得更低验证损失。更多上下文把样本拆进更多行,统计变稀疏,正好展示了容量的代价。在这一小网格里,trigram 最佳 1.116726。不能因此宣布 “0.01 是普遍最佳”,甚至不能宣布它是这个数据集所有实数候选中的最佳;我们只比较了四个候选。
官方 E04 的查表替换、E05 的稳定交叉熵、E06 的自选温度实验在第 6 章都有可运行答案。这六题原题来自 第二讲官方视频描述,本书用自己的代码和小数据回答,不把这里的 NLL 当成课程 names.txt 的成绩。
9.4 官方 MLP E01:一次真正的全量名字实验
官方 E01 的目标是通过调参,让验证损失低于讲师给出的 2.2。仅用六字符的自编数据得到 0.7,显然不能完成这个目标:词表、数据分布和预测难度都变了。因此本书另跑了一次完整 names.txt 实验。
bash
source qa/environment/env.sh
python examples/part1/full_names_mlp.py \
  --names research/part1/makemore/names.txt \
  --steps 50000 \
  --embedding 20 \
  --hidden 300 \
  --output qa/part1/full_names.json
数据固定在 makemore 提交 988aa59e4d8fefa526d06f3b453ad116258398d4,文件 SHA-256 记入输出。按原始记录打乱后 80/10/10 切分,种子 42;模型种子 2147483647,批量种子 456;上下文 3,嵌入 20,隐藏宽度 300,输出类别 27,参数数 26,967。使用 CPU 单线程、PyTorch 2.6.0、float32,批量 64;前 35,000 步学习率 0.15,后 15,000 步为 0.03。
| 检查点 | 完整训练集 NLL | 完整验证集 NLL |
|---|---|---|
| 5,000 步 | 2.283660 | 2.286017 |
| 20,000 步 | 2.179197 | 2.197229 |
| 35,000 步 | 2.137744 | 2.172313 |
| 50,000 步 | 2.071818 | 2.113464 |
按验证集选中的最终检查点在测试集上得到 2.111799。它达到了官方练习的数值门槛,但有明确边界:这是本书新运行的配置,不是原视频随机轨迹的逐步复现;数据按行划分,有重复字符串可能跨集合,所以不代表对 “完全没出现过的名字字符串” 的严格分组测试。一次种子也不代表平均性能。精确日志、全部检查点和环境字段在 qa/part1/full_names.log、full_names.json,同名 .pt 保存所选参数、词表与配置。
这组设置扩大了嵌入和隐藏层,同时采用较小的输出权重初始化。它足以完成练习,却不是一次控制单个变量的因果实验,不能把改进全部归功于宽度或某一个初始化系数。要判断单个设计的贡献,应分别恢复其他设置并重复比较。
9.5 官方 MLP E02 与 E03:初始化、论文和可检验的想法
E02 的均匀初始化基线与梯度边界已在第 8 章完成。对于完整词表,3.291622,与该基线接近。因为标签频率不均匀,一个轻微非均匀的随机预测可能偶然比均匀基线更低,接近不要求必须大于它。
E03 要阅读 Bengio 等人的论文并尝试其中一个想法。论文模型允许从连接后的输入表示到输出增加一条直接线性路径。记连接后的向量为
额外路径让一部分线性关系不用经过 tanh。这是对论文结构中一个想法的简化尝试,不是把整篇论文重新实现。Bengio 等人,2003,第 2 节模型结构
exercises.py 固定相同小数据、初始化与批次序列,训练 300 步;无直接路径的训练/验证 NLL 为 0.819660/0.783090,加入路径后为 0.802446/0.773019。这次小实验略有改善,但差值很小、数据很少,也只跑一个种子;它提供一个可以继续核验的结果,不能推广成 “加直接路径总会更好”。
9.6 从代码包重新跑一遍
前三讲配套代码没有隐式依赖 notebook 的执行顺序。建议先跑测试,再跑训练,最后生成图:
bash
source qa/environment/env.sh
python examples/part1/scalar_engine.py
python examples/part1/micrograd_exercises.py
python examples/part1/language_lab.py --output qa/part1/language.json
python examples/part1/exercises.py
python examples/part1/training_diagnostics.py
python examples/part1/make_figures.py
scalar_engine.py 检查导数、共享图和四点训练;micrograd_exercises.py 完成官方解析/数值微分与 softmax 练习;language_lab.py 验证张量性质并训练三种小 MLP;exercises.py 跑 trigram 平滑、初始化、论文路径和温度实验;make_figures.py 从真实 JSON 记录绘图。环境、种子、数据、参数量、选择方式都应与损失一起保留,否则 “复现了一个数字” 很难说明复现的是哪个实验。
进一步练习与判断标准
补充题:把全量名字实验改为按唯一字符串分组切分,再比较验证结果。先固定评估问题,再报告差异;不要把两种划分的损失混进同一排名。
补充题:将同一个两字符上下文反复给予两个不同标签。模型能否让两者概率都接近 1?不能,因为一行概率和为 1。训练损失存在由条件分布不确定性带来的下限;更多步数无法消除输入本身没有提供的信息。
补充题:给小模型固定一批数据,逐步打印 p.grad is None、梯度范数和更新前后参数差。如果损失不动,应该能定位是没有求到梯度、学习率问题、更新对象错误,还是预测已经处于平坦区。自动求导替你计算导数,没有替你决定这些检查。
本部分完成了什么
前三讲把训练闭环逐层接起来:标量计算图说明梯度如何产生;bigram 把字符串变成概率预测;上下文 MLP 通过嵌入与隐藏层共享参数;验证流程帮助判断更复杂的模型是否值得保留。后面的章节将继续检查内部激活和梯度的尺度。那些问题仍会落回这里的基本动作:明确形状,写出依赖,核对损失,运行一个能暴露错误的小实验。
官方练习范围依据已核对的 micrograd Colab、bigram 视频描述、MLP 视频描述。逐单元与逐题对应表见随书审计资料;本部分没有声称取得或逐秒核对视频字幕。