主题
第 16 章 从树到卷积:感受野、因果性与可靠迭代
树形模型每次读八个字符,输出下一个字符的分布。假设要对一句文本的相邻八个窗口都预测一遍,最直接的办法是循环调用模型八次。窗口大量重叠,里面的局部组合也会重复计算。课程第 6 讲最后用这个现象引出卷积,但尚未完整实现扩张因果卷积。
本章前半延续课程的“卷积是在多个位置复用同一种局部计算”这一线索;带有“补充”的段落给出本书新增的实际卷积代码、等价性与因果测试。树形教学网络和 2016 年完整 WaveNet 的区别始终保留,不用同一个名字抹掉它们。
16.1 一组 Linear 就能写成一个局部卷积
先看相邻两个位置,每个位置有
这里的分号表示拼接,不是求和。对每一组相邻位置重复同一表达式,就是局部共享权重计算。若各组互不重叠,起点为 0、2、4、6,对应核宽 2、stride 2 的一维卷积。stride 是相邻输出在输入中前进几格。
比如一维输入
补充:实际库接口。 PyTorch 的 conv1d 接收
python
# x: B,T,C; W: 2*C,H
by_groups = x.reshape(B, T//2, 2*C) @ W
kernel = W.reshape(2, C, H).permute(2, 1, 0)
by_conv = F.conv1d(x.transpose(1, 2), kernel, stride=2).transpose(1, 2)
配套实验随机生成
严格说,深度学习库常用的是互相关形式:核不做数学卷积中常见的翻转。这里只要两边采用同样的权重顺序,等价关系就成立。实际移植时不能一边按“最早到最近”展开,一边按“最近到最早”放核。PyTorch v2.6.0 卷积源码与定义
16.2 因果性由输入依赖决定,不由名称决定
预测位置
补充实现。 核宽为
python
def causal_conv(x, w, dilation):
    # x: B,T,Cin; w: K,Cin,Cout,w[-1] 对应最近位置
    K = w.shape[0]
    padded = F.pad(x.transpose(1, 2), (dilation * (K - 1), 0))
    kernel = w.permute(2, 1, 0)
    return F.conv1d(padded, kernel, dilation=dilation).transpose(1, 2)
其中 F.pad 的二元组按最后一维的左、右填充值解释。若用对称 padding,当前位置很可能读到右边的未来输入;输出形状仍然“正确”,所以 shape 测试抓不住泄漏。
配套正例将时间 10 及之后的输入增加 100,检查时间 0–9 的输出完全不变,最大差值为 0。负例改用核宽 3、对称 padding 1 的全一卷积,时间 9 的输出变化了 100,证明未来已经漏进来。因果性测试应直接干预未来输入,不能只看训练 loss 是否合理。
16.3 扩张率如何让感受野长得更快
感受野是一个输出在结构上可能依赖的输入位置范围。普通核宽 2、stride 1 的卷积,每叠一层只向过去多看一个位置。扩张卷积让相邻核采样点隔开
设所有层 stride 为 1,第
若核宽始终为 2,三层扩张率为 1、2、4,就有
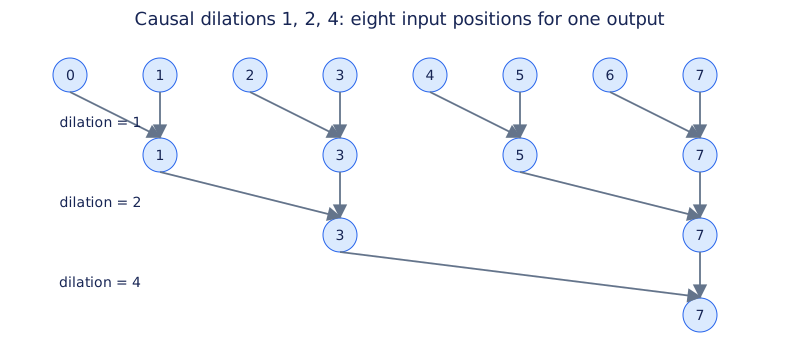
考虑输出时间 9,三层应依赖时间 2–9。本书把三个两项核都设成 1,避免随机抵消,反传单个输出。输入梯度非零的位置恰好为 [2,3,4,5,6,7,8,9]。这个检查证明的是本次结构与非退化权重下的依赖范围;若某权重为零或路径相互抵消,梯度为零不一定代表结构上不可能依赖该位置。
若还有 stride,计算需同时追踪相邻输出对应输入的间隔
三层核宽 2、stride 2、无扩张时,
16.4 一棵滑动的树,怎样变成扩张卷积堆栈
把八字符树应用到每一个滑动窗口。对以时间
现在不按窗口重复做,而先在整段序列每个位置计算第一层的相邻对。第二层在位置
配套 conv_tests() 用三层随机权重和 tanh,在长度 11 的序列上比较:一边逐个提取四个完整八字符窗口运行树,另一边在整段运行扩张率 1、2、4 的堆栈,再取时间 7–10 的输出。最大误差为
这个等价测试有明确前提:相同权重、相同非线性、相同位置顺序;比较完整窗口避免边界填充差异;测试中不加入训练 BN。若 BN 处于推理模式,可以先折叠为固定仿射变换再比较。训练 BN 的统计集合随窗口组织方式变化,不能期待逐滑窗树与整段卷积仍给完全相同的值。
更重要的是,整段密集自回归训练若在时间轴上计算 BN 统计量,早期输出可能通过统计量间接依赖后面的真实 token。即使每个卷积都只向左看,也不能再直接宣称整个训练函数严格因果。第 15 章一次输入历史窗口、只预测窗口后一个标签,与在整段每个时间位置同时预测,是不同的使用场景。这里的因果测试有意用不跨时间汇总的操作,避免这个混淆。
16.5 与完整 WaveNet 的边界
WaveNet 原论文针对原始音频的自回归分布,使用扩张因果卷积、门控单元、残差与跳跃连接,并讨论条件信息。教学树形模型只保留局部组合逐层扩大的思路,使用字符 embedding、普通 tanh 和 BN;它没有复现音频量化、条件语音生成或论文的主观听音实验。WaveNet 原论文,2016
| 比较维度 | 本课树形字符模型 | 论文中的关键设计 |
|---|---|---|
| 目标 | 下一个字符的分类分布 | 下一个音频采样值的分布 |
| 上下文计算 | 分组拼接与共享 Linear | 扩张因果卷积 |
| 非线性 | tanh | tanh 分支与 sigmoid 门逐元素相乘 |
| 深层路径 | 顺序层 | 残差与通往输出的跳跃连接 |
| 输出位置 | 每个窗口一个 | 可对整段各时间位置并行训练 |
理解门控不需要把它想成额外的控制程序。两条同形状卷积结果分别经过 tanh 与 sigmoid,再逐元素相乘;sigmoid 给每个位置一个 0 到 1 的倍率。残差相加要求两侧形状相同,必要时用投影匹配。它们都属于后续可独立学习的结构,本书此处只标清差别,不声称小实验复现完整 WaveNet。
16.6 课程的成绩日志应该怎样读
第 6 讲 notebook 保留了一条开发记录。下面按原来源重列数值,不是本书本机复现,也不是每一步都只改一个变量的严格消融实验。
| 上游记录的配置变化 | train loss | val loss |
|---|---|---|
| 3 字符上下文、200 隐藏单元,约 12K 参数 | 2.058 | 2.105 |
| 上下文扩为 8,约 22K 参数 | 1.918 | 2.027 |
| 扁平改为层级结构,约 22K 参数 | 1.941 | 2.029 |
| 修复 BN 归约轴 | 1.912 | 2.022 |
| embedding 24、hidden 128,约 76K 参数 | 1.769 | 1.993 |
从这组记录至少可以看出:树形结构不会凭名字自动战胜同规模扁平模型;一个“程序可以跑”的 BN 轴错误也可能影响最终结果。至于结构、容量、训练随机性各贡献多少,得通过新的控制实验判断,不能仅凭五行历史日志分配因果。
课程还把每步 loss 分组平均,减少曲线的抖动。如果原记录存的是 log10(loss),先平均再画显示的是平均对数损失,也就是原 loss 几何平均的对数,不等于先平均原 loss 再取对数。比如两步 loss 为 1 和 9,平均 log10 为约 0.4771,而平均 loss 的 log10 为
原代码 view(-1,1000).mean(1) 还要求长度能被 1000 整除。缩小实验只有 400 步时,应该改变分组大小或处理尾块,而不是复制后让 reshape 报错。每次重构训练器,都要留一个几秒能跑完的烟雾测试。
16.7 把“改进 loss”变成能核对的实验
视频结尾邀请读者继续改进模型,但没有提供一条必胜配置。可以先建立实验表,每行记录一个明确改动及其证据。固定按单词划分的数据、字符映射、训练预算、评估模式和 seed;只在 dev 上选择候选,最后一次用 test 报告选定模型。
先试上下文与隐藏宽度时,要同时记录参数量与计算成本。更长上下文可能补充有用信息,也可能增加学习难度;更大隐藏宽度可能降低训练损失,也可能扩大泛化差距。比较“相同参数量”和“相同训练时长”回答的是不同问题,应明确选择哪一个。
本书的完整执行顺序是:检查分组顺序和参数数目,验证 BN 轴和推理状态,用微型数据确认损失下降,验证卷积等价与未来干预测试,再考虑长训练。换成整段卷积实现后,优先比较同一组冻结参数的输出;只有这项通过,才比较重新训练后的 dev loss。否则性能差异可能只是端点对齐或核顺序错误。
练习与答案
- 补充。 核宽 3,扩张率依次为 1、2、4,stride 都是 1,感受野跨度是多少?最左、最右位置怎样确定?
- 补充。 把两两拼接的 Linear 改成三位置拼接,如何构造对应 stride-3 的卷积核?
- 课程开放挑战。 在完整姓名数据上尝试一个更好的 dev loss,但给出配置、预算、重复 seed 和测试集使用规则;不以生成的几个好看名字代替指标。
- 补充。 若只检查输出长度相同,能否证明因果卷积正确?设计一个反例。
第一题
所有补充卷积检查都在 examples/part2/experiments.py:conv_tests(),图由 draw_diagrams.py 生成。至此,我们有一条清楚的升级路线:先保证每个局部操作的梯度与形状正确,再让共享计算覆盖更长上下文,而不是依靠更大的模型掩盖基础错误。
来源与范围
- 课程第 6 讲、固定 notebook:开发日志、平滑作图、循环窗口预测与卷积预告。
- WaveNet 论文:架构边界。逐元素数值例子、感受野推导、实际扩张卷积实现与正反例为本书补充,未声称出自本讲现场代码。
- PyTorch v2.6.0 卷积实现:输入布局与核的约定。