主题
第 13 章 把反向传播写成张量运算
前面的小型自动求导引擎以标量为单位。现在一行矩阵乘法包含成千上万次乘加,但规则没有改变:沿每条使用路径应用链式法则,再把同一个变量收到的贡献相加。难点转移到了形状、广播与归约。
课程第 5 讲让读者手写整个两层 MLP 的反传,而不是再实现一个通用 autograd 引擎。本章走完损失、输出线性层和 tanh;下一章继续 BatchNorm、输入线性层和 embedding。配套代码 manual_backprop.py 保留每一个中间张量,能逐项对照 PyTorch,而不是只看最终 loss 能否下降。官方练习 notebook
13.1 梯度的形状为什么应该跟原变量一样
记标量损失为
以
若
反过来,
对于一般的前向广播,应把新增加的前置轴和原来长度为 1 而后来被扩展的轴都求和,最后恢复原形状。例如 allclose 不够,还要先断言形状一致,以免比较本身又发生广播。
13.2 从平均负对数概率开始往回走
设一个批次有
先把
然后逐元素反传 log:
此时不能直接结束
第二项广播回各类别,正是“前向求和,反向广播”。少掉它,通常仍能得到非零梯度,却不再是交叉熵的正确导数。配套代码中这一步明确使用 +=。图中分叉又汇合的两条路线提醒我们为什么需要相加。
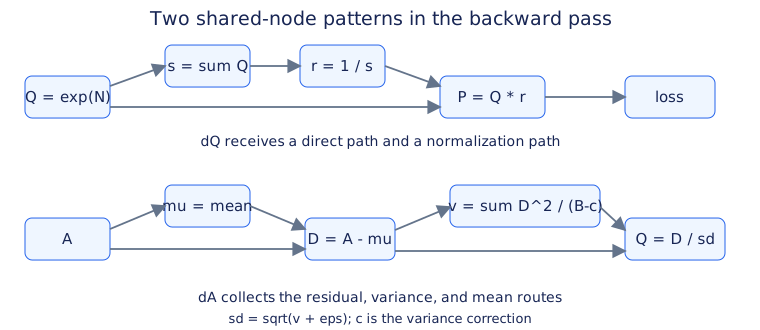
指数的导数等于自己,故
13.3 减最大值的那条路径不能凭感觉删掉
从 max 的反传把
python
dlogits = dnorm.clone()
dmax = -dnorm.sum(1, keepdim=True)
dlogits.scatter_add_(1, logits.argmax(1, keepdim=True), dmax)
对 softmax 交叉熵,精确算术下行梯度之和为零,所以这条最大值路径最终抵消。可是本练习要求匹配逐个中间节点的图,不应先跳过它,再把“不太一样”归咎于 PyTorch。最大值并列时局部不可微,库会按具体算子的规则选择梯度路径;我们用随机、非退化的 logits 做有限差分检查,避开这个拐点。
减去同一行的最大值不会改变 softmax,因为分子分母同时乘以
但把 exp、除法和 log 分开,仍可能遇到很小概率下溢成零,随后 log(0) 出现无穷。生产训练应优先使用融合的 F.cross_entropy 或稳定的 log-softmax,而不是为了模仿教学图坚持这套展开。手写展开适合学习和小范围核对;本书梯度实验刻意使用温和随机 logits。 配套 numerical_ce_tests() 还实际运行了正反例:[1000,1001,999] 直接 exp 归一化产生非有限值,稳定计算的概率为 [0.244728,0.665241,0.090031],目标为中间类别时融合损失为 0.407606;[0,-1000] 的目标若为第二类,先 softmax 后 log 得到无穷,融合交叉熵仍得到有限的 1000。
13.4 官方练习 2:把交叉熵压缩成三行
对一个样本,softmax 交叉熵也可写成
对第
批平均再乘
python
dlogits = logits.softmax(1)
dlogits[torch.arange(B), targets] -= 1
dlogits /= B
举一个不需要计算指数的例子。若某行概率为
该简式假设普通硬标签、无类别权重、无 label smoothing、无忽略标签,并且 reduction 为 mean。换成加权损失、平滑标签或 sum,系数会改变。不要把这三行不加修改地移植到所有分类损失。
13.5 矩阵乘法反传,先按一个元素推
输出层为
固定
固定
偏置照旧求批次和,
用一个两输入、两输出的样本验证:
再穿过
13.6 怎样判断自己的反传真的正确
官方练习 1 要求逐中间张量核对,练习 2 才允许使用简式。配套程序先运行自动求导作参照,调用 retain_grad() 保存中间梯度,再运行 backward() 这个手写函数。注意名称碰巧相同:它是本书的普通 Python 函数,不调用 loss.backward()。
核对先看形状,再看最大绝对误差、allclose。精确相等可以帮助定位计算顺序,但不能作为数学正确性的唯一条件。s**-1 与 1/s 在浮点实现中可能走不同路径,重排求和也会改变末尾位;课程正好用这个例子解释位级一致和近似一致的区别。
为了避免错误被特殊初值遮住,测试中的偏置和 BN 参数带有小随机扰动,不都设为零。批次故意重复同一字符,让下一章 embedding 的累加错误也能暴露。torch.autograd.gradcheck 用 float64 中心差分检查整个标量函数,作为另一道证据。损失能下降、生成文本看起来合理,都不足以替代这些检查。
练习与答案
- 官方练习 1,前半。 按原子步骤实现从
logprobs到hpreact的所有梯度,不能先使用 softmax 简式。提示:把前向变量画成图,标出被用两次的counts。 - 官方练习 2。 不参考代码,用索引推导交叉熵简式,并解释每行梯度为什么为零和。
- 补充反例。 在
dcounts += ...处删掉加法,哪一项测试最先失败?
前两题的完整推导就在本章各节,逐行答案在 manual_backprop.py:backward。第三题中 dprobs、倒数路径的梯度仍可能正确,但合并后的 dcounts 就首先不匹配,此后的 logits、线性层参数等也会受影响。正是因为从输出向输入逐项比较,才不必在整个网络中盲猜。
来源与范围
- 第 5 讲官方视频与四项练习;固定源码,单元 7–18。
- 官方 Colab 是留空的练习版本,固定仓库 notebook 带参考答案;本章同时核对两者,没有把 Colab 的空答案当作未覆盖内容。
- 全部推导、图与数值例子为本书原创讲解。MIT 源码改编声明见配套 NOTICE;未获得逐字字幕,不声明逐秒覆盖视频措辞。