主题
第 12 章 训练诊断:不要只盯着一个 loss
损失能告诉我们预测整体变好了没有,却不能指出哪个中间环节在阻碍训练。把网络加深以后,第一层可能已经几乎收不到梯度,最后一层仍能通过调整类别偏置让 loss 下降。诊断的目标是把这两件事区分开来。
课程第 4 讲后半段将操作拆成 Linear、BatchNorm1d、Tanh,记录各层的输出,再看激活、梯度和参数更新。本章沿这条线建立一个可重复的检查顺序。第 15 章再扩充这些层接口,组成树形上下文模型。固定 notebook,单元 12–24
12.1 给每层留一个可检查的出口
手写 Linear.__call__ 时,把 self.out = x @ self.weight + self.bias 保存下来。Tanh 同样保存 self.out。于是一次完整前向后,能逐层取到输出形状、均值、标准差,而不用从一条很长的表达式中猜中间状态。
标准差衡量这一组数有多分散。均值接近零、标准差适中常常是有用信号,但不是充分条件:一半为 −1、一半为 1 的 tanh 激活均值也可以为零,标准差也接近 1,局部导数却几乎为零。直方图能揭示这种信息。先看各层激活分布是否逐渐挤向零或两端,再看饱和样本比例,最后看某一列是否对所有样本几乎恒定。
调试中间梯度时,要在 loss.backward() 前调用 layer.out.retain_grad()。可训练权重是叶子张量,通常会保留 .grad;中间输出不是叶子,默认不会把梯度存进它的 .grad。反传内部用到了某个梯度,并不表示 Python 对象事后一定保留了它。PyTorch v2.6.0 Tensor 文档定义
保存中间输出和梯度会占内存。调试结束应关闭这些记录,而不是把 retain_grad() 当成训练所必需。它与 retain_graph=True 也不是一回事:前者留某个张量的梯度,后者让一次反传后计算图不被释放,以便再次使用。
12.2 顺着前向和反向分别看尺度
设五层网络每层宽 32,每层执行 tanh(x @ W)。本书固定同一批输入与同一组基础标准正态权重,只改变初始化 gain,损失取最后激活的平方均值。这不是字符建模训练,只用于隔离尺度传播。
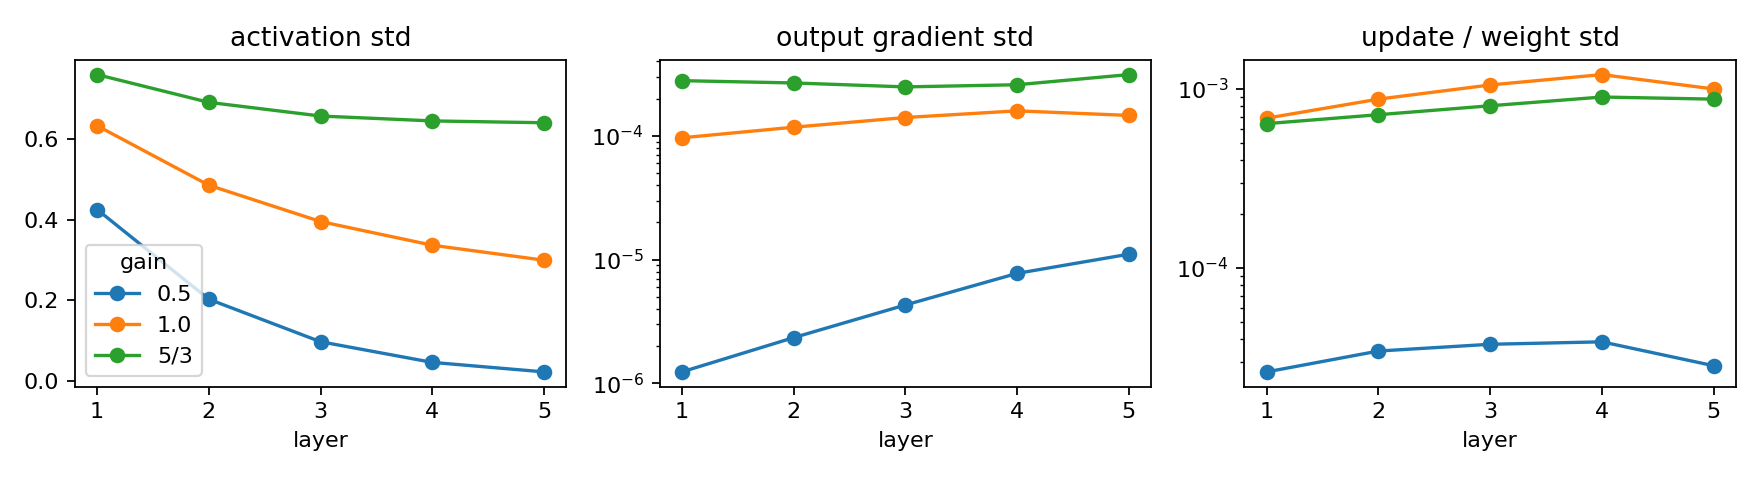
图的横轴从靠近输入的第 1 层走向第 5 层。看反向梯度时,信号实际从右向左传。小 gain 会让前向逐层缩小,也可能让早层收到更小的反向信号;gain 太大则会让更多 tanh 饱和。此处的 gain 取 0.5、1、5/3,图中的相对变化来自严格共享输入与基础权重的控制实验。
完整数值在 qa/part2/experiments.json 的 diagnostics 项。它们与课程中五层字符网络的图不是同一次实验,也不能推断哪一组最终验证损失最好。这个实验能回答的是:“在固定的这批输入和初始化上,信号沿层发生了什么变化?”
输出梯度与激活前梯度也要分清。对 h.grad 是 h.grad 看起来正常,仍可能在经过饱和 tanh 后衰减。因此需要把相邻节点连着看,而不是只给每层输出画一张图便宣布健康。
12.3 没有非线性,深度并不会增加这类表达能力
课程在诊断过程中暂时拿掉非线性,观察纯线性网络。若
则
两层合成的仍然是一个仿射映射。再叠多少纯 Linear,都能这样合并。中间窄层还可能限制最终矩阵的秩。参数化方式会影响优化过程,但不能因此说它获得了和非线性网络相同的函数集合。
把 tanh 暂时移除,有助于分辨线性乘法本身造成的尺度变化。第 4 讲 notebook 的 bonus 单元还对比了 Linear 与 Linear + BatchNorm 的前向、反向统计。线性层的反传是
BN 也不能无条件视为固定线性层。它只有在推理统计量固定时能折叠;训练时均值与方差随整批输入变化,样本之间的依赖是真实存在的。
12.4 参数梯度要与参数本身比较
两个矩阵的梯度标准差都为 0.01,并不代表更新强度一样。如果第一个参数矩阵的标准差为 1,第二个仅为 0.001,相同梯度和相同学习率会对后者造成大得多的相对改动。
对于普通 SGD,参数更新是
若 lr * grad 代替经过预条件后的更新。
对全零偏置,分母标准差可能为零;对常量张量也一样。别悄悄画一个无穷大点再归因于“训练爆炸”。可以只对有合理分散度的权重矩阵画这项统计,另外报告偏置的最大绝对更新,或明确改用带稳定项的 RMS 比例。课程绘图主要关注二维参数矩阵,本书保留这个解释边界。
观察多步曲线更有价值。某层比例一直极小,可能学习很慢;突然跃升,可能来自学习率、梯度异常或参数尺度收缩。它们都是待检查的线索,不能只凭一个阈值判定根因。更新前还是更新后读取参数标准差,也应保持一致并在日志里说明。本书示范图使用更新前参数。
12.5 为什么需要把 BN 带回来再看一遍
手写深网络最初使用好的初始化,仍可能在训练中逐渐改变分布。课程重新插入 BN,再看相同几类统计图。一个有价值的比较要固定数据划分、模型宽度、训练步数和评估口径;否则无法判断变化来自 BN,还是来自同时改掉的学习率。
BN 的运行统计量还引入了新故障方式:训练模式误用于验证、验证批次被写入运行均值、采样时单样本方差无效。训练 loss 和验证 loss 的差距不一定全是过拟合,也可能是分支用错。先在 eval() 下验证同一个样本“单独算”和“放在批里算”是否相同,这是第 11 章实验已经执行的检查。
原 notebook 的损失日志记录了原始模型、减小输出初始置信度、缓解 tanh 饱和、采用 fan-in 缩放和加入 BN 等阶段。它们展示的是一次开发轨迹,并非控制其他条件的消融论文。后来的深网络调试循环还显式在约 1000 步后中断;看到设置的 max_steps=200000,不能据此声称该单元的展示结果已训练满 20 万步。
12.6 从手写层看懂 ResNet-50 的代码
官方视频描述在 01:04:50 标出 ResNet-50 代码浏览。它的作用是让读者看到 BN 确实出现在成熟网络的普通模块中,而不是在本课实现、训练或证明 ResNet-50。本节用固定版本的 torchvision 源码说明这条联系。torchvision v0.21.0 ResNet
一个 bottleneck 主分支有三次卷积和对应的 BN,前两次之后执行 ReLU;第三次 BN 后先与旁路相加,再执行 ReLU。若通道数或空间分辨率变化,旁路也需要投影和归一化,使相加两侧的形状一致。卷积常设 bias=False,原因与前面“BN 会消掉紧邻线性偏置”一致。
这里的残差连接把输入通过一条较短路径传到后面,是另一项帮助深层优化的设计。课程第 4 讲没有完整展开残差训练或 Adam,本章也不把这个源码导览算作它们的系统讲解。读者此时至少能认出:哪些对象持有可训练参数,哪些持有运行统计量,哪些操作必须切换训练/推理模式,以及为什么普通层接口有用。
12.7 把检查排成一次短实验
先跑一个批次,确认输入输出形状和 loss 有限;再做一次反传,确认每个参数的梯度存在、形状一致且没有 NaN。接着用同一个小批次训练几十步,看它是否能被明显拟合。若这一步失败,先不要延长全数据训练。
小批次可以拟合后,再画激活与梯度分布,记录参数实际更新比例。最后恢复独立验证集、冻结 BN,用固定评估样本比较修改前后的损失。采样只能作为定性检查:生成几个看起来像名字的字符串,不能替代验证集交叉熵。
补充练习。 让诊断代码中的 gain 变为零,预测五层输出、梯度和比例的表现。再将最后损失改为随机线性函数,而不是平方均值,比较哪些结论依赖损失。提示:全零输出加平方损失,会让最末输出梯度也为零;若改为随机线性损失,最后输出处可有非零梯度,但它仍会在零权重处断开。答案应以逐节点张量验证,而不是只写“梯度消失”。
补充练习。 先 loss.backward(),然后才调用某中间张量的 retain_grad(),能否补回已经过去的梯度?不能。需重新前向,先请求保留,再反传。训练参数的 .grad 也应在新步骤前清空;否则默认会累加。
完整实验是 examples/part2/experiments.py 中的 diagnostics()。它生成本章图而不训练姓名模型;课程深网络训练流程与其代码的完整对应关系见本部分覆盖表。
来源与范围
- 第 4 讲视频章节描述:PyTorch 化、四类诊断、纯线性网络、重新加入 BN、ResNet-50 浏览。
- 固定 notebook:记录与作图的源码、调试停止条件、附加实验。
- torchvision v0.21.0与PyTorch v2.6.0 张量文档源码:模块和梯度保留行为。本书没有执行 ResNet-50 训练。