主题
第 19 章 把注意力装成能反复堆叠的块
单个注意力头给每个位置生成一组“向过去取信息”的权重。但同一个位置可能同时需要词形、语法和更远处的主题线索。多头注意力让模型并行计算多组投影与权重,再把它们的结果合起来。接着,我们需要一种接口稳定、梯度可以穿过的结构,才能把这样的操作堆叠很多次。
本章实现以 固定版课程 GPT 为教学参照,并用 固定版 nanoGPT model.py 对照多头并行的工程写法。
19.1 多头是在同一输入上作多次不同的投影
设模型宽度为 (B,T,d);把 (B,T,C)。
这不是把输入序列分给不同头,也不是每个头只看一段文本。每个头都能读取完整的允许前缀,只是投影不同。通常也不能直接把“多头”理解成预先指定的语法专家:功能分工是可能出现的学习结果,不是代码保证。
拼接后还要通过一个输出投影
原课程先用 ModuleList 保存多个 Head,再用 torch.cat 拼接。这种形式很适合初学者检查每个头。课程 EX1 要求把头作为另一个批维度并行处理。本书的 Attention 类就是这道题的一种解法。
19.2 逐个写出 reshape,才知道头去了哪里
一次线性层把 (B,T,C) 映射为 (B,T,3C),然后沿最后一轴切成 Q、K、V。每个仍是 (B,T,C)。把最后一维拆成 (H,d) 得到 (B,T,H,d),再交换中间两个轴,得到 (B,H,T,d)。
| 操作 | 输入形状 | 输出形状 |
|---|---|---|
| QKV 线性投影 | (B,T,C) | (B,T,3C) |
| 按最后一轴分三份 | (B,T,3C) | 三个 (B,T,C) |
| 拆头、换轴 | (B,T,C) | (B,H,T,d) |
| Q 乘 K 的末两轴转置 | 两个 (B,H,T,d) | (B,H,T,T) |
| 权重乘 V | (B,H,T,T)、(B,H,T,d) | (B,H,T,d) |
| 换轴、拼头、输出投影 | (B,H,T,d) | (B,T,C) |
python
q, k, v = self.qkv(x).chunk(3, dim=-1)
q, k, v = [a.reshape(B, T, H, d).transpose(1, 2)
           for a in (q, k, v)]
y = weights @ v
y = y.transpose(1, 2).contiguous().view(B, T, C)
transpose 往往只改变步长而不搬动数据,换轴后的张量未必连续。contiguous().view(...) 明确要求按新顺序排好后再展平;reshape 也可以在需要时复制,但不要把“可能复制”误解成“总是零成本”。
这里最危险的错误不是 shape 不匹配,而是 shape 恰好匹配、轴的含义却错了。比如漏掉 transpose,矩阵乘法可能让模型沿错误维度互动。本书测试用逐头循环结果对照并行结果,float64 最大差异为 0,同时与官方 SDPA 对齐。
19.3 注意力交换信息,前馈层加工每个位置的表示
注意力后面放一个逐位置前馈网络,常称 MLP 或 FFN:
这里采用列向量记法:(B,T,C) 的最后一维做相同操作,位置之间没有直接通信。
本课使用 ReLU,nanoGPT 的 GPT-2 实现使用 GELU。它们都是非线性激活,不能在移植权重时任意替换。没有非线性,两层线性映射可以合并成一层,增加中间宽度不会得到同样的表达能力。为什么注意力后还需要 FFN?注意力擅长按输入动态汇总其他位置,FFN 对汇总后的每个向量作非线性变换。两种操作交替,后层再依据加工后的表示重新决定该看谁。
19.4 残差要求宽度一致,也给梯度留出直接路径
残差连接写成
梯度因此有一条经过恒等映射的路径,不必每层都只乘上分支的 Jacobian。这个结构有助于训练深网络,但不等于保证梯度永不爆炸或每次训练都稳定。残差分支的初始化、学习率和归一化位置依然重要。Deep Residual Learning 原论文
为了帮助理解,可以想象残差主路维护“目前知道的信息”,分支提供一次修订。但不要据此认为所有分支都在学习很小的变化;大小由参数和训练过程决定。
19.5 LayerNorm 的统计量属于一个位置,不属于一批样本
对某个位置的向量
nn.LayerNorm(C) 对 (B,T,C) 的最后一维做这件事,不依赖另一条样本,也不跨时间位置归一化。因此生成时只有一条样本也能使用,不需要 BatchNorm 那样的跨 batch 运行均值。
原 notebook 从二维的 BatchNorm 教学类改成按行归一化,方便观察“单个样本的特征分布”。其中 x.var 的默认校正与正式 nn.LayerNorm 不完全相同。本书使用上式的除以 correction=0 约定。拿手写版做逐值对照时,必须同时对齐 epsilon、方差定义、归一化轴和 affine 参数。PyTorch 2.6 LayerNorm
19.6 Pre-LN 的顺序不能随意调换
本课块的实际计算为:
归一化在分支之前,称为 Pre-LN。注意第二个残差用的是已经更新的
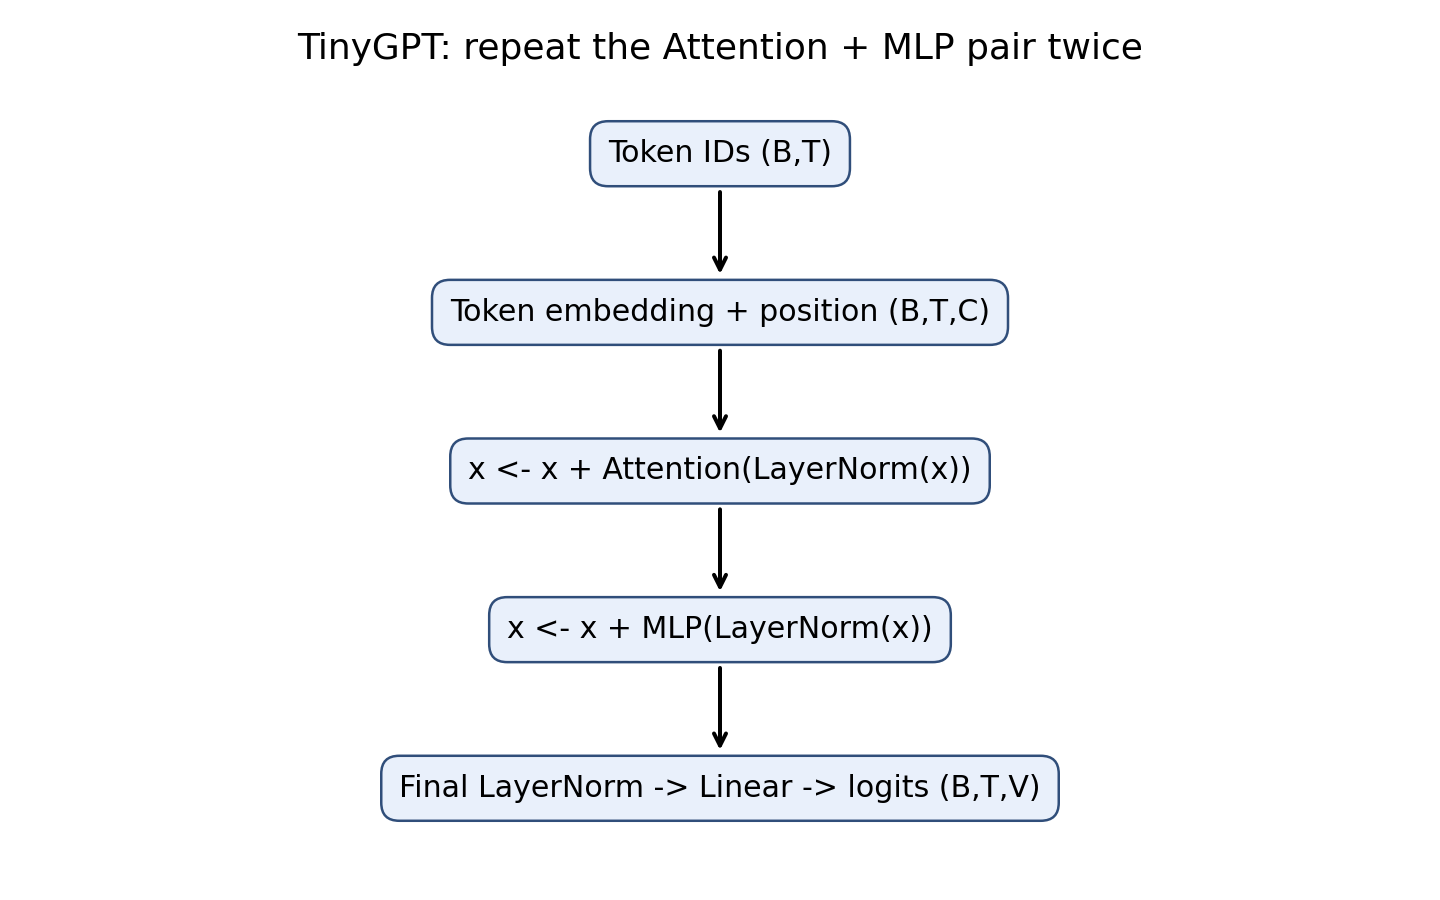
输入的 token embedding 和位置 embedding 只在进入整个块堆叠前相加一次,不是每层重新加一次。每层的参数彼此独立;[Block(...) for _ in range(L)] 正确创建 [one_block] * L 会重复引用同一个对象,导致参数共享。
19.7 dropout 改变训练时的计算,不应混进评估
Dropout 以概率
model.train() 启用 nn.Dropout,model.eval() 关闭它;这两者都不负责关闭梯度记录。torch.no_grad() 关闭梯度记录,也不会关闭 dropout。因此评估通常同时需要 eval 和 no_grad,再在结束后恢复之前的模式。函数式 SDPA 是一个容易遗漏的特例:它会按传入的 dropout_p 工作,要手动传 self.p if self.training else 0.0。
本书刻意用可见的矩阵乘法写注意力,以便检查权重和遮罩。生产实现可调用融合算子,避免显式保存全部中间量,但本章不把 CPU 上的等值验证说成 GPU 加速测试。
练习与答案
- 课程 EX1:
,QKV 切分、注意力权重和拼头后的形状分别是什么? - 补充题: 只设置
torch.no_grad(),同一输入调用两次输出仍不同,最先检查什么? - 补充题: 对
(B,T,C)写nn.LayerNorm((T,C)),与nn.LayerNorm(C)有什么区别?
答案。 第一题每份 Q/K/V 在切分后为 (2,5,24),换轴后为 (2,3,5,8);权重为 (2,3,5,5);拼头为 (2,5,24)。第二题检查是否仍处于 train 模式、是否有 dropout,以及自定义函数是否忽略 self.training。第三题前者跨所有位置和特征归一化,让较早位置的统计量依赖未来输入,会破坏此处所需的因果性,还把归一化参数绑定在具体的
本章主要来源:固定版 nanoGPT 模型;PyTorch 2.6 LayerNorm;残差网络原论文。实现和实验差异已在对应小节注明。