主题
第 29 章 一个会续写的模型,怎样变成助手
前面训练的模型会预测下一个 token,但用户想要的是另一种行为:读懂任务,按要求回答,遇到信息不足时承认不确定。两者可以使用相似的网络结构,却不能只靠换一个界面就视为同一件事。模型学到什么,还取决于训练材料和反馈信号。
本章与下一章对应官方播放列表中的 State of GPT | BRK216HFS,由 Karpathy 在 Microsoft Build 2023 主讲、Microsoft Developer 发布。它不是另一支名为 Intro to Large Language Models 的视频。官方描述明确列出 tokenization、pretraining、supervised finetuning、RLHF、prompting、finetuning 与 tools。本书据此建立主题覆盖,再用原论文和原创例子解释机制。未取得完整字幕;作者主页原 slides 链接在本次检查中返回主页而非 PDF,所以不声称逐页复述或覆盖演讲的每个现场示例。涉及产业状态的叙述限定在 2023 年历史语境,不把当年的产品、价格和能力当成今天的现状。
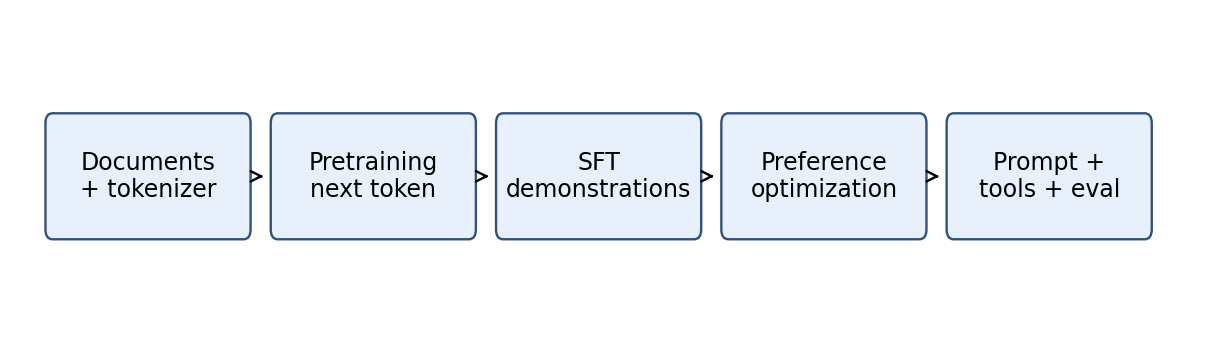
29.1 同一个下一 token 目标,面对的材料可以不同
tokenizer 把文本变成整数序列,模型为每个位置输出条件概率,训练让正确后继 token 的概率变高。这条链条已经在小模型中跑通。扩大规模时,基本的概率分解仍然是
预训练通常面对大规模文本,任务是根据上下文预测文本接下来如何出现。若材料中有问答、代码、故事和争论,模型会接触这些不同结构,却不等于已经明确学到“此刻我是一个应该服务用户的助手”。给基础模型一个问题,它可能续写答案,也可能续写另一个问题或网页格式。具体行为取决于提示与训练分布。自回归大规模语言模型与上下文学习:GPT-3 论文。
tokenizer 是这个过程的接口契约。同一句话被拆成什么 token,会影响序列长度、上下文预算和每 token 损失。模型权重与 tokenizer 必须配套。训练过后替换词表映射,不是给模型换一份字典那么简单,因为 embedding 的第 j 行已经对应旧编号 j 的使用方式。
29.2 “压缩文本”是有用的理解,但不是文件归档
为什么预测下一个 token 会涉及知识?考虑两段句子:“这份程序调用了未定义变量,所以运行时……”和“水在标准大气压下加热到沸点以后……”。要为后续内容分配合理概率,模型需要利用不同层次的规律:字词搭配、句法、常见事实、推理模式和文档结构。仅记住相邻两个字的频率,通常不足以覆盖这些依赖。
可以从编码长度理解负对数概率。若用模型给定概率作为理想编码分布,一个概率为 p 的符号所需的信息量是 −log₂p 比特。概率从 1/16 提高到 1/4,理想码长就从 4 比特降到 2 比特。训练减少负对数损失,可以理解为让数据在这个概率模型下更容易被压缩。这里是在解释损失函数的数学意义,不是说训练程序真的把每篇网页做成了可逆压缩包。
有限参数需要在许多模式之间共享表示,因此模型可能学到能泛化的规律;也可能记住频繁或特殊的片段。仅凭“压缩”这个比喻,不能证明模型不会记忆、不会泄露,也不能证明每条事实都被可靠保存。对于一个具体问题,生成流畅只表明模型给某种续写较高概率,不等于它已经向外部事实来源核验过。
本书的循环 token 实验有一个清楚边界:它学到的是一个低复杂度规则“加一取模”。损失下降说明模型能调整参数去拟合该规则,不支持关于世界知识或通用推理的结论。规模变大之后需要新的评估,而不是把玩具实验的成功按比例外推。
29.3 SFT:把训练例子换成期望的交互
监督微调,supervised fine-tuning,简称 SFT,给模型提供输入任务和示范回答。底层仍可使用 token 交叉熵,但数据现在描述的是希望模型在交互中如何回答。它改变的是模型输出行为的训练分布,而不一定需要重新设计 Transformer。
设提示为 p,示范回答为 y₁…y_M。只在回答位置计算损失时,目标为
提示 token 仍参与前向计算,回答可以注意到它们;只是提示位置不作为本次要模仿的输出目标。多轮对话也应明确哪些 assistant 段落参与训练、用户段落和 padding 如何屏蔽。一个 mask 错位就可能让模型学到错误角色边界。第 28 章的 completion mask 推导,在这里可以直接复用。
举一个本书自拟的数据例子。提示是“把这条报错归类为网络、权限或输入错误,并返回一个标签”,回答是“权限”。如果示范里有的回答只给标签,有的长篇解释,有的忽略给定类别,模型就会接收到相互冲突的目标。所谓数据质量,在这里不是抽象的“高级文本”,而是示范是否准确、任务定义是否一致、异常情况是否覆盖。
SFT 的优点是目标直观,可以直接检查示范是否值得模仿。成本在于高质量示范需要制作和审查;少量狭窄样本还可能让模型过拟合固定措辞。它也不自动保证事实正确或遵守所有边界。训练集没覆盖的输入、互相矛盾的指令和分布外任务,都需要独立测试。将 SFT 与偏好反馈结合的历史路线,可以参见 InstructGPT 论文。
29.4 偏好反馈回答的是“哪一个更好”
写一份理想答案很难,比较两份现有答案有时容易一些。给同一提示 p,标注者更偏好 y⁺ 而非 y⁻,就得到一条偏好数据。偏好需要明确评判标准:准确、相关、易读、遵守要求、安全等维度可能冲突,不同标注者也可能不同意。
一种经典做法是训练奖励模型 r_φ(p,y),把提示和回答映射到一个标量分数。φ 是奖励模型的参数。用分数差来建模偏好概率:
σ 是 sigmoid,定义为 σ(d)=1/(1+exp(−d)),把任意实数映射到 0 与 1 之间。若两份回答分数相同,偏好概率为 1/2;想让被选回答更可能胜出,就应增大两者分数差。这不是把“人类价值”测成客观刻度,而是在拟合特定数据集上的比较结果。奖励模型也会犯错,尤其可能把长度、语气或某些表面模式当成质量线索。
下面给出一个原创标量推导。令 d=r⁺−r⁻,损失为 log(1+e^(−d))。对 d 求导得到 σ(d)−1。在 d=0 时梯度为 −1/2,梯度下降会增大 d;当 d 已很大时,梯度接近 0。这解释了这类损失为何鼓励正确排序,也说明它关心分数差而不是分数绝对值。
29.5 RLHF 为什么还需要约束
强化学习中的“策略”在这里就是生成回答的模型 π_θ。它采样回答,获得奖励,再调整生成倾向。若只追求奖励模型分数,模型可能学会钻奖励模型的空子,产生高分但并不真正有用的答案。因此经典路线会约束新策略不要过度偏离参考模型。
一个用于理解的目标为
β 控制偏离成本,π_ref 是参考策略。对离散分布 P、Q,KL 散度为 D_KL(P∥Q)=Σ_y P(y)log(P(y)/Q(y))。P(y)=0 的项按极限记为 0;若 P(y)>0 而 Q(y)=0,散度为无穷,因此使用这个表达式需要注意支持集。它度量分布差异,在这里抑制为了奖励而剧烈改变原有行为。公式展示的是概念目标,不是可直接替代完整训练代码的一行实现;实际算法还要处理采样、优势估计、价值函数、序列长度和数值稳定。
2023 年演讲语境中的经典 RLHF 路线与 PPO 有关。PPO 用裁剪等机制限制一次策略更新的变化;它与奖励目标里的 KL 约束承担相关但不完全相同的角色。PPO 原论文。本书不实现完整 PPO,也不把这一历史路线描述成所有后来助手唯一使用的方法。
把三种训练放在同一张表里,差别会更清楚。
| 阶段 | 主要数据形态 | 直接优化的信号 | 能直接检查什么 | 不能据此保证什么 |
|---|---|---|---|---|
| 预训练 | 连续文本 | 下一个 token 的损失 | 留出文本预测能力 | 自动成为可靠助手 |
| SFT | 提示与示范回答 | 示范回答的 token 损失 | 模仿任务格式与行为 | 所有新问题都准确 |
| 奖励模型 | 同提示下的回答比较 | 偏好排序损失 | 与标注比较的一致程度 | 分数等于真实效用 |
| 偏好驱动策略优化 | 采样回答及反馈 | 奖励与约束后的目标 | 定义好的行为评估 | 不会奖励投机或退化 |
29.6 训练管线不等于产品保证
一个模型经过这些阶段后,产品仍要决定如何提供工具、保留上下文、检索资料和检查输出。训练可以影响“模型倾向怎么说”,系统设计还要决定“它实际能做什么”。模型给出一个转账建议与系统真的执行转账,风险完全不同;把这两层混在一起会使评估失去对象。
本章没有沿用 2023 年演讲里可能出现的 GPU 数量、训练时长或商业成本作今天的估算。资源需求随模型、数据、硬件和实现变化,本书没有取得可供当前估算的完整条件。我们能够验证的是:这些训练阶段使用不同反馈信号,因而必须分别定义数据、目标与评估。
练习与答案
以下为本书补充练习。
- SFT 中提示位置不计损失,回答是否仍能使用提示信息?
- 奖励模型给两份回答都加上常数 10,偏好概率改变吗?
- 为什么更高的奖励分数不一定意味着回答更好?
- 如果你只想修改输出格式,为什么仍需要留出评估样本?
答案:能,提示仍在前向上下文中;不变,因为分数差不变;奖励模型只是有误差的代理,策略可能利用它的盲点;训练集上的格式正确可能只是记忆,留出样本用来检验新输入及异常情况。
本章来源与验证边界
- State of GPT 官方视频:身份、历史语境和主题范围。
- GPT-3 论文:基础语言模型与上下文学习背景。
- InstructGPT 论文:示范、偏好反馈与助手训练的历史实例。
- PPO 论文:策略优化方法的原始来源。
本章公式例子与教学推导为原创解释,没有执行 SFT、奖励模型或 RLHF 训练,也没有测量现有商业助手的内部训练过程。