主题
第 27 章 一次更新到底看了多少数据:AdamW、累积与多卡
把同一个网络搬到更多 GPU 上,并不会自动得到同一个训练过程。若损失平均方式变了,学习率变了,或者每个进程重复读取同一批 token,代码仍可能运行,却已经偏离原实验。要复现训练,必须同时说明“每次前向看多少数据”和“每次参数更新看多少数据”。
本章沿着课程的超参数、梯度累积和 DDP 部分,先建立一个明确的目标:每次更新最小化同一组 token 的平均负对数概率。所有缩放和通信都围绕这个目标展开。课程固定训练实现。
27.1 AdamW 的状态比参数本身多
设第 t 次更新前的参数为 θ,当前梯度为 g_t。Adam 为每个参数维护两个同形状的状态:梯度的一阶移动平均 m_t,以及平方梯度的移动平均 v_t:
平方和乘除都是逐元素操作。因为初始状态为零,早期均值会偏小,于是用 m̂_t=m_t/(1−β₁ᵗ)、v̂_t=v_t/(1−β₂ᵗ) 修正。忽略其他实现细节,AdamW 的更新可以写为
η_t 是学习率,λ 是权重衰减系数,ε 是分母中的小正数。权重衰减单独作用于参数,不先混进梯度再交给自适应缩放,这也是 AdamW 中 W 所强调的区别。上述公式用于理解一般无 AMSGrad 的情况;具体运行以固定版本 PyTorch 的 AdamW 实现为准。
课程使用 β₁=0.9、β₂=0.95、ε=10⁻⁸、weight_decay=0.1。ε 不是“加不加都一样”的防报错符号。当 v̂ 很小时,ε 会显著影响分母,限制自适应除法的放大幅度;它并不规定参数更新的最小幅度。复制实验设置时,不能只复制学习率,遗漏这些值。Adam 的两个状态也解释了为什么“参数只有几百 MB”不等于训练只需几百 MB:梯度、优化器状态、激活及临时张量都需要空间。
参数分组同样重要。固定代码对维度不少于 2 的可训练参数做权重衰减,对一维参数不衰减。因此矩阵和 embedding 参与衰减,偏置与 LayerNorm 的缩放、平移参数不参与。这是该实验的约定,不是张量维度决定正则化方式的数学定理。共享参数通过 named_parameters 去重后分组,不能把同一份 embedding 又放进另一组。
fused AdamW 把若干更新操作合并执行,主要减少调度与中间读写成本。固定代码检查 API 是否支持 fused,同时要求 device_type 为 cuda;本书 CPU 测试不启用 fused。若没有目标 GPU,就只能验证分组与更新数值,不能声称复现了 fused 优化器性能。
27.2 先小步走,再逐渐减速
固定课程设置的最大学习率为 6×10⁻⁴,最小学习率为它的十分之一,预热 715 次更新,总更新次数为 19073。设 i 从 0 开始计数,W 为预热次数,S 为衰减终点,则
预热使最开始几次更新较小,避免随机初始化阶段马上进行大幅度修改;余弦衰减让后期逐渐缩小更新尺度。这是具体训练方案,不是所有模型都必须遵守的日程。这里的“步”是 optimizer.step 的次数,不是微批次次数。
为什么分子有 i+1?因为循环从 0 开始,作者希望第一步使用非零学习率。i=W−1 时已经到峰值;i=W 时进入余弦分支,也仍为峰值。整个训练循环是 range(max_steps),最后执行的索引是 S−1,因此并未执行 i=S 那一步,最后一个实际学习率只是非常接近下限。复现日志时应按实际索引比较,别把文字上的“19073 步”错当成索引 19073。
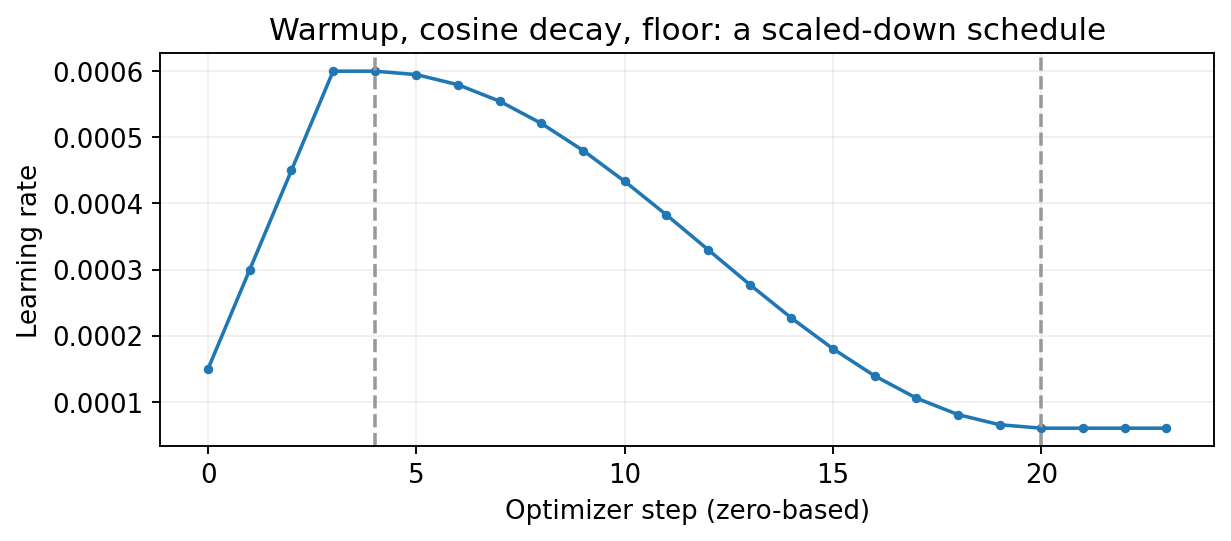
为了在几秒内检查边界,本书用 W=4、S=20 保留同一公式。实际输出:i=0 时为 0.00015;i=3、4 时均为 0.0006;i=12 时为 0.00033;i=20、21 时均为 0.00006。测试同时检查预热结束和衰减结束,不能只画一条看起来平滑的曲线。
课程也讨论过批大小日程,而最终固定脚本使用恒定的总 token batch。不能把论文中或讲解中提到的所有训练策略都当成最终脚本已经启用。这里以执行代码为准,历史背景可参照 GPT-3 论文。
27.3 梯度累积的分母从哪里来
设一次目标更新要处理 N 个有效 token,单个 token 的损失为 ℓ_n(θ)。我们希望优化
显存不足时,把这些 token 分成 K 个微批次,第 k 份含 n_k 个有效 token。其均值损失为 L_k=(1/n_k)Σℓ_n。总损失就应当是
这就是每次 backward 前缩放损失的依据。若所有微批次大小相同,n_k/N=1/K,课程中的 loss/grad_accum_steps 正好成立。若最后一份更小,或每份 padding mask 后的有效 token 数不同,直接除以 K 就会偏离目标。
举个有数值的反例:第一份有 2 个 token,平均损失为 1;第二份有 3 个 token,平均损失为 3。正确总体均值是 (2×1+3×3)/5=2.2;简单平均两份均值则为 2。这个差别同样会出现在梯度上。
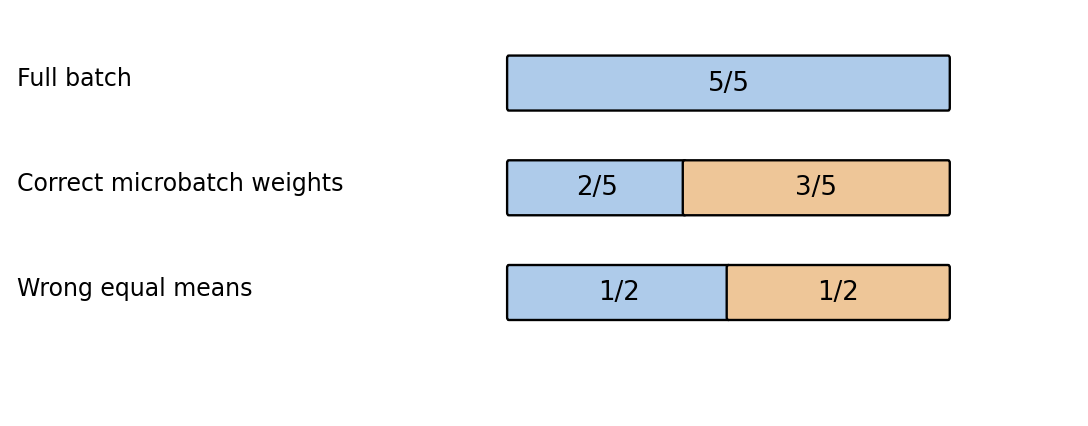
本书用同一个 tiny GPT,把 5 条等长序列拆成 2 条和 3 条。完整批次反向与按 2/5、3/5 加权的累积梯度,最大误差为 5.55×10⁻¹⁷;错误地各除以 2,最大误差为 0.052799。上游 play.ipynb 另用 16→32→1 的小 MLP 比较四样本均方误差与四次单样本累积。本书按同一问题独立重写、在模型构造前固定种子,float64 最大梯度误差为 1.67×10⁻¹⁶。它验证等大小微批次除以 4 的情形,前面的 2/5、3/5 测试再扩展到不等大小。这个反例比一句“记得缩放 loss”更有用:它告诉你该缩放到什么目标,以及何时不能照抄课程的一行代码。
一次完整更新的顺序是:清零一次梯度;逐份前向、计算缩放后的损失并反向;所有微批次结束后做一次裁剪;设定本次学习率;调用一次 optimizer.step。若每个微批次都清零,就只剩最后一份的梯度。若每个微批次都 step,则参数在批次之间已经变化,也不再等价于大批次更新。
这种等价还需要条件。梯度是在同一份参数上计算的,模型操作不会依赖整个批次的统计,随机性的处理可比较。含 BatchNorm 的模型会使用不同的微批次统计,不能仅凭加权均值保证与完整批次一致。GPT 的 LayerNorm 按每个位置的通道计算,不依赖其他样本;不过 dropout 等随机操作仍会影响逐位一致性。本书实验没有 dropout,使用 float64 比较代数正确性。
27.4 裁剪是在限制哪一根向量
把所有参数梯度摊平成一根大向量 g,二范数为 ||g||₂=√Σg_j²。阈值 c=1 时,裁剪近似执行
实际实现会用小量避免除零。它限制的是全局梯度范数,不是把每个元素截断到 [−1,1]。例如 g=(3,4),范数为 5,裁剪后为 (0.6,0.8),方向保持不变。逐元素截断则得到 (1,1),方向已经改变。
裁剪应该在累积和跨进程同步之后进行。若先裁剪每一小份,非线性的裁剪操作一般不能与求和交换:clip(g₁+g₂) 不等于 clip(g₁)+clip(g₂)。课程日志打印的 norm 是裁剪前的范数,它可以帮助判断梯度是否频繁触及阈值。裁剪不修复 NaN;如果梯度已经非有限,需要寻找源头而不是靠阈值掩盖。
27.5 DDP 复制模型,分配数据,再平均梯度
DDP 是分布式数据并行。通常每个进程维护同样的模型与优化器状态,读取不同数据,计算自己的梯度,然后同步。RANK 是全局进程编号,LOCAL_RANK 是当前机器上的本地编号,WORLD_SIZE 是全体进程数量。固定脚本使用 torchrun 启动,CUDA 上采用 NCCL 后端,每个进程绑定 cuda:LOCAL_RANK。rank 0 承担主要日志和 checkpoint 写入。
假设有 R 个进程,每个进程有相同数量的有效 token,DDP 的梯度平均就是
若每个进程又累积 K 份等大的微批次,本地先按 1/K 缩放,跨进程再平均,最终系数为 1/(RK),恰好对应全局均值。因此已经由 DDP 平均时,不应再手工除以 R。相反,如果各进程有效 token 数不同,直接平均本地均值又会产生与前一节相同的加权问题,需要按全局有效 token 数推导缩放。
课程目标总批量为 524288 token,B=64、T=1024。每次前向处理 65536 token;单进程时 K=8,8 个进程时 K=1。关系为
若 R 不能整除这个预算,脚本断言失败是好事;静默向下取整会改变每次更新的样本数。数据加载器还必须让不同 rank 读取不同位置。复制同一份数据到每张卡,虽能算出梯度,却没有获得更多独立训练样本。
为了避免每个微批次都通信,固定代码只在最后一个微批次启用 require_backward_grad_sync。仓库勘误特别指出:这个标志也影响前向,因此必须在相应前向之前设置。使用官方 no_sync 上下文时,也要把前向包括在上下文内。单看 backward 前的一行赋值,很容易漏掉这一点。仓库勘误。
本书用两个独立模型在 CPU 上模拟两个 rank:每个模型处理两条序列,分别求梯度,再算术平均,与四条序列一次反向比较。误差为 5.55×10⁻¹⁷。这证明本例的平均关系,没有启动多进程、没有 NCCL 通信,也没有测量 DDP 性能。
27.6 别让分布式日志制造另一个实验
模型的梯度同步与日志的数值汇总是两件事。loss_accum.detach() 用来累计日志值,避免为日志保留计算图;跨进程 all_reduce AVG 得到等量样本时的平均损失。统计分类准确率时则应 SUM 正确数和总数,最后相除,而不是简单平均各进程准确率,除非各进程样本数严格相同。
只让 rank 0 保存文件,可以避免多个进程同时覆盖同一路径。但固定脚本创建日志文件、以写模式清空日志的部分并未全部置于 master_process 条件内,这是教学脚本需要加固的地方。正式运行应让单一进程创建或清理共享输出,必要时同步其他进程;发生异常时还要保证进程组能够清理。教学代码展示了核心机制,没有承担完整训练平台的故障恢复责任。
练习与答案
以下为本书补充练习。
- B=8、T=256、R=4、K=16 时,一次更新处理多少 token?
- 两个 rank 分别处理 4 个和 8 个有效 token,应怎样合并各自的平均损失?
- 为什么每个微批次裁剪一次,通常不等价于累积后裁剪一次?
- 如果恢复模型参数后忘记恢复 AdamW 状态,学习率和随机种子都没变,是否严格续训?
答案:131072 token;按 1/3 和 2/3 加权,且梯度同步的系数也需与这个目标一致;裁剪是非线性操作,不能任意与相加交换;不是,移动平均状态已经丢失,后续更新不同。
本章来源与验证边界
- 固定 train_gpt2.py:优化器分组、超参数、日程、累积和 DDP。
- 固定 README 勘误:同步标志位置等修正。
- PyTorch v2.6.0 AdamW 源码、DDP 源码与文档字符串:版本固定的实现语义。
- 真实 CPU 结果:加权累积、日程与 DDP 数学模拟。
这组实验没有证明课程超参数在其他数据、模型或硬件上最优。更换 token 预算或数据分布后,应该重新做小规模检验,而不是把复现配置当成通用配方。