主题
第 15 章 把八个字符逐层合并:层接口与树形上下文
上一部分的 MLP 把所有历史字符一口气拼成长向量,再交给第一层。上下文从 3 个字符扩到 8 个,输入宽度就从
这就是课程第 6 讲搭建的树形模型。它与 WaveNet 的层级感受野有联系,但没有实现论文的完整门控、残差、跳连和音频系统。先把这个较小结构做对,下一章再明确它怎样对应卷积。第 6 讲官方说明
15.1 用固定长度上下文预测一个字符
先保留原来的数据定义。每个训练样本是一个历史窗口 anna、上下文长度 8 为例,窗口依次是 ........ → a、.......a → n、......an → n、.....ann → a、....anna → .。
每增加一个真实字符,窗口左移一格。上下文长度变了,标签定义并没有变。所有输入都来自当前目标之前,因此单样本模型不会偷看到待预测字符。按完整单词划分训练、验证、测试,再各自切窗口,能避免同一个单词的重叠窗口被随机分到训练和验证两边。
课程 notebook 先查看词数、最长词、字符映射,再打印前若干窗口。它们不是可省略的装饰输出:词表是否包含终止符、窗口是否右移正确、最长词是否被截断,都可以在这里查出来。官方 Colab 另有一个下载 names.txt 的单元;本书的小实验内置 12 个词,不依赖那个可变的 master 下载地址,也不把这 12 个词当作完整课程数据。
15.2 六种小类,分别负责一件事
examples/part2/layers.py 实现六种教学类。它们遵循同一个约定:调用对象完成前向,parameters() 返回该对象需要梯度更新的张量。能统一遍历以后,训练循环便不需要知道模型到底有几层。
| 类 | 输入到输出 | 参数 | 主要职责 |
|---|---|---|---|
Embedding(V,D) | 整数索引 [...,] → [...,D] | 查字符向量 | |
Linear(F,H) | [...,F] → [...,H] | 权重与可选偏置 | 在最后一维做相同仿射变换 |
BatchNorm(H) | [...,H] → 同形状 | gamma、beta | 按最后一维通道统计前面的轴 |
Tanh | 任意浮点形状 → 同形状 | 无 | 逐元素非线性 |
FlattenConsecutive(n) | 无 | 拼接相邻 n 个位置 | |
Sequential | 首层输入 → 末层输出 | 子层参数集合 | 按顺序组合 |
Linear 对三维输入仍然可以直接 x @ weight。比如输入
参数发现也值得认真检查。若忘记把 embedding 表放进 parameters(),前向照样能跑,梯度也可能存在,但优化器永远不会更新它。若共享同一个张量却把它加入列表两次,手写 SGD 会重复更新。本书的容器用张量身份去重。原课程较简单的列表展开适用于没有共享参数的那套结构;这项去重是本书补充。
这些类不是完整 nn.Module 的替代品。它们没有注册式参数管理、state_dict、自动设备搬移、hooks 或完整嵌套模块系统。理解了它们的职责后,转向原生 nn.Module、nn.Parameter、nn.Sequential 就更容易判断框架替我们管理了什么。PyTorch v2.6.0 Module 源码
15.3 FlattenConsecutive 不是平均池化
假设 FlattenConsecutive(2) 应输出两个位置:
python
B, T, C = x.shape
if T % n:
    raise ValueError('time dimension must be divisible by group size')
x = x.reshape(B, T // n, C * n)
if x.shape[1] == 1:
    x = x.squeeze(1)
总元素数保持为 T//n 不是允许随意丢掉余数:不能整除时必须拒绝、补齐或采用另一个明确设计。本书选择拒绝。最后只剩一个时间位置时,squeeze(1) 把 squeeze():当
课程使用 view,其前提是现有 stride 布局允许这个视图。切片、转置后的张量可能不连续;本书使用 reshape,必要时允许复制。配套测试用 torch.randn(2,4,6)[:,:,::2] 构造真正不连续的输入,先断言 not is_contiguous(),再把结果与逐组 cat 的值对照。只验证输出 shape,不足以保证分组顺序正确。
15.4 三层树,形状怎样一步步变
本书小实验使用词表大小
python
Sequential([
    Embedding(8, 4),
    FlattenConsecutive(2), Linear(8, 12, bias=False), BatchNorm(12), Tanh(),
    FlattenConsecutive(2), Linear(24, 12, bias=False), BatchNorm(12), Tanh(),
    FlattenConsecutive(2), Linear(24, 12, bias=False), BatchNorm(12), Tanh(),
    Linear(12, 8),
])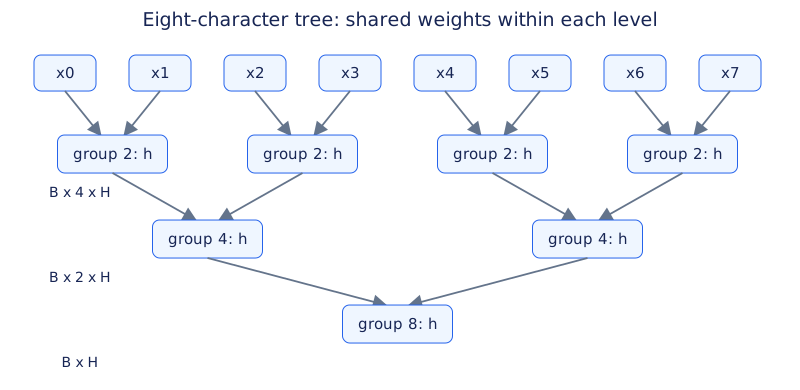
| 阶段 | 输出形状 | 该位置能看到的原始字符数 |
|---|---|---|
| 字符索引 | 1 | |
| embedding | 1 | |
| 第一次拼接 | 2 | |
| 第一组 Linear、BN、Tanh | 2 | |
| 第二次拼接 | 4 | |
| 第二组变换 | 4 | |
| 第三次拼接,压掉长度 1 的轴 | 8 | |
| 第三组变换 | 8 | |
| 输出分类层 | 8 |
表中“能看到”的局部树形关系指 Linear 与非线性组成的局部路径;训练 BN 还会通过共享批统计量耦合不同位置和样本,第 16 章会说明为什么讨论严格因果关系时必须把它单独处理。推理 BN 使用固定统计量,不再增加这样的输入依赖。
手算参数量可以抓到不少建模错误。embedding 为
15.5 轴写错,程序也可能顺利训练
原来的 BN 只接收 dim=0 求统计量。现在第一组激活是
取最小的例子:dim=0 求均值,得到位置均值 ([1,12]);对 (0,1) 求均值,才得到共享通道均值 6.5。
| 实现 | 统计对象 | 均值形状 | 这个例子的均值 |
|---|---|---|---|
旧的 mean(0) | 每个位置单独跨批 | 1、12 | |
修正的 mean((0,1)) | 跨批和时间共享通道 | 6.5 |
前者在数值上能广播,loss 也可能下降,所以没有异常堆栈提醒你。它并非对所有任务都毫无意义,但不符合这里打算实现的“共享通道 BN”。运行统计量还可能因此携带位置维度,使训练与不同形状推理产生难以察觉的行为差异。课程通过阅读文档和逐层查看 shape 找到这一错误。
我们的教学层约定通道在最后;原生 nn.BatchNorm1d 的三维输入约定是
15.6 训练循环没有换,模型内部换了
数据进来以后,统一调用 model(Xb) 得到
本书小实验只用 8 个训练词、2 个验证词、2 个测试词,分别切成 42、11、10 个样本。训练 400 次更新,批大小 16,seed 2026;前 300 次学习率 0.1,后 100 次为 0.03。输出层权重先乘 0.1,沿用降低初始置信度的做法。训练结束后冻结运行统计量,结果如下:
| 划分 | 平均交叉熵 |
|---|---|
| train | 0.459759 |
| dev | 2.001545 |
| test | 2.565572 |
训练样本很少,词表中的 m 还只出现在保留的词中,模型未在训练输入里学到它的使用。因此这些数字主要展示评估流程与明显的泛化差距,不能与完整姓名数据、27 类模型的 loss 排名。这里 test 只在固定实验完成后报告一次,没有拿它选择宽度或学习率。
seed 2036 采样得到 tania.、animtm.、tania.、nina.、anna.。其中有训练词,也有不自然组合,这正适合提醒我们:能生成熟悉词形不等于学到了稳健分布。采样设置最多 20 步,防止一个还没学好终止符的小模型让脚本无限循环;若达到上限,应视为截断,不伪装成自然终止。
训练检查点的批损失也不是单调的:本次第 300 步检查为 0.405144,第 400 步为 0.532451。两个检查点抽到的批次不同,不能据此断言模型退化。要比较性能,应看同一个固定评估集、同一个 eval 模式下的损失。
15.7 练习与答案
- 补充。 将上下文改成 16,仍两两合并到一个位置,需要几层分组?最后是否还可以直接接分类层?
- 补充。 忘了把 embedding 加入参数列表,哪些检查会发现?
- 补充。 用上面的 rank-3 数值例子,分别写出按
(0,)和(0,1)标准化的结果,说明两者表达的假设差别。
第一题需要四次分组:16→8→4→2→1;每次 Linear 输入宽度按拼接后的通道数调整,最终单位置表示可以接分类层。第二题中 loss 可能仍下降,最直接的检查是参数总数、参数身份列表,以及更新前后 embedding 的差值。第三题按位置统计会分别中心化两组 ([0,2]) 与 ([10,14]),而共享统计会中心化 ([0,10,2,14]);用统一的 correction 与 eps 才能公平比较数值。
完整可运行入口仍为 examples/part2/experiments.py,本章函数为 train_tree();层定义独立在 layers.py。这套结构把“上下文如何组合”变成了清楚可替换的模块,但还没有消除相邻预测窗口的重复计算。下一章从这里引出卷积。
来源与范围
- 第 6 讲视频与固定 notebook:数据窗口、六类接口、树形网络、BN 轴错误与修正、训练与采样。
- 官方 Colab:与仓库源码的主要差异为标题链接及数据下载单元。
- 本书容器去重、非连续张量测试、12 词实验与参数量核对属于教学补充;并非课程原始运行成绩。