主题
第 18 章 让当前位置挑选有用的过去
考虑 the cat sat 中的最后一个位置。只看 a 可能不够,模型还想知道前面出现了什么词。最直接的办法是把过去的向量求平均。但“每个位置同等重要”这个约定太死板。注意力要学习的,就是当前这道预测题该多看谁、少看谁。
本章按原课程的四步走:循环平均、矩阵平均、softmax 权重、由内容决定的权重。它们的共同操作始终是加权求和。来源是 GPT 官方 notebook 和 固定课程 Head 实现。
18.1 把三个位置的平均写成一次矩阵乘法
输入特征记作
只对当前位置及过去求平均,结果依次为 (2,0)、(1,2)、(2,2)。循环版可写成 out[t] = X[:t+1].mean(0)。下面这个权重矩阵做同一件事:
矩阵乘法的第
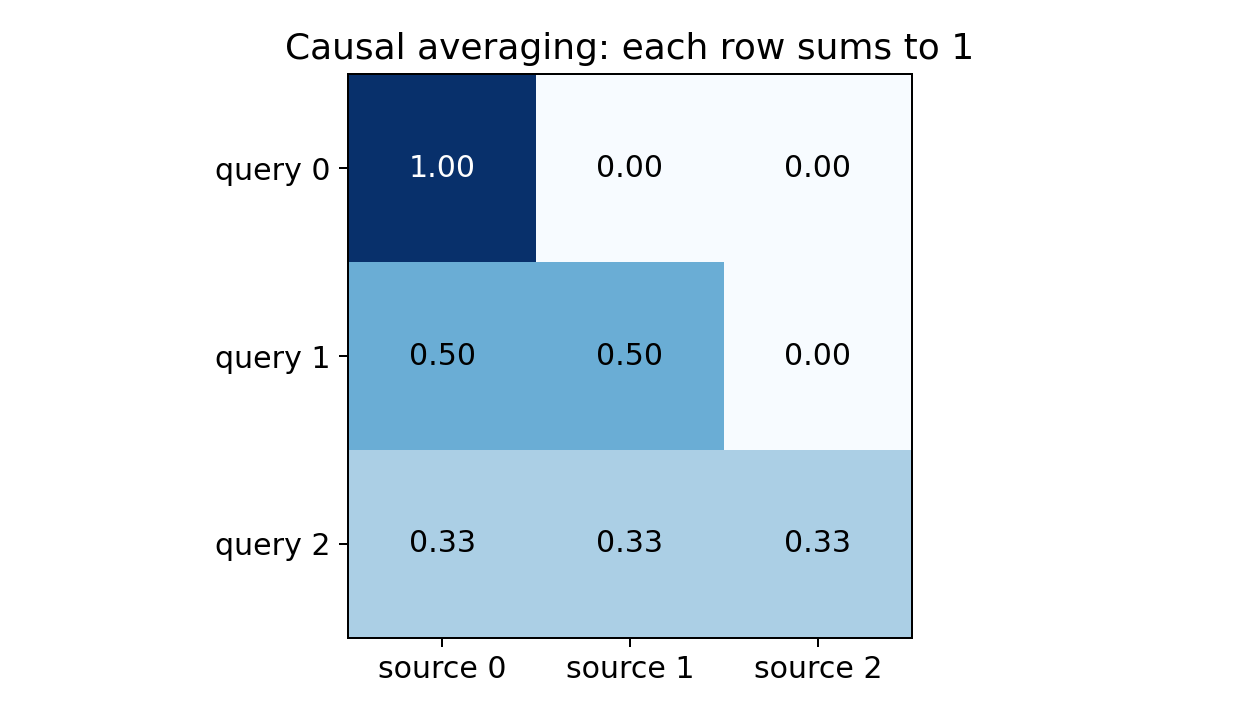
A 的形状是 (T,T),X 是 (B,T,C)。PyTorch 会把同一个 A 广播给每条序列,结果为 (B,T,C)。广播是复用规则,不是在 batch 内求平均。本书实测循环平均与矩阵平均在 float64 下最大差异为
18.2 softmax 把允许的分数转成权重
可以先构造分数矩阵
第
python
scores = torch.zeros(T, T)
allowed = torch.ones(T, T, dtype=torch.bool).tril()
weights = scores.masked_fill(~allowed, float('-inf')).softmax(dim=-1)
遮罩必须在 softmax 之前生效。先归一化再把未来位置置零,会使剩余权重的和小于 1;即使重新归一化可以恢复结果,也多做了没有必要的计算。每行至少要保留一个位置,否则整行负无穷的 softmax 没有有效分母,会产生 NaN。因果自注意力通常保留对角线,即允许当前位置看自己。
原视频描述有两处作者已公开纠正:不能通信的是未来 token;缩放所用的维数是每个头的 head_size。下面使用修正后的形式。课程 description 的 Corrections
18.3 Q、K、V 是三种不同用途的投影
一个位置既要提出需求,也要让别人判断它有什么信息,还要提供被汇总的内容。用三个线性映射分别得到 query、key、value,简称 Q、K、V。它们都来自同一份输入,所以称为“自注意力”。
设单头宽度为
这三个结果的形状都是 (B,T,d)。PyTorch nn.Linear(C,d) 存储的 weight 形状其实是 (d,C),前向内部用其转置;不要把数学记号和存储布局混为一谈。
第
这里的转置只交换最后两个轴。(B,T,T),(B,T,d)。
“query 提需求、key 给线索、value 供内容”只是帮助分工的说法。模型没有预先获得“这个头专门找动词”的标签;三套投影通过最终预测损失共同训练。注意力权重可以检查,但不能单凭某个权重很高就断言模型给出了完整的因果解释。
18.4 为什么除以根号 d
假设 query 和 key 的各个分量相互独立,均值为 0、方差为 1。点积是
这些独立性是假设,不是训练后的保证。缩放的用途是控制初始及常见情况下的数量级,而不是保证每个注意力行都均匀。若把分数整体放大很多,softmax 更接近 one-hot;对已极接近 0 或 1 的概率,许多导数会变小,学习可能变难。原 notebook 用同一组 logits 乘 8 前后的分布对比展示了这一点。Attention Is All You Need,第 3.2.1 节
注意这里除的是每个头的
18.5 为什么还要给位置
没有位置特征、没有遮罩的自注意力对输入排列具有相应的置换等变性:若把输入行重新排列,输出也跟着重排。它可以比较内容,却没有单独的绝对位置坐标。因果遮罩提供了先后关系和可见范围,但不能替代所有顺序信息。
本课为每个位置学习一个向量 (T,C) 的位置表沿 batch 广播。这样相同字符出现在第 2 位和第 7 位时,送入后续层的特征不同。学习式位置表只有预先分配的
18.6 编码器、解码器与交叉注意力,区别在哪里
若任务允许完整读取输入,例如把一整句法文编码后再翻译,输入侧的 self-attention 可以双向访问,不加因果遮罩。输出侧生成英文时则必须遮住未来。交叉注意力的 Q 来自正在生成的输出表示,K 和 V 来自编码器结果;两边长度可以不同,所以其分数矩阵为 (B,T_out,T_in)。
本书的小 GPT 只含带因果遮罩的 self-attention,没有额外的编码器,也没有交叉注意力。称它 decoder-only 是架构习惯用语,不表示它一定包含原论文完整 decoder 中的所有模块。原论文结构图及第 3 节
18.7 用反例证明遮罩真的起作用
examples/part3/check_attention.py 不只检查张量形状,还做了三种验证。第一种把手写注意力与 PyTorch 2.6 的 scaled_dot_product_attention(..., is_causal=True, dropout_p=0.0) 比较,float64 最大误差为 torch.autograd.gradcheck,以有限差分核对 Q、K、V 的梯度,结果通过。第三种改变未来位置的 value,检查更早输出是否变化。
本次运行中,带遮罩的前缀变化严格为 0;去掉遮罩后前缀最大变化为 5.480078。完整两层小 GPT 的未来字符替换检查也为 0。这比“loss 能下降”更能定位因果性问题:错误模型同样可能轻易降低训练损失。
测试使用 eval 模式或零 dropout,否则两次随机遮挡不同,输出差异会掩盖真正的问题。PyTorch 的函数式 SDPA 不会因外层模块进入 eval 自动把传入的 dropout_p 清零,调用者必须自己处理。PyTorch 2.6 SDPA
练习与答案
- 补充题: 第三个位置对前三项分数为
[0,log(2),0]时,注意力权重是什么?若 value 分别为 2、4、10,输出多少? - 补充题: 为什么
softmax(dim=1)不一定等于本章所需操作? - 补充题: 用同一 Q、K,把 V 全部加上常量向量
,无 dropout 时输出怎样变?
答案。 第一题权重为 [1/4,1/2,1/4],输出是 5。第二题在 (B,T,T) 中维度 1 是接收位置,正确归一化维度是来源位置,即最后一维;四维多头张量里写死 1 更会混到头轴。第三题每行权重和为 1,所以输出也加
本章主要来源:Attention Is All You Need;PyTorch 2.6 SDPA。实现和实验差异已在对应小节注明。