主题
第 22 章 BPE 学的是一张有先后顺序的合并表
现在输入是一串 0–255 的字节编号。我们想把经常相邻的两项用一个新编号代替。比如语料里反复出现 ab,就给它一个新 token。随后 ab 又可能与后面的 c 合并成 abc。这样一点点扩充词表,就得到 Byte Pair Encoding,简称 BPE。
本章对应 minbpe 官方练习第一阶段。完整实现是 examples/part3/byte_bpe.py,测试是 check_bpe.py。算法参考的 minbpe 为 MIT 许可,代码包保留其授权声明;正文解释和测试语料为本书另写。
22.1 统计相邻对时允许重叠,替换时却不能重叠
给定编号列表 [1,1,1],相邻对 (1,1) 出现两次:位置 0–1 和位置 1–2。统计时两次都算。真正替换时,不能同时使用中间那个 1 两遍。本书采取从左到右、互不重叠的替换,结果为 [256,1]。
python
counts = Counter(zip(ids, ids[1:]))对某个选中的 pair,扫描指针 i 从左到右移动。当前项和下一项匹配,就输出新编号并前进 2;不匹配就输出当前项并前进 1。替换保持了底层字节的顺序和内容,只改变它们的分组。
因此“某对出现两次”不一定表示这轮序列长度正好缩短 2,重叠对是反例。这个差异常被模糊的“把所有出现都替换”掩盖,应把具体扫描规则写进实现。
22.2 训练循环同时维护 merges 和 vocab
初始词表为 vocab[i] = bytes([i]),其中
merges 回答“这两项可以何时合并”,vocab 回答“这个编号还原成哪些字节”。二者用途不同,不能只留最终显示出来的字符串。
假设用 ASCII 文本 ababac 训练,初始编号为 [97,98,97,98,97,99]。第一次 (97,98) 出现 2 次,合并到 256,得到 [256,256,97,99];新词表项 256 对应 b'ab'。后面若有同频对,就必须采用明确的 tie-break。本书按编号对的字典序选最小者;minbpe 的简单计数字典实现倾向采用首次出现顺序。两者都可以是确定性的 BPE,但可能训练出不同词表,不能宣称训练结果逐项相同。
目标词表大小
BPE 的贪心选择只优化当前一步常见相邻对,不保证全局最优压缩,也不以语义作为训练目标。它能合出单词、词缀、空白,或多字节字符的一部分,取决于语料与预切分约束。子词 BPE 原论文;minbpe base.py
22.3 编码新文本时,不再数谁出现得最多
训练结束后,合并规则固定。编码新文本要反复寻找“当前出现、且训练时最早学到”的可合并对。这一先后次序叫 merge rank。我们的编号按训练顺序递增,因此较小的新编号同时代表较早 rank;其他格式不一定这样组织,不能普遍把 ID 当 rank。
python
candidates = [p for p in zip(ids, ids[1:]) if p in merges]
if not candidates:
    break
pair = min(candidates, key=merges.__getitem__)
ids = merge(ids, pair, merges[pair])
为什么不用新文本中的最高频对?因为那会重新训练一套局部决策,使相同文本上下文变化时采用不同的规则,也不再遵循固定 tokenizer 的定义。语言模型的输入协议必须稳定。
更容易误写的是最长匹配:词表里有 abc,就直接把 abc 吃掉。它未必符合 rank 顺序。手工构造如下合法合并图,并按顺序赋予 rank:b+c→256、a+b→257、257+c→258。这是一份用于测试编码器的规则文件,不声称它能由同一语料按本书的贪心 train 顺序训练得到。词表确实含 abc,但输入 abc 时先执行 rank 更早的 b+c,结果是 [97,256],无法再形成 a+b。本书测试核实了这个反例。
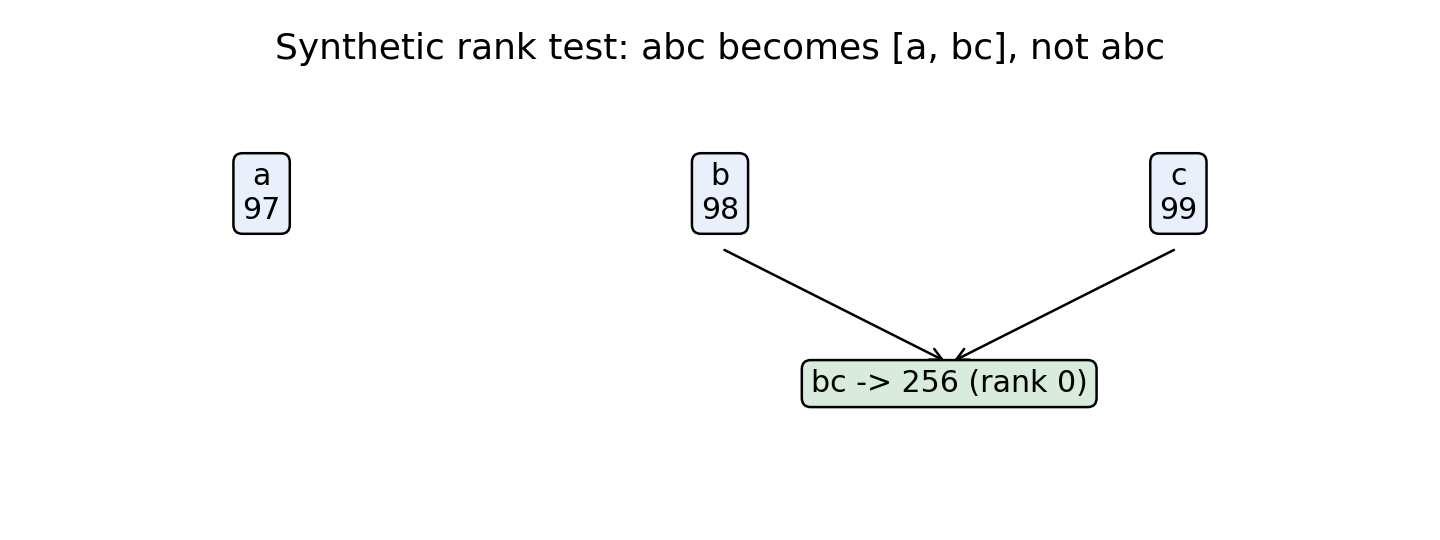
这也是为什么“词表里存在某个长 token”和“那段字符串单独编码时一定得到该 token”不是同一个命题。推理路径由完整规则决定。
22.4 解码容易,但可逆性的方向要说清楚
解码时,按顺序取 vocab[id] 对应的字节片段,拼接,再 UTF-8 解码。不需要倒着执行合并,更不需要知道原始训练文本。
对于本书支持的良构 Unicode 字符串,目标不变量是:
反过来不总成立。若随手给出一串合法 token ID,它可能不是编码器选定的规范切分。同一段字节可以由多种 ID 序列组成。上一节反例里,[257,99] 解码为 abc,重新编码得到 [97,256],并没有回到原始 ID 列表。
此外,合法 token ID 序列也可能拼出非法 UTF-8 字节。原 minbpe 使用 errors='replace' 方便展示,本书默认 strict 以尽早暴露问题,并单独提供 decode_bytes 保留精确信息。面向用户显示时可以显式选择 replace,测试保真性时不要默认容错。
22.5 保存时,能重建结果比能打开文件更重要
本书使用可读 JSON 保存四类内容:格式版本、正则预切分模式、按 rank 排序的合并三元组、特殊 token 映射。基础字节词表可以重建,因此不重复存储全部 bytes。
加载时按顺序检查:新 ID 是否按约定连续,两个子 ID 是否已经存在,同一 pair 是否重复,特殊 ID 是否冲突。先验证再构建,避免损坏文件悄悄变成另一套词表。保存/加载的正确性测试不是“函数没报错”,而是对同一组字符串检查加载前后 ID 列表完全一致。
这是一种教学格式,不兼容 minbpe 的 .model/.vocab 文本格式,也不兼容 tiktoken 的排名文件。生产环境还应在模型配置里记录 tokenizer 文件 hash,避免同名文件被替换后难以追踪。
22.6 真实小实验:压缩率只对这份文本成立
测试训练语料为 low low lower lowest. 学习中文,学习代码。 加换行,重复 20 次,共 1060 个 UTF-8 字节。基础 ByteBPE 目标词表为 285;编码训练文本得到 180 个 token,字节数/token 数为 5.888889。
这个数说明当前合并规则能压缩这份高度重复的语料,不是语言模型性能指标。它没有计入词表文件大小,也没有测试新的自然语言分布。若拿同样的词表去编码完全不同的语言,压缩率可能大幅降低。公平比较 tokenizer 时,应在相同、未参与 tokenizer 训练的文本上测量,分别报告各语言和领域。
本次测试还包含空字符串、单字符、中文和 emoji、两种重音表示、空白与控制字符、特殊标记字面文本,以及空训练语料和重叠合并。8 组基础 roundtrip 和保存加载对照全部通过。详细数字在 qa/part3/bpe.json。
练习与答案
- 课程第一阶段的具体检查: 写出
[5,6,6,7,9,1]将(6,7)替换为 99 的结果。 - 补充题: 为什么只保存
vocab[id]→bytes,通常不够重现普通 BPE 编码? - 补充题: 目标词表比 256 小,应该怎么办?
- 补充题: 写一个测试,让“每个 token 单独解码后拼接”的错误实现失败。
答案。 第一题是 [5,6,99,9,1],前面孤立的 6 保留。第二题需要知道合并优先级;第 22.3 节的最长匹配反例就说明了最终字节表不能代替任意编码决策。某些特定排名格式能从带 rank 的词条恢复合并结构,第 23 章会说其条件。第三题本书拒绝输入,因为承诺的基础字节覆盖需要 256 项;若要更小,必须改变问题定义。第四题用 中 的三个原始字节 token [228,184,173],正确 decode 是一个汉字,逐 token 容错解码则为三个替换符。
本章来源:除就近引用外,可按 minbpe basic.py 逐步对照训练与 encode;本书增加了空输入停止、明确同频规则、JSON 校验和反例测试。
交互实验:教学 BPE 合并
从字符到 token:逐条应用合并规则
改一段文本,看相邻符号如何按固定顺序合并,再核对每个 token 的教学 ID。这是自定义字符级 BPE,不是 GPT 分词器,也不在输入文字上重新训练规则。
01
输入 · 给固定规则一段文本
02
过程 · 一条规则,合并所有匹配位置
规则 0 / 7当前:按字符拆开
初始状态:按字符拆分 · 当前 18 个 token。
当前 token 序列
每张卡是完整 token;␠ 表示空格。可横向滚动,聚焦后用左右方向键查看。
- lID 11
- oID 14
- wID 22
- eID 4
- rID 17
- ␠ID 26
- lID 11
- oID 14
- wID 22
- eID 4
- sID 18
- tID 19
- ␠ID 26
- lID 11
- oID 14
- wID 22
- eID 4
- rID 17
当前 token 数18按当前规则进度得到的符号数量
本步合并处数0尚未应用合并规则
固定合并表
从上往下应用,不按当前文本重新排序。每条规则从左到右合并所有不重叠的匹配;窄屏可横向滚动,聚焦后用左右方向键查看。
- 1l + o → lo教学 ID 31待应用
- 2lo + w → low教学 ID 32待应用
- 3e + r → er教学 ID 33待应用
- 4low + er → lower教学 ID 34待应用
- 5s + t → st教学 ID 35待应用
- 6e + st → est教学 ID 36待应用
- 7low + est → lowest教学 ID 37待应用
03
解释 · token 不必是完整单词
先猜一条规则能合并几处。默认文本里,第一次合并会同时处理三个 l + o。走到最后再核对:符号数量变少了,把所有 token 拼回去,原文没有改变。
完整教学词表与边界
基础词表按 a–z、空格、句点、逗号、感叹号、问号排序,ID 从 0 开始;新符号按合并表追加。␠ 只是空格的显示标记。
词表保留完整符号;键盘聚焦区域后,可用左右方向键查看。
- ID 0: a
- ID 1: b
- ID 2: c
- ID 3: d
- ID 4: e
- ID 5: f
- ID 6: g
- ID 7: h
- ID 8: i
- ID 9: j
- ID 10: k
- ID 11: l
- ID 12: m
- ID 13: n
- ID 14: o
- ID 15: p
- ID 16: q
- ID 17: r
- ID 18: s
- ID 19: t
- ID 20: u
- ID 21: v
- ID 22: w
- ID 23: x
- ID 24: y
- ID 25: z
- ID 26: ␠
- ID 27: .
- ID 28: ,
- ID 29: !
- ID 30: ?
- ID 31: lo
- ID 32: low
- ID 33: er
- ID 34: lower
- ID 35: st
- ID 36: est
- ID 37: lowest
本章若采用 UTF-8 字节级 BPE,其基础单元和训练流程与本演示不同;此处只帮助观察“按既定规则合并”这一步。不做大小写转换或其他规范化;合并规则不跨空格。未知字符会明确报错,不伪造 token ID。真实 tokenizer 可能使用字节基础词表、预切分、特殊 token 和不同的合并规则;不能用这里的计数估算 API 账单。
不操作也能读懂:l + o → lo,lo + w → low,e + r → er,low + er → lower。token 是词表中的符号,不必等于一个字或一个完整单词。
依据:Hugging Face:BPE 的训练与编码。本例规则为明确列出的教学规则,并非从真实 GPT 词表摘取。