主题
第 01 章 先把语言任务写成可检查的输入和输出
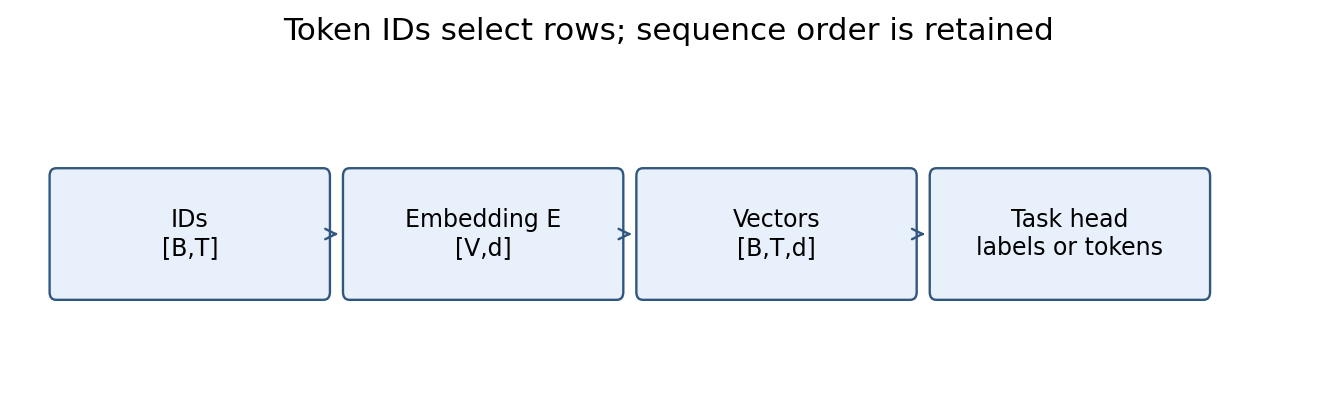
图 01:查表保留序列轴;句子分类或生成的输出头另行决定。(本书自绘)
01.1 一句中文可以对应九种不同的问题
同一句“林青周五从杭州出发,去苏州参加会议”,可以交给程序做不同的事。开始选模型之前,要先说清楚需要它返回什么。中文分词要给出词边界,子词切分要把文本变成词表能表示的片段,词性标注要给这些单位分配语法标签。这三项任务处理的单位和目标各不相同。因此,“杭州”被 tokenizer 分成两个字,并不一定是分词错误:tokenizer 可能做的是子词切分,而非中文分词。[来源:Happy-LLM 第一章 §1.1、§1.3,固定版本见章末。]
如果关心的是整句话谈什么,文本分类可以给整段话一个类别,例如“行程”;多标签分类则可能同时给出“工作”和“交通”。如果需要知道句中有哪些人、时间和地点,实体识别就要指出字符区间及类型,例如“林青”是人物,“周五”是时间。在这些实体之间,关系抽取还要连接对象,例如(林青,出发地,杭州)。只识别出杭州和苏州,尚未解决谁从哪里去哪里的问题。在真实标注中,应该保留实体起止位置,不能仅返回字符串,否则同名实体重复出现时便无法定位。
还有一些任务通常返回长度不固定的文本:摘要压缩信息,翻译改变语言,问答围绕问题选择证据。摘要可以抽取原句,也可以重新组织语言;抽取原句仍可能误导,因为删掉否定词所在的前一句、条件或时间限定,会改变意思。翻译需要保留角色关系和语用信息,逐词查字典做不到这一点。
问答可以从材料提取区间、查询结构化数据库、检索已有问答,或者生成回答;“检索式、知识库式、社区式”描述的是资料来源和组织方式,并不是互斥、穷尽的模型架构。
因此,一份可以执行的任务说明至少要固定输入、输出、标注单位和评分规则。假设输入有
01.2 从规则到统计:改变的是知识从哪里来
源教程 §1.2 用三个历史阶段串起 NLP:早期字典和规则,后来的统计建模,再到神经网络和预训练。这些阶段描述的是方法重点的变化,并不意味着从某一年起旧方法就全部消失。正则表达式识别标准编号至今仍有用;统计模型也不是深度学习出现以后才学会使用数据。规则明确、范围很窄的问题,用一个可审计的规则系统可能比调用大模型更合适。
规则系统由人写“遇到这个模式就做那个动作”;统计系统从样本估计哪些输出更可能。二者都需要选择表示、处理歧义和检验错误。神经网络特别之处是让表示本身也随着任务损失学习。例如不再先手写“包含会议就属于工作”的特征,而让词向量与分类器一起调整。代价是解释更难、训练数据更重要,域外输入也可能出现自信的错误。
接下来的章节会把表示学习一步步展开:先定义离散输入和标签,再研究可学习表示;用注意力建立位置之间的信息流;用训练目标约束哪些信息可见;最后检查训练、检索和工具系统是否真的完成任务。每章的小实验会帮助读者检查刚学到的概念,把前言所推荐的基础学习和实践接起来。
01.3 one-hot、词袋和 embedding 不能混为一谈
设词表为
词袋则汇总整句话中出现过哪些词。“猫追狗”的二值词袋是
在词袋的基础上,还可以给不同词分配不同权重。TF-IDF 会降低那些在许多文档中都出现、缺少区分度的词的权重。一个可明确复现的定义是
若希望保留 token 序列,并为每个 token 学习一个向量,可以使用 embedding。它用矩阵
向量变短了,并不意味着它已经包含语义。随机初始化的两个向量可能偶然接近;只有经过训练,距离才可能反映训练目标需要的关系。也不能说神经网络“每一维都代表某个可命名属性”:向量空间可以整体旋转而保持点积,单维解释往往不是唯一的。
01.4 语言模型把一句话分成一串条件概率
表示能学到什么,取决于训练要求它预测什么。语言模型的一种基本任务是根据已有前缀预测下一个 token。给 token 序列
链式法则把整条序列的概率拆成逐步预测的条件概率;它适用于一般概率分布,并不要求词之间独立。n-gram 模型为了估计方便,只保留前
训练时,常见目标是最小化平均负对数似然
预测任务也可以专门用来学习词向量。Word2Vec 选择的是局部上下文预测:skip-gram 从中心词预测邻近词,CBOW 从邻近词预测中心词。若输入向量为
这种训练得到的是静态词向量:同一个词在不同句子中通常仍取同一行矩阵。源教程 §1.4.3 介绍了这一机制;本书后续的玩具实验不构成对 Word2Vec 表示质量的复现。
要让同一个词随语境改变表示,ELMo 从双向语言模型的各层提取上下文表示。可以把下游使用的表示写成
01.5 练习:先找信息在哪一步丢失
补充练习。 为“猫不追狗”和“狗不追猫”分别构造 one-hot 序列、二值词袋、计数词袋。哪一种能仅凭表示判断动作方向?再设
提示与答案。 两句话的 one-hot 序列按位置排列不同,二值词袋及计数词袋相同,因此后两种在此输入上不可能恢复方向。embedding 有
可用 python examples/core/core_checks.py --section representation 检验查表与 one-hot 矩阵乘法相等。配套 qa/core/ 的已保存记录包含这项检查;验证的是代数关系,不能由此判断模型是否理解语言。
01.6 来源、改编与继续阅读
本章据 Datawhale Happy-LLM 第一章及前言独立重写,项目负责人宋志学、邹雨衡,指导专家朱信忠;新增任务接口、数学例子、纠错与练习。本伴读采用 CC BY-NC-SA 4.0,仅作非商业教学;完整许可及署名见本书《来源与许可》。固定源:第一章。原研究:Word2Vec、ELMo。不以这些历史资料推断当下产品性能。