行 1
取列一致:读取第 3 列,这是一个真实输入位置。
logits = [-2, -2, -2, 2, -2, -2, -2, -2]
贪心候选 ID:3。这里只让每列偏好不同的 ID,便于看清读错列的后果。
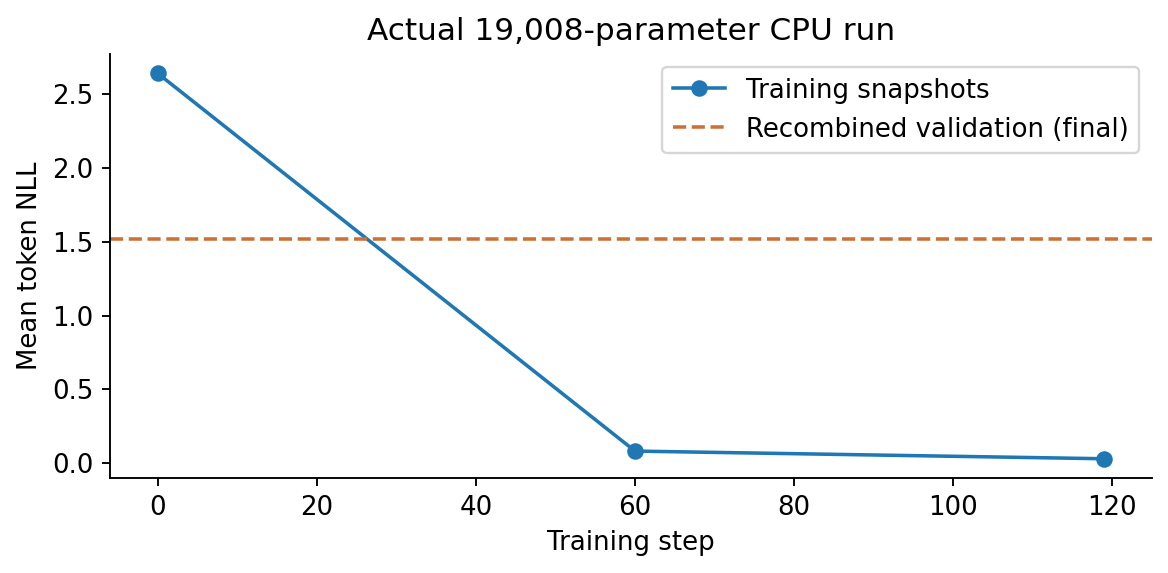
图 07:本书实际 CPU 训练,仅三个训练快照连线,不表示记录了全部曲线;验证集重排组合。(本书自绘)
训练 loss 降下来了,离一个能保存、重载并按约定生成文本的模型还有几步。本章沿着这条过程读源码:先看损失怎样变成一次参数更新,再检查配置是否真的生效,随后保存和重载模型,最后核对生成规则。文末的 CPU 小实验把这些环节接起来,也说明哪些结果只能证明程序工作正常,不能证明模型已经具备通用语言能力。
先看一次更新真正做了什么。数据提供输入 X、右移目标 Y,以及标出有效目标的 mask。模型给各个位置算出损失,只对有效目标取平均,再反向传播,得到参数应该怎样调整的梯度。
如果使用梯度累积,要等这一组小批次的梯度都准备好,才进行后面的步骤:取消混合精度缩放、裁剪梯度、更新优化器,最后清空梯度。顺序不能随意交换。直接裁剪仍被放大的梯度,会改变裁剪阈值的含义;在更新前清空梯度,则让这一步失去更新所需的数据。[源教程 §5.3.4—§5.3.5;ddp_pretrain.py 与 ddp_sft_full.py 的 train_epoch。]
梯度累积想把多个 micro-batch,也就是小批次,合成一次更新。这里容易漏掉一个问题:我们究竟在平均什么?
常见写法把每个小批次的均值损失除以累积次数 K,连续反向传播 K 次。这样得到的是 K 个批次均值的平均。在各个 token 的损失值不变的前提下,各批有效 token 数相同时,它也等于把这些 token 放在一起计算的均值;有效 token 数不同时,两种平均就不一样了。若希望每个 token 权重相同,应按各批有效 token 数加权。这里比较的是损失的归一化方式,不能仅凭这一点保证拆分批次后的整段训练与大 batch 训练逐值相同。
平均方式对了,还要看一个 epoch 结束时有没有剩下的梯度。源脚本只在 (step+1)%K==0 时更新,所以末尾不足 K 批时不会及时提交。下一轮也没有明确清零,这些梯度可能跨 epoch 留存;如果已经是最后一轮,则可能直接丢失。
修复需要同时处理提交时机和归一化。只在末尾补一个 optimizer.step(),还没有回答“这次到底累积了几批、应按多少有效目标归一化”。
还有一个更基础的前提:哪些位置参与损失,数据和模型必须约定一致。上游模型在没有 -100 标签时,把 pad ID 设为 ignore_index;偏偏 tokenizer 的 PAD 与 EOS 共用 ID 4。结果,真实 EOS 的损失先被模型归零,后面的外部 mask 再也无法把它恢复。
这里应在数据阶段把真正要忽略的位置统一改成 -100,让交叉熵只忽略 -100,保留真实结束 token 的训练信号。这正是上一章的数据协议问题:只改 mask、却不检查模型里的忽略规则,修复仍不完整。
训练实验室 · 有效 token 与梯度累积
把同一组有效目标拆成两个 microbatch(微批次),比较按 token 加权与按批次等权的损失、梯度和一次更新。默认例中,两种算法会把参数推向相反方向。
模型很小:所有输入 x=1,所以预测值是 w。每个有效目标使用半平方误差 ℓ=½(w−y)²,梯度是 w−y。这是可手算的标量例子,不是语言模型的交叉熵。
这一轮共有 4 个有效目标、2 个非空微批次。有效 token 数决定每个微批次在整体目标中的权重。
数字显示 6 位小数,计算使用未舍入值。各表与公式可左右滑动;键盘聚焦后可用方向键查看。
| 微批次 | 有效数 n | 损失和 S | 均值 S/n | 梯度和 | 均值梯度 |
|---|---|---|---|---|---|
| A | 1 | 2.000000 | 2.000000 | -2.000000 | -2.000000 |
| B | 3 | 1.500000 | 0.500000 | 3.000000 | 1.000000 |
token 加权:L = Σ Sᵣ / N = Σ (nᵣ / N) × Lᵣ
非空批等权:L_equal = Σ Lᵣ / K_nonempty
逐 token 梯度:∂ℓ/∂w = w − y
N 是这一轮所有有效目标的总数;K_nonempty 只数非空微批次。求和中的 Lᵣ 只对非空批定义。空批既不计算 0/0,也不作为“零均值”加入等权平均。
| 微批次 | token 权重 n/N | 加权梯度贡献 | 加权累计 | 非空批等权 | 等权梯度贡献 | 等权累计 |
|---|---|---|---|---|---|---|
| A | 0.250000 | -0.500000 | -0.500000 | 0.500000 | -1.000000 | -1.000000 |
| B | 0.750000 | 0.750000 | 0.250000 | 0.500000 | 0.500000 | -0.500000 |
当前查看:按有效 token 加权。所有损失与梯度均在更新前的同一个 w 处计算。
w_new = 0.000000 − 0.100000 × (0.250000) = -0.025000
| 路线 | 平均损失 | 梯度 | 更新后的 w |
|---|---|---|---|
| 合并为一个大 batch | 0.875000 | 0.250000 | -0.025000 |
| 按有效 token 加权 | 0.875000 | 0.250000 | -0.025000 |
| 微批次均值等权 | 1.250000 | -0.500000 | 0.050000 |
按有效 token 加权与合并整批一致;微批次均值等权改变了目标权重。短批中的单个 token 可能因此占更大比重。
若目标是“所有有效 token 等权”,就应把各批损失和相加,再除以全轮有效目标数。等价做法是:每个非空批的均值乘以 n/N,再反向传播。只除以微批次数,通常得到另一个加权目标。
本实验在开始时清零累积梯度;两批都使用同一个 w,没有在中途更新参数。只有所有贡献收齐后,才用同一学习率做一次普通 SGD。逐批先更新再计算下一批,已经改变了求导点,不能拿来验证这里的等价关系。
这里固定有效目标与逐目标损失,没有 dropout、跨样本统计、权重衰减或随机抽样。线性求和让按 token 加权的梯度与合并整批一致,实际浮点加法顺序仍可能带来微小差异。页面用解析梯度,CPU 契约测试另用 PyTorch autograd 核对。
同样的加权原则也适用于逐 token 交叉熵,但这不意味着本页运行了语言模型训练。这里不模拟分布式通信、混合精度、梯度裁剪或调度器,也不处理完整训练循环的尾批状态。
不操作也能读懂:w=0 时,A 的 1 个目标 y=2,损失和为 2、梯度和为 −2;B 的 3 个目标 y=−1,损失和为 1.5、梯度和为 3。整体梯度为 (−2+3)/4=0.25,批均值等权却为 (−2+1)/2=−0.5。学习率 0.1 时,一次更新分别得到 −0.025 与 0.05。
依据:Accelerate 1.10.1:变长 token 的梯度累积;PyTorch 2.6.0:backward 的梯度累加。核对于 2026-10-14。
训练循环接通以后,还要确认配置控制的是哪段代码。两个脚本的 Logger 只负责打印,学习率由 get_lr(it,all) 计算:warmup 期间线性增加,随后按余弦衰减到初始学习率的十分之一,超过总步数后保持这个下限。令 warmup 为
步数的单位同样属于配置。日志中的迭代步按 micro-batch 计数,并非每次优化器更新计数。若按优化器更新步来填写调度配置,却在每个 micro-batch 推进一次,调度就会快 K 倍。因此,读到一个总步数时,要同时追到它在循环中何时递增。
精度选项也要沿调用路径核对。预训练脚本接受 --dtype,却没有把这个值映射后传入 autocast;SFT 脚本才明确传了 dtype=ptdtype。因此,命令行上写着“bfloat16”,不能证明预训练实际采用了 bfloat16。不同精度对 GradScaler 的需要也不同,而 CPU 路径使用的是 nullcontext,没有验证 GPU 混合精度。排查这些问题时应保留并检查 warning,不能全局忽略以后就把运行成功当作配置正确。
再看模型初始化。两个 init_model 都会加载本地 tokenizer、同步 pad ID、构建模型,按可见 GPU 数包装 DataParallel,随后移动设备并统计可训练参数;其中嵌套的 count_parameters 只对 requires_grad 参数求和。虽然文件名带有 ddp,实际使用的是单进程 DataParallel,没有 DDP 的进程组和 DistributedSampler。并行方式要以这些执行代码为准。
SFT 初始化还会加载预训练权重,去除 _orig_mod. 前缀,并用 strict=False 接收权重。这个设置允许缺失键和多余键,所以“没有报错”不足以证明加载完整。应打印返回的 incompatible keys,逐项确认差异是否符合预期。
主程序还配置了输出路径、epochs、batch、学习率、设备、精度、worker 数、数据路径、累积次数、梯度阈值、warmup、日志保存间隔和 GPU 列表。这些参数里,下面三项尤其需要结合运行过程核对:
参数更新之后,要先想清楚保存文件的用途。源训练脚本按间隔保存 state_dict,并在固定步数额外命名保存;保存前切到 eval,保存后回到 train。这段过程没有使用独立验证数据和指标,因此切换模式并不等于完成了一次验证评估。若训练步数短于保存间隔,源码也没有保证最后一步一定被保存。
这就引出保存文件的两个用途:
| 你希望恢复什么 | 除模型参数外还要考虑什么 | 单独 state_dict 的边界 |
|---|---|---|
| 加载模型用于推理 | 配套模型配置、词表和生成规则 | 能恢复参数,不代表这些配套信息已经齐全 |
| 从中断处精确续训 | 优化器、调度器、scaler、全局步、随机状态、数据顺序与配置 | 缺少这些状态,不能保证与未中断训练一致 |
先明确用途,再判断当前权重文件是否足够。文件名叫 checkpoint,并不会自动补齐缺失的训练状态。
导出代码把参数整理成另一套加载接口。export_model.count_parameters 与训练时的统计方式相似;export_model 则先注册自定义配置和模型类,加载 tokenizer,构建模型,载入权重并移除编译前缀,再调用 save_pretrained 并保存 tokenizer。示例输入目录的拼写与训练默认目录不同,使用时要按实际输出路径核对。[源 export_model.py。]
这条导出路径还使用了 safe_serialization=False 和 trust_remote_code=True,不能直接作为无条件安全的默认配置。模型代码和检查点应来自自己生成或已经核验的来源,并优先使用 tensor-only 或安全格式。文件扩展名本身不能为其中的可执行内容提供可信保证。
本书的小实验保存自己生成的 tensor-only state_dict,以及独立的 config JSON 和 vocab JSON,重载时显式使用 weights_only=True。保存后还要给重载模型输入同一提示,检查 logits 是否逐值相同。这个比较能确认当前提示在重载前后的数值结果一致,帮助发现保存或加载环节的错误,但一个提示不足以证明所有输入都正确,也不能代替逐项核对配置和词表。因此,导出验收应同时保留配套文件检查与代表性输入的重载结果比较。
能够重载模型以后,还要决定怎样把 logits 变成下一个 token。给 logits
top-k 会先保留分数最高的 k 个候选,再归一化。实现中的屏蔽方式也会影响候选数:若按分数阈值而非索引屏蔽,阈值处有并列分数时,可能留下超过 k 个 token。这些规则改变的是选择过程,不能保证内容事实正确,k 与生成质量之间也没有“越大越好”的单调关系。
上游 generate 按这个思路循环:裁剪上下文、调用模型、取最后位置的结果,按温度选择贪婪或采样,再把新 token 拼回输入。因为没有 KV cache,每一步都会重算整个窗口;函数返回时只保留新生成的部分。它为 batch 的每一行维护 finished,已完成的行补 pad,等所有行完成才停止。具体选择由两个函数完成:_greedy_decode 取 top-1,_random_sample 依次执行温度、top-k 和 multinomial,后者需要正温度与有效 k。
“取最后位置”听起来简单,却必须先看 padding 放在哪一边。_left_pad_by_attention_mask 把有效 token 收拢到每行右边,生成时便可以统一取最后列;源 forward 却仍用有效 token 个数减一作为索引,沿用了右填充的取法。
看一个从 0 开始计数的例子:mask 是 [0,0,1,1],有效 token 共两个,因此旧取法读第 1 列;实际序列末尾却在第 3 列。列选错了,后面的采样再正确,也是在错误位置的 logits 上做选择。
修复可以在有效 mask 对应的位置索引中取最大值;如果已经保证左填充且每行非空,也可以直接取最后列。全空提示不满足这个前提,必须另外拒绝或补 BOS。
另一条生成路径是 _beam_search。它保留多条序列、累加 log probability,每轮扩展后截断到 num_beams。这段教学实现有几个明确限制:用 .item() 取单个样本分数,无法处理一般 batch;当前最佳束遇到 EOS 就停止,没有完整维护已完成的候选集合,也没有长度归一化。若束宽超过词表大小,topk 还会失败。因此,不能把这段代码描述为通用的最佳序列搜索。
最后还要检查入口怎样选择这些分支。generate_super 在 do_sample=False,num_beams=1 时,只有温度小于 0.1 才调用贪婪;默认温度 1.0 仍会进入随机采样,与函数文档的承诺不同。验收应直接检查实际分支。更清楚的接口约定是:do_sample=False 始终 argmax,温度只控制采样路径。束搜索分支也没有传入 padding mask,使用前要明确限制,或修复后再验证。
使用自造 logits,直接计算温度与 top-k 后的概率,再让你指定的 u 落进累计概率区间。这里没有运行语言模型,也不调用随机数;相同输入和 u 一定得到相同结果。
当前使用预设参数;修改输入后可随时切回。
第 1 步:读取 logits。 logits 是未归一化分数,不是概率。最大项为 ID 3。
表格可左右滑动;键盘聚焦后用左右方向键查看。
| 候选 | logit | 稳定分数 (z−max z)/τ | 过滤前概率 | 过滤后概率 | 状态 |
|---|---|---|---|---|---|
| ID 0 | 0 | 待计算 | 待计算 | 待计算 | 待过滤 |
| ID 1 | 1 | 待计算 | 待计算 | 待计算 | 待过滤 |
| ID 2 | 2 | 待计算 | 待计算 | 待计算 | 待过滤 |
| ID 3 | 3 | 待计算 | 待计算 | 待计算 | 待过滤 |
本例 top-k 严格保留 k 项;分数相同则优先保留原 ID 较小的项。比如 [3,2,2,0]、k=2 留下 ID 0、1。按第 k 大分数设阈值的另一种实现会保留前三项;两种策略的支持集不同。
正温度不改变候选排序。τ=0 在本例定义为确定性贪心,并列最大时选最小 ID;它不同于 τ→0⁺ 时在并列最大项间均分概率。贪心分支忽略 u 和 top-k 的过滤结果,但仍要求输入的 k 合法。
温度不能为负,top-k 必须是候选数以内的正整数,u 不能等于 1。有限精度下极小的概率可能下溢为 0;页面使用减最大值的稳定算法,不会用极大指数直接求和。这里不模拟 top-p、EOS、上下文截断或多步生成。
不操作也能读懂:[0,1,2,3]、τ=0.8、top-k=2 时只剩 ID 2、3,概率约 0.222700 与 0.777300。u=0.5 会选中 ID 3;u=0.1 会选中 ID 2。调温度不更新模型权重,也不保证回答更正确。
参数含义参考:Transformers 生成配置。严格 k 的并列规则、τ=0 分支和手动 u 是本例明确约定。
改动补齐位置,对比三种取列规则。先找最后一个真实输入,再观察它对应的整条 logits;不要把有效个数当成列号。
列号从 0 开始。1 是真实输入位置,0 是补齐;数量与位置是两种信息。
列号和分数不拆行。窄屏可横向滑动表格,或聚焦后按方向键。
| 请求行 | 列 0 | 列 1 | 列 2 | 列 3 | 有效个数 |
|---|---|---|---|---|---|
| 行 1 | 0补齐位置 | 0补齐位置 | 1真实位置 | 1真实位置最后有效✓ 当前取列 | 2 |
| 行 2 | 1真实位置 | 1真实位置 | 1真实位置 | 1真实位置最后有效✓ 当前取列 | 4 |
| 行 | 最右有效列 | 个数减一 | 末列 |
|---|---|---|---|
| 1 | 3 · 取列一致 | 1 · 错取补齐 | 3 · 取列一致 |
| 2 | 3 · 取列一致 | 3 · 取列一致 | 3 · 取列一致 |
取列一致:读取第 3 列,这是一个真实输入位置。
logits = [-2, -2, -2, 2, -2, -2, -2, -2]
贪心候选 ID:3。这里只让每列偏好不同的 ID,便于看清读错列的后果。
取列一致:读取第 3 列,这是一个真实输入位置。
logits = [-2, -2, -2, 2, -2, -2, -2, -2]
贪心候选 ID:3。这里只让每列偏好不同的 ID,便于看清读错列的后果。
mask [0, 0, 1, 1] 的有效个数是 2,个数减一得到 1;但最右边的 1 在第 3 列。右补齐 [1, 1, 0, 0] 恰好符合“个数减一”的前提,不能把这个公式搬到左补齐。
本例固定 8 个候选,每列 j 只有候选 j 的 logit 为 2,其余为 −2。分数是教学数据,不是模型预测;attention mask 表示可用输入位置,不会替调用者把 logits 的取列操作改正确。
Transformers 4.57.1 的普通生成路径读取 logits 的最后一列。因此非空、标准左补齐可让每行最后列都是最后真实输入。仅改成“最右有效列”不等于已修复右补齐的整个生成循环;还要遵守模型的位置编码、后续 mask 与缓存约定。本例不模拟这些部分。
全空行的最大有效位置不存在。PyTorch 普通负索引 −1 会指向末列,并不会自动表达“无结果”;本实验先拒绝空行,再读取任何分数。中间缺口预设只检验位置算法,不推荐把任意稀疏 mask 当成合法的生成提示。
不操作也能读懂:默认第一行最右有效列为 3;“有效个数减一”错取第 1 列,“直接取末列”在此左补齐前提下取对。第二行没有补齐,三条规则都取第 3 列。
依据:Transformers 4.57.1 左补齐说明;固定版本生成实现。核对:2026-10-14。
TextGenerator 把加载与生成接成了可调用的演示。初始化时,它设置 seed、设备和 autocast,读取 tokenizer 与 checkpoint,再按固定 1024 宽、18 层重建模型,移除编译前缀,加载权重,切到 eval 并移动设备。模型结构已经写定,因此不能直接换入任意其他 checkpoint。[源 model_sample.py,源教程 §5.3.6。]
接下来,提示的组织方式决定调用哪个入口。chat_template 加入 system、user 消息和助手生成前缀;sft_sample 用这个模板编码,并重复调用带 EOS 停止条件的 generate。pretrain_sample 则直接续写原文,也支持用 FILE: 从本地读取提示,但没有显式传入 EOS 停止条件。
两个采样方法都返回字符串列表,主程序借此展示预训练续写与 SFT 问答的区别。这些示例问题没有构成评测集,能回答其中一个问题不能证明知识全面。比较生成结果时也要保留运行条件:固定随机种子只在相同执行环境和随机调用顺序下帮助复现,GPU 内核或版本变化仍可能改变结果。
前面的检查可以在一个小实验中连起来做。在书根目录运行:
python examples/core/tiny_lm.py --steps 120 --output qa/core/tiny_run本书记录的实验环境为 Python 3.12.14、PyTorch 2.6.0+cpu,准确的 Python patch 版本另见运行清单;seed 为 20261014,线程数为 1。训练文本固定为“春天看花。夏天听雨。秋天读书。冬天看雪。”的重复,验证文本则重新组合季节与活动。run 建立字符词表,随机截取长度 24 的 batch,构造右移目标,用 AdamW 更新并裁剪梯度;batch 在同一序列中取得对齐的 X/Y,不跨 split 混合样本。
记录中的三个训练快照如下。它们是实际日志中的采样点,不代表绘图时记录了中间每一步。
| 训练步 | loss |
|---|---|
| 0 | 2.640177 |
| 60 | 0.081895 |
| 119 | 0.029966 |
验证 loss 为 1.515783。给出“春天”并做贪婪续写,得到“春天看花。夏天听雨。秋天读书。冬天看雪。春天”。训练 loss 很低,续写也连贯,但它恰好复现了训练文本里的循环。面对重新组合的季节与活动,验证结果明显更差。
这个实验能说明它记住了有限模式,不能据此说它学会了常识、中文或一般问答。
同一实验中,保存与重载后的 logits 精确相等。这表明本次保存、加载流程在所测提示上保持了数值结果,是这组输入范围内的工程验收结果。它与上面的生成质量应分别报告:恢复一致,并不改变模型只学到了有限模式的事实。
补充练习。 把每轮 micro-batch 数设为 10、累积次数设为 4,源循环更新几次,剩余多少批梯度?为什么只导出权重不能保证从第 120 步继续时与从未中断训练完全相同?
答案。 源循环在第 4 和第 8 批后更新,共两次,剩余两批梯度没有提交。续训时,即使权重相同,Adam 动量、步数、随机状态和下一批样本仍可能不同;这些状态也一致,才有条件谈精确恢复。
本章是 Datawhale Happy-LLM 第五章训练、导出和采样代码的原创伴读,采用 CC BY-NC-SA 4.0,保留项目作者归属。核对代码时使用固定第五章源码。本书代码和真实输出在独立附录中交付;没有运行上游 215M 训练、多卡、在线日志,也没有下载大型 tokenizer。
上文提到的源码问题,另由 upstream_defect_checks.py 做隔离复现。它只从固定的本地源码提取类和函数定义,用最小配置与模型基类替身完成计算,不导入 Transformers、tokenizer 或在线服务。因此,测试结果只对应指定函数,不能作为框架集成已经通过的证据。
记录中的实际结果包括:不等长交叉注意力 reshape 失败;源 LayerNorm 与总体方差定义最大差约 0.179746;只传 input_ids 时提示缺少 tokens;左填充样本选错位置,logits 最大差约 0.298561;EOS=PAD=4 时,该目标的 loss 为 0;默认 do_sample=False 仍走随机分支。这些结果分别对应具体输入和计算路径,便于定位问题。
另一个对照使用均匀八类 logits:以 pad ID 4 为目标时,标准交叉熵为
日志把有意捕获的失败标为 expected_failure=true,含义是测试找到了预期问题,不能据此说原实现已经通过该功能。配置替身也没有验证真实 PretrainedConfig 的初始化细节;把这些函数放回实际训练流程后,仍需另做兼容性测试。