主题
第 02 章 注意力怎样把信息搬到需要它的位置
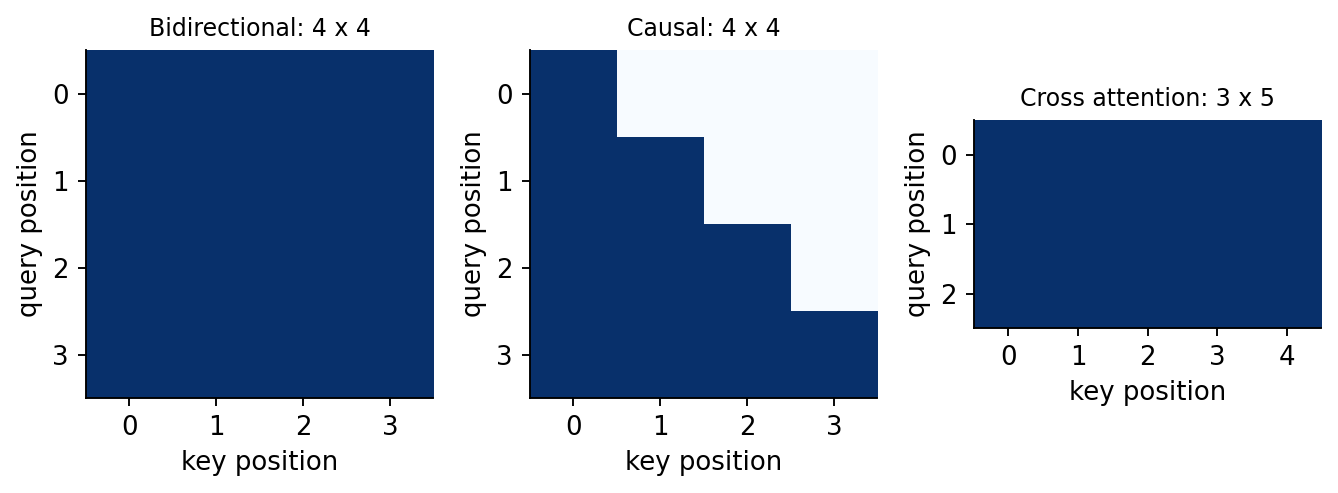
图 02:深色代表允许读取,白色代表被屏蔽;交叉注意力可以是不等长矩阵。(本书自绘)
02.1 先算一次加权平均,再解释 Q、K、V
上一章把文本变成了按位置排列的向量。接下来要解决的是:一个位置怎样取得其他位置的信息?源章先比较前馈、卷积和循环网络。前馈网络把输入映射到输出;普通 MLP 若直接接收固定长度的拼接向量,输入尺寸就固定了位置的组织方式和序列长度。卷积使用共享局部卷积核,同一种局部模式可以在不同位置被检测,多层或扩张卷积能扩大感受野。
循环网络则让隐藏状态随序列逐步更新,
| 结构 | 位置之间怎样交流 | 主要取舍 |
|---|---|---|
| 固定长度 MLP | 通过固定输入连接混合 | 结构直接,但改变长度通常要改输入组织 |
| 卷积 | 先连接局部位置,多层扩大范围 | 共享参数、局部并行;远距离关系需更多层或其他设计 |
| RNN/LSTM | 历史压入状态,沿时间递推 | 可逐步流式处理;训练中时间依赖限制并行,远距离梯度更难保持 |
| 全局自注意力 | 每个位置直接汇总所有允许位置 | 可并行计算训练位置;普通实现的注意力矩阵随长度平方增长 |
LSTM 的门控改善了长期信息的保存,不保证所有远距离依赖都容易学;RNN 推理也不必把整条历史原文全部保存在内存里,递推状态可以流式更新。
注意力的研究历史跨越多个领域,不能把源文“必定最先来自计算机视觉”的叙述当作无争议结论。NLP 中,Bahdanau 等的机器翻译工作 已将可学习对齐用于循环 encoder-decoder;Transformer 进一步以注意力和逐位置前馈层构成主要计算路径。这些结构各有设计动机,不能仅凭上面的比较判定哪一种在所有任务上最好。
读“杯子放不进箱子,因为它太小”时,判断“它”需要比较上下文。注意力把这种根据上下文选择信息的过程写成可微运算:先计算当前位置与其他可读取位置的匹配分数,再用分数决定各处信息所占的权重。查询、键和值分别记作
先只看一个查询
把一个查询扩展到多个查询,就得到矩阵形式
公式中的缩放因子用来控制分数的大小。若点积各项近似独立、均值为零、方差为一,
02.2 自注意力、掩码和多头是三件不同的事
先分清信息来源和可见范围。自注意力表示 Q、K、V 由同一序列投影得到,例如
如果一整行都被屏蔽,softmax 的分母为零,常见实现产生 NaN。对左填充序列开头的 padding 查询尤其要小心:可以构造安全行,随后将该查询输出归零,或者保证计算中没有全屏蔽行并在损失上排除 padding。仅仅忽略标签不能保证前向传播中 NaN 不会污染别的位置。
确定了哪些位置可读,还可以让不同的投影分别学习如何读取。这就是多头注意力:把投影后的表示分成若干子空间,每个头独立计算注意力。令模型宽度为
在长度为 T 的自注意力中,矩阵乘法产生
交互实验:注意力权重与因果掩码
让一个查询走完注意力的五步
改一组 Q、K、V,追踪某个查询如何筛掉未来位置,再把可见的值混合成输出。这里实际计算单头注意力;不包含投影、多头或 dropout。
01
先选一个要观察的问题
02
调输入,看同一条计算链怎样改变
每行一个位置,空格或逗号分列,换行或分号分行。范围 −100~100,最多 4 × 4;数字只用于教学,不是模型的语义向量。
03
沿着五步,查看真实中间结果
1 / 5 · 修改参数会重新演算
第 1 步:点积打分。当前查询 q1 = (0.0000, 1.0000)。 逐个计算 q 与每把键 k 的点积,得到匹配分数。
当前查询q1向量 (0.0000, 1.0000)
掩码后可见的键待掩码共 3 把键;屏蔽项权重为 0
当前行权重之和待归一化softmax 后检查,不用四舍五入的显示值相加
表格保留完整数值。窄屏可横向滚动;键盘聚焦表格区域后,用左右方向键查看。
| 键位置 | q · k | 缩放后 | 掩码后 | 权重 A |
|---|---|---|---|---|
| 0 | 0.0000 | 待计算 | 待计算 | 待计算 |
| 1 | 1.0000 | 待计算 | 待计算 | 待计算 |
| 2 | 1.0000 | 待计算 | 待计算 | 待计算 |
04
带着一个问题再试一次
试一试:怎样验证因果性?
使用三位置因果例,跟踪位置 1,走到最后一步。只改 K、V 的最后一行,位置 1 的输出应保持不变;关闭因果掩码后再比较。零分数例的权重三行分别是 (1,0,0)、(½,½,0)、(⅓,⅓,⅓)。掩码发生在 softmax 前,不能直接删掉概率而不重新归一化。
这里只演示等长序列的因果掩码,不模拟 padding 或缓存偏移;关闭掩码时 Q 与 K 可以不等长。一般注意力中 dᵥ 也不必等于 dₖ。所有屏蔽行都没有有效概率分布,本例保留对角线以避免这种情形。
不操作也能读懂:两键例中 q=(1,0)、k₀=(1,0)、k₁=(0,1)、V=(10,20)。缩放后权重约 (0.6698,0.3302),输出约 13.3024。
公式依据:Attention Is All You Need,§3.2。输入数字仅为本书教学示例。
02.3 Encoder-Decoder 的两条输入流
当输入和输出是两条不同序列时,信息流还需要进一步区分。翻译“今天下雨”为另一种语言时,源句可以一次看完,目标句必须从左到右生成。Encoder 读取完整源句,产生记忆矩阵
训练时已有完整的目标句,可以将它右移后作为 decoder 输入,并行计算全部目标位置:例如目标是 a b EOS,输入为 BOS a b,标签为 a b EOS。因果掩码保证第二个位置看不到第三个输入。推理时没有真实后缀,所以每次只能把刚生成的 token 接回去。训练并行与推理串行并不矛盾。
注意力让位置之间交换信息;每个位置内部的特征还需要进一步组合。Transformer 用逐位置前馈网络完成这一步:
在堆叠这些子层时,还需要留意归一化与残差连接。LayerNorm 对每个位置的
02.4 没有位置,注意力不知道谁先谁后
普通 token embedding 根据 token ID 查表,本身不包含它在句中的位置。如果既没有位置编码也没有掩码,自注意力对输入位置的同一置换会产生对应的输出置换。翻译、算术与语法通常需要顺序信息。原 Transformer 使用正弦位置编码
位置
02.5 逐模块阅读上游 transformer.py,辨认演示与可训练系统
读上游文件时,可以沿着参数设置、子层、容器和整体前向的顺序,核对前几节的公式。
ModelArgs 保存 n_embd,n_heads,dim,dropout,max_seq_len,vocab_size,block_size,n_layer。其中 n_embd 是 embedding 宽度,dim 是注意力输出宽度;源程序没有在所有连接处投影二者,因此实际应保持相等。dim % n_heads == 0 只检查头的可分性,不能代替残差宽度检查。max_seq_len 控制 causal mask,block_size 控制位置表;二者不一致时,输入可能通过一个长度检查,却在另一个模块失败。
MultiHeadAttention.__init__ 创建四个无偏置投影与两处 dropout;forward 按前文顺序拆头、缩放、加掩码、softmax、乘 V、拼头及输出投影。它把 K/V 也用 Q 的 seqlen reshape,因此只支持三者长度相同。真正的交叉注意力必须分别读取 q_len 和 kv_len,并验证 K/V 长度相同。例如
精度也需要单独检查。scores.float() 使 softmax 用 float32,即便输入是 float64 也会降精度;高精度数值检验应避免这种无条件转换。
LayerNorm.__init__ 建立可学习缩放和平移;其 forward 使用 torch.std 的默认样本标准差,再把 epsilon 加在标准差外。这与上节定义的总体方差加 epsilon 后开方不同。宽度为 1 时样本标准差还会失效。源实现可作为“某种归一化”运行,但不能声称等同 nn.LayerNorm。
MLP 的构造和前向对应两次线性映射和 ReLU,源 Encoder/Decoder 传入的中间宽度等于 dim,并非论文常见的四倍扩展。
EncoderLayer.forward 先覆盖 x=norm(x),然后计算 x+attention(x,x,x),跳连保留的是归一化后的 x。这并非标准 Pre-Norm 的原始 x 跳连。DecoderLayer.forward 两次覆盖 x,存在同类差异。Encoder、Decoder 的构造用 ModuleList 注册层,前向依次遍历并最终归一化;这些容器本身没有替换子层里的残差逻辑。
PositionalEncoding 构造并注册位置表 buffer;前向切片相加,不产生可学习位置参数。
Transformer.__init__ 用 ModuleDict 注册 embedding、位置、dropout、encoder、decoder 和词表头;_init_weights 对线性层及 embedding 用标准差 0.02 的正态初始化;get_num_params 对去重后的参数求 numel,可选择扣除 embedding。forward 要求 ID 是
这些模块能连接起来,还不代表整体信息流符合训练目标。这个 forward 把同一个序列同时送给 encoder 和 decoder。双向 encoder 已经看到后面的 token,decoder 的因果 mask 无法撤销交叉注意力读取的未来信息。因此它能演示模块连接,但不能直接用于自回归语言模型训练。翻译要显式传入独立的源序列和右移目标;单流因果语言模型应移除这条双向旁路。
main 调用 BertTokenizer.from_pretrained,会涉及外部 tokenizer 资源;再随机初始化整个 Transformer 并解码 argmax。输出的单个 token 不代表模型学会中文,也没有训练证据。配套的离线检查使用手造 token 和小张量,不包含这条需要外部资源的运行路径。requirements.txt 记录上游依赖,不等于已经验证兼容本书共享 CPU 环境。
02.6 验证因果性,要改变未来而不是只看 mask
可以运行 python examples/core/core_checks.py --section attention 检查实际信息流。配套脚本固定 seed,使用 float64,检查每行权重和为 1、禁止位置权重为 0,以及交叉注意力是否支持不等长输入。
因果性检查只改变序列最后一个位置,再比较前面位置的输出。若模型没有读取未来,这些输出就应保持不变;配套的已保存记录中,这项检查通过。双向注意力的前面位置通常会随之改变,这是可追加的对照,不属于该脚本已保存的测试结果。相比只打印一个三角 mask,这种输入扰动测试能够检查屏蔽规则是否真正作用于输出。
补充练习。 设 x=norm(x); x=x+F(x) 与 x=x+F(norm(x)) 一般不同。
答案。 分数为
02.7 来源与修改说明
本章改编 Datawhale Happy-LLM 第二章,保留项目作者归属与 CC BY-NC-SA 4.0;新增形状推导、代码审查和离线反例,不声称作者认可修订。固定正文和源码。架构的原论文:Attention Is All You Need。本章代码审查以固定源码为准,论文实验结果不作为本书实测。
02.8 文档片段的阅读位置
第二章正文先给 attention(query,key,value,...) 函数,再逐步展示多头、MLP、LayerNorm、Encoder/Decoder 和位置编码。独立 attention 对应 §02.1 的缩放、softmax 与乘 V;掩码和 dropout 对应 §02.2。文档中的 PositionEncoding 简略类和后面的 PositionalEncoding 完整类都服务 §02.4 的位置表,并非两种新位置算法。Encoder/Decoder 容器引用的 Layer 类要结合完整 transformer.py 阅读,单独复制容器片段会缺依赖。配套覆盖台账分别列出了各代码围栏的语法上下文与文件实现;其中的验证范围不包含需要下载 BertTokenizer 的主入口。
正文的 EncoderLayer/DecoderLayer 片段使用 norm_x 保留原始残差,表达的是标准 Pre-Norm;独立文件却覆盖了 x,二者行为不同,应以 §02.3 的公式判断。文档这两段及完整 Transformer 片段还混用类内缩进,原样复制会出现 unexpected indent。位置编码后用 Python 围栏展示的矩阵没有逗号,它是打印结果而非可执行列表。配套记录列出了这四处静态解析问题。独立文件通过语法编译,只能说明该文件可被解析,并不保证正文中的片段也能原样执行。