主题
第13章 GRPO:从一组答案中产生学习信号
同一道题,模型有时答对,有时答错。知道每条答案得了多少奖励之后,还要决定:哪些回答应当变得更容易生成,哪些应当减少?本章沿着一组回答往下看,先算学习信号,再看它怎样进入训练数组,最后核对脚本实际提交了什么。
这里讨论的是固定版本的演示实现。公式用来解释机制,不能代替对远程训练服务的验证;本次文字修订没有执行训练或重跑离线实验。
13.1 先把“答对”与“应该更新多少”分开
假设同一道算术题采样四次,奖励为 [1, 0, 1, 0]。奖励器已经区分了对错,但这个分数本身还没有说明:某条回答比同组其他回答好多少。如果四条都答对,仅凭相同的奖励,就无法在组内选出更值得提高概率的回答。
GRPO 用同一问题的一组采样作为比较对象,不再额外训练一个逐状态估值的 critic。不过,采样这组回答仍然要花成本。省掉 critic,并没有省掉 rollout;组越大,需要生成的回答也越多。
在固定问题
这一点需要单独记住。原始 GRPO 文献中常见的标准化形式是
再看两个边界:全组奖励为 [0,0,0,0] 时,优势全零;全组为 [1,1,1,1] 时,也一样。前一种情况可能是题太难,后一种可能是已经掌握。只看日志中的退化组比例,分不清这两种情况,还要一起看平均奖励。
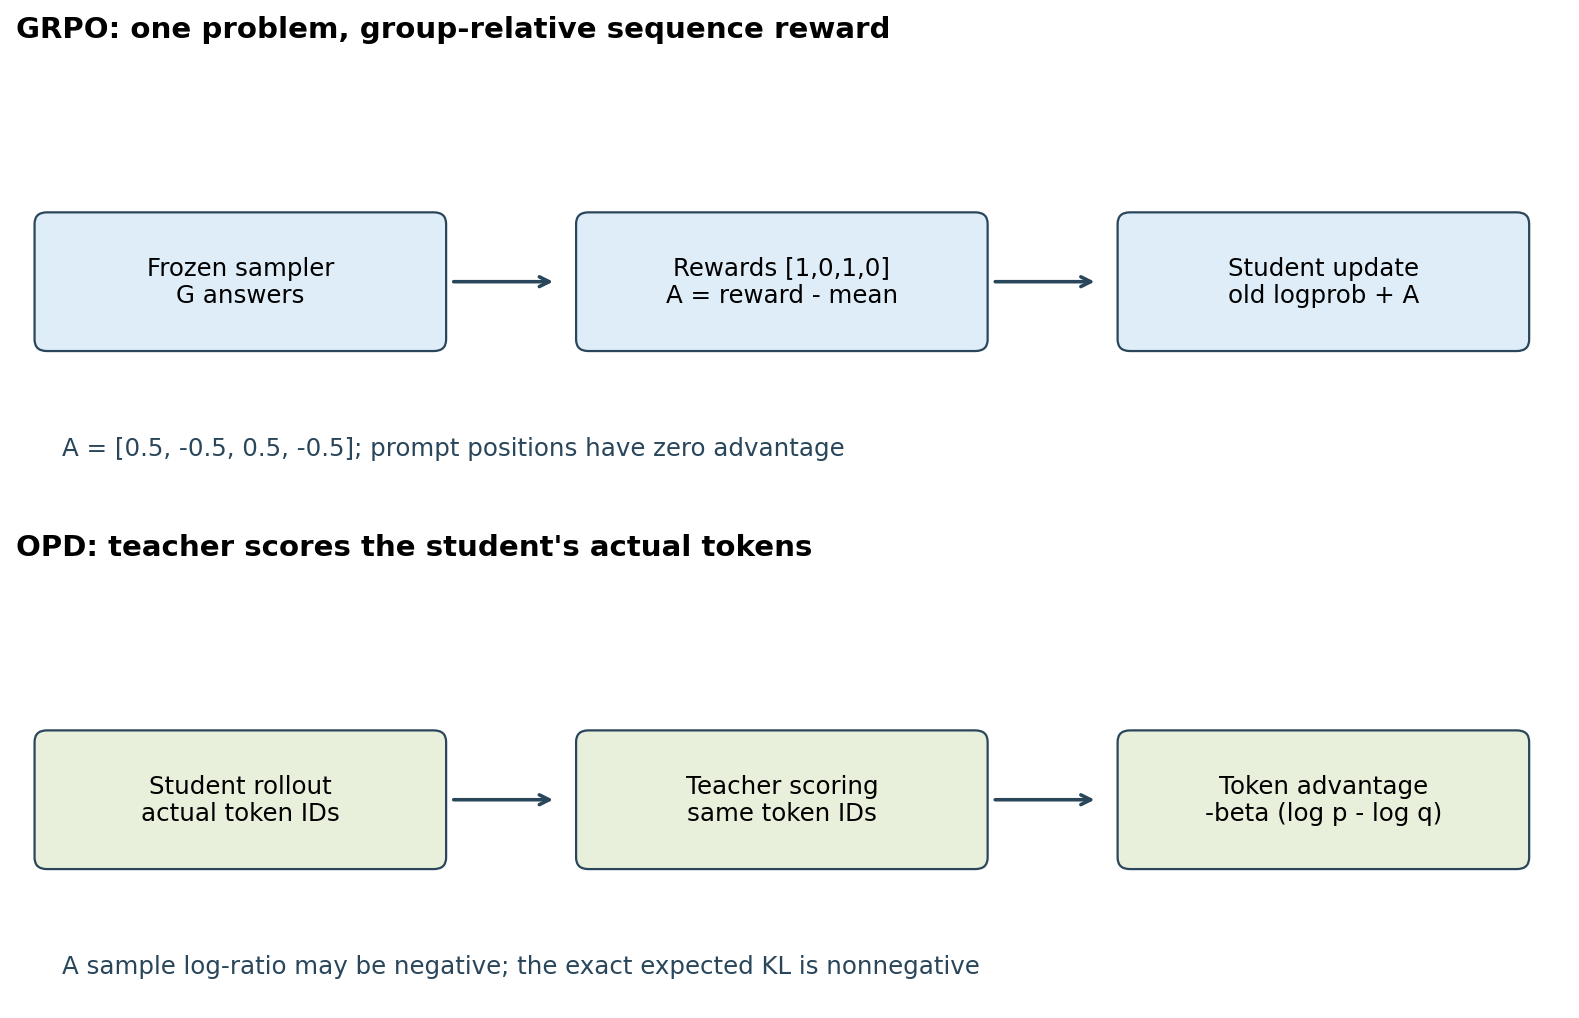
上图比较两种信号:GRPO 对同题回答做中心化,OPD 让教师评价学生生成的原 token。
13.2 策略比率到底在比较什么
优势说明一条回答相对同组其他回答的好坏,策略比率则比较模型对已采样 token 的概率怎样变化。
采样时冻结的策略记为
一种便于解释的重要性采样(importance-sampling)最小化目标为
在新旧策略相同处
真正接入训练服务时,平均方式也必须核对。按 token 还是按样本归约,是目标定义的一部分。本地代码把 loss 名称交给 PyTRIO,并没有展示服务端全部计算,不能只看客户端数组就断定服务端采用了上式的所有归约细节。
PPO 的典型剪切项为
负优势要另看。若
原始 GRPO 还讨论参考策略 KL 惩罚,而本示例没有显式计算 reference-model KL,也没有在 Datum 中传入 reference logprob。因此,论文的完整目标与演示脚本需要分开阅读。相关原论文为 DeepSeekMath;本书不据此声称复现其训练。
13.3 奖励器是任务规格的一部分
前面的计算都从奖励开始。奖励器怎样判断答案,会直接影响哪些回答得到正优势。
extract_boxed 用正则取得最后一个非嵌套的 \boxed{…};normalize_answer 去掉逗号、首尾空白和末尾句点;grade_answer 再检查字符串是否相等。参考答案由 extract_gsm8k_answer 从 #### 后提取最终值,找不到就报错。这样能接受“1,000”与“1000”,却不会自动把“1/2”与“0.5”视为相同。正则也不支持任意嵌套花括号,不能把 \boxed{\frac{1}{2}} 当成已经得到可靠解析的数学答案。
这些限制会进入训练结果:格式不符的正确答案可能拿不到奖励,恰好猜中最终值的错误推理却可能拿到满分。因此,除了奖励值,还应保存完整轨迹、格式成功率、答案成功率及人工抽查样本。若增加格式奖励,优化目标也会随之改变;奖励函数与测试集都需要版本记录,不能在训练中途悄悄换规则。
问题怎样送给模型,同样属于实验设置。build_prompt 使用 few-shot、QUESTION_SUFFIX 与模型 chat template;add_generation_prompt 提供 assistant 起始位置,enable_thinking=False 是此实验的模板选择。get_stop_sequences 对 eos 和模板结束符去空、去重。统计预算时要把整个提示模板的 token 算进去,不能只数自然语言问题。
13.4 把一条回答放进训练数组
有了奖励和优势,下一步是把回答对齐到模型要预测的位置。设 prompt token 为 [10,11,12],回答为 [20,21],旧 logprob 为 [−0.7,−0.4],优势为 0.5。build_grpo_datum 构造如下四个等长向量:
| 字段 | 数值 | 含义 |
|---|---|---|
| input | [10,11,12,20] | 当前位置看到的 token |
| target | [0,0,20,21] | 下一 token,前两项仅占位 |
| old logprob | [0,0,−0.7,−0.4] | 采样时旧策略给回答 token 的对数概率 |
| advantage | [0,0,0.5,0.5] | 前缀不训练,回答参与策略损失 |
向量长度为 ignore_index=-100;切换 loss 时要重新核对。
RolloutSample 保存 tokens、logprobs、text、reward、advantage。run_rollout_group 收齐本组奖励后才计算均值,并在 token 与 logprob 数目不相等时拒绝训练。build_grpo_datum 还会拒绝空 completion。空轨迹不能靠随便补一个 token 修好,因为这样已经改变了策略要学习的对象。
13.5 从数据到权重的控制流
先确定一次运行覆盖多少数据。load_gsm8k_train 会触发数据集下载,本书未调用。get_num_steps 在 all_data 模式下向上取整,以覆盖全量数据一次;pick_batch 在该模式下不回绕,其他模式则按模索引循环取题。因此,“10 步”与“一遍数据”是两种不同的实验口径。数据为空、batch_size 为零或 group_size 为零时,应在启动阶段拒绝,避免等到取模或求均值时才出错。
每一步中,main 先从当前训练权重获取 sampling client,再逐题 rollout。优势全为零的组会被跳过,其余数据提交给 forward_backward 与 optim_step,等待服务端结果后才进入下一步。
同步版用 .result() 等待。异步版则并发处理同一 batch 的问题,并 await future:run_prompt_rollout 将单题 prompt 与评分组织为任务,main 内部的 run_and_track 在任务完成后推进进度条。这样可以减少网络等待,但组内奖励公式没有改变,也不意味着优化器的多个更新步骤发生了交叠。
记录结果时,还要分清名字、日志和计数各自代表什么。model_slug 与 build_run_name 生成可识别的实验和权重名称;init_swanlab_run 记录配置,disabled 分支避免上传;get_numeric_metric 只读取确切键,缺失时不伪造零损失。count_train_tokens 数的是非零优势位置,所以得到的是有学习信号的 token 数,并非全部生成 token 数。
最后,finally 负责关闭日志。保存下来的 sampler 权重可用于采样,但若要断点续训,还需要优化器状态。
13.6 离线验证与练习
配套 examples/13_16_offline_rl.py 用来核对中心化、比率、PPO 正负优势、右移及零优势组。它不导入 PyTRIO、不下载 GSM8K,也不训练 Qwen,因此不能验证远程服务返回的 loss 归约形式。原稿记录的输出位于 qa/13_16_offline_rl.json;本次文字修订未重跑程序,也未重新核验该日志。
补充练习一:将奖励改为 [1,0,0,0],写出优势,并说明扩大组大小是否必然提高训练效率。答案为 [0.75,−0.25,−0.25,−0.25];更大组可能发现不同答案,但增加采样与教师/工具成本,退化率和单位成本收益必须测量。
补充练习二:为什么训练损失下降不能替代固定测试题的准确率?答案:损失受优势尺度、旧策略概率、长度和退化组筛选影响,且训练题可能被记忆;评测必须固定问题、采样设置、奖励版本和预算。
补充练习三:用上表逐个验证 input、target 的对应位置,再令 prompt 只有一个 token。答案:mask 长度变成0,仍能训练全部 completion;空 prompt 则需要拒绝,不能把 −1 当合法 mask 长度。
来源与改编说明
本章依据 Datawhale Happy-LLM 固定提交的docs/chapter8/grpo/README.md,以原创叙述、推导和离线反例扩写。第八章实现原署名及 agentic-rl-lab 来源见上游 README;Extra-Chapter 作者归属保留在全书授权页。本章与配套改编采用 CC BY-NC-SA 4.0,仅非商业使用,不代表原作者认可。文中的本地结果只证明指定离线检查通过,不代表复现上游模型效果。