主题
第21章 CDDRS:把“找相似内容”变成可审计的知识检索
21.1 检索辅助审查,还需要人判断适用条件
审查建筑文档时,找到主题相近的段落只是第一步。材料等级、尺寸、施工步骤和适用范围都可能影响判断,而向量相似度未必能抓住其中一个数值或限定条件。CDDRS 示例把语义分块、关键信息提取、知识评分、重排序、错误分析和修订建议串起来,尝试为审查提供更具体的依据。
本章沿着这条处理流程阅读教学代码,不提供真实工程合规意见。示例中的 C25、25mm 等值都是待审查文本,不能据此推断它们在其他工程中也合规。
上游作者与论文信息见固定 readme。论文题为 Generative knowledge-guided review system for construction disclosure documents,作者 Hongru Xiao、Jiankun Zhuang、Bin Yang、Jiale Han、Yantao Yu、Songning Lai,DOI为10.1016/j.aei.2025.103618。此处依据仓库提供的教学实现阅读,不声称复现论文实验或确认现行建筑规范。
21.2 基础接口:为什么要把模型调用包起来
先看模型调用如何进入这条流程。Notebook 单元 0–3 介绍目标与 LLM 接口,单元 4 用 BaseLLM 定义 model_name、model_params 与抽象方法 predict,单元 5–8 再实现 DeepSeekLLM、构造客户端并展示一次调用。这样,上层可以通过约定的接口请求文本,不必在每一步都重新组织客户端调用。
具体到 predict,它传入模型和 user 消息,返回文本。不过,保存到对象中的 model_params 没有在当前调用中展开,因此设置温度等字段未必生效。异常、空内容和响应结构也仍需处理。本书未执行单元 8 的 API 演示。
检索还需要把文本转成向量,这部分在单元 9–14。BaseEmb 约定 get_emb,BGEEmbedding 则封装 HuggingFaceEmbedding:get_emb 返回单文本向量,encode 接受字符串或字符串列表,逐条调用后堆成二维数组。对
这里的 encode 仍是逐条处理,没有批量并发推理优化,方法名本身不能说明吞吐能力。加载模型会下载权重或读取缓存,并允许远程自定义代码;本书未执行这一过程。
有了模型接口,还要把待检索文档读进来。单元 15–18 的 DocumentProcessor 递归读取 Markdown 文档,将原始文本放入列表;遇到读取异常时,打印错误并跳过文件。教学列表主要保存文本,但实际审查还需要文件路径、标题、条款号和版本。这些来源字段应随 chunk 一起传递,读者才能从检索结果回到原条款,核对它的适用范围。
21.3 动态语义分块的目标与实现缝隙
文档读入后,DynamicSemanticChunker 在单元 19–21 尝试沿着语义变化的位置分块。它先按中文句号、问号、叹号、分号或换行分句,并丢弃长度≤5的片段,再计算相邻句子的差异。
设句数
这套计算用文本长度估计大致需要多少块,再借助相邻句的差异寻找切分点。但最终不保证恰好得到
把各个函数接起来看,更容易发现信息在哪里丢失。_split_into_sentences 清理短句,_compute_semantic_discrepancy 计算相邻句的余弦差异,_identify_boundaries 在头尾补边界并去重,_create_initial_chunks 再用空格连接句子。最后,_enforce_length_constraints 丢弃小于 min 长度的块,把超长块交给 _split_overlong_chunk。
这里有两处风险。短条款可能恰好说明关键豁免条件,直接丢弃会损失事实。另一方面,最初分句已经去掉标点,拼接时又只用了空格;超长块函数再按原标点分句,就可能找不到边界,返回的块仍然超限。对于超长单句,代码也缺少能够保证缩短的 token 级回退。
改进这段实现时,可以让语义切分和长度约束各负其责:先保留原句与偏移,将短块并入邻块,避免无声丢弃;再用 tokenizer 的 token 切片落实硬上限,并记录字节或字符边界及来源范围。语义分块负责尽量保留主题连贯,最后一层切片负责保证长度。
这里的配套离线例检查相似度跳变。它没有加载真实 embedding,也不能据此判断是否达到了论文中的检索效果。
21.4 知识分数怎样算,为什么不能把名字当保证
分块之后,系统需要知道审查什么,以及哪些信息应在检索中占更大权重。单元 22–26 介绍整体流程、两阶段审查问题生成和 KeyInfoExtractor。generate_review_queries 先提取组件,再生成问题,清理编号、星号和短横线后取前五项;后面的 complete_review_process 只处理其中前三项。
KeyInfoExtractor 按精确的 max:、mid:、lit: 行解析信息,对应权重为 0.5、0.3、0.2。前导空格、大小写变化或字段缺失都可能让信息漏掉,因此解析失败应留下明确记录。文档虽然提及 BERT/BiLSTM 设计,教学代码实际调用的是 LLM,不能据此声称已经训练了专用提取网络。
提取出的术语如何参与打分?单元 27–34 给出四个标量函数,其中前三个先处理长度、频次和稀有度。设当前块词数
先看长度项。
稀有度项回答的是另一个问题:这个词是否到处都有?
第四个函数 compute_coherence_index 衡量术语在局部窗口中的聚集程度。它使用固定 50 词窗口、步长 10,取“窗口中术语计数×窗口长度/块长度”的最大值。这是一个自定义聚集度,可能超过 1,不能按概率解释。
它还有一个直观的反例:文本短于 50 词时,range 为空,结果恒为 0,即使术语已经明显集中在这段文本中。末尾不足一个步长的窗口也可能未被检查。若修改短文本的窗口处理,应将结果标为新版本实验,保留它与原算法的区别。
将每个优先级项拆成词后,上述各项与优先级权重相乘,再对术语求和,得到块的知识得分
公式之外,统计口径也会改变分数。_compute_knowledge_scores 用 split 按空白分词统计 tf,却用“子串是否出现”统计 df。于是,art 可能因为出现在 cart 中而计入 df,却没有计入 tf。对无空格中文,split 甚至可能把整句当成一项。使用这套分数前,需要先明确分词方法和术语规范化方式,让两种统计指向同一个对象。
单元 35–36 的 GKGRRetriever 把知识分与语义分接到一起。它预计算知识库 embedding,查询时得到语义余弦
这里的权重需要通过实验解释。
用两个候选块就能看出融合如何改变排序。A 的
这使精确术语证据有机会影响结果,但关键词一旦抽错,同一机制也会放大错误。评价时应分别报告语义分、知识分与融合分,通过
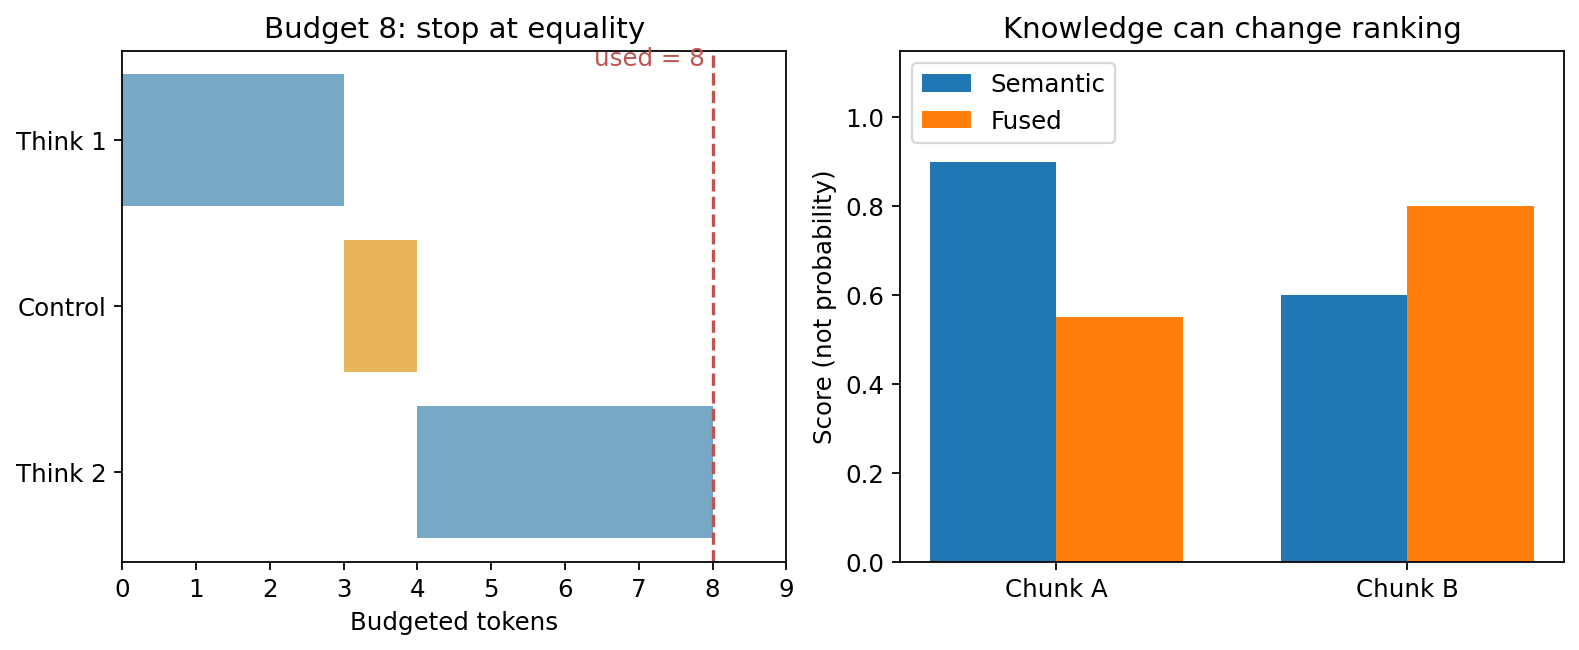
右图展示的就是这组小数值,用来解释排序如何变化,不是模型检索基准。
21.5 重排序与“查询增强”的实际接口
初步检索之后,单元 37–40 定义 _llm_rerank 与 _augment_query,并将它们显式赋给 GKGRRetriever 类。这是 Notebook 运行时挂接方法的写法。若只复制前面的类,漏掉这两个单元,默认开关启用时就会报 AttributeError。readme 中的片段展示与 Notebook 的组装方式不完全相同,阅读时需要确认方法究竟在哪里接入,不能任意拼接后就假定可运行。
重排序时,模型只能看到每篇文档的前 150 字符。程序解析它返回的逗号分隔编号,再补上遗漏项,但没有先去掉重复编号。例如返回“1,1,2”时,文档 1 会出现两次;结果截取到原长度后,文档 3 可能被挤掉。
要保证每篇文档恰好出现一次,列表协议应先过滤越界编号,再按出现顺序去重,最后补齐缺项。本书配套的离线 fixture 测试覆盖了这个修正。
_augment_query 的名字也需要与实际用途对照着看。它提示模型根据前三篇文档写详细答案,因此返回的是答案式文本。complete_review_process 虽然保存了 augmented_query,后面的 analyze_errors 仍接收原 query,也没有发起第二轮检索。
所以,这段实现尚未形成“增强后再检索”的循环。以后若加入这一过程,需要防止模型生成的猜测被当作新事实反复检索,逐渐变成看似有依据的结论。
21.6 分析、修订和假置信度
检索结果接下来交给单元 41–44。ErrorAnalyzer.analyze_errors 返回 analysis 字符串与 reference_support,RevisionGenerator.generate_revisions 用两者提示模型修改,同时读取 error_regions。但前一个类没有生成结构化的 error_regions,所以下游通常只能得到空列表。这是分析输出与修订输入之间尚未接好的地方。
显示出来的置信度也有类似问题。_calculate_confidence 使用 0.5+0.1×参考数+0.05×错误数,上限为 0.9。它只是未经校准的启发式显示分,不能解释成“90%概率正确”:引用更多未必更可靠,发现更多错误也不会自然增加结论正确率。
单元 45–49 将问题生成、检索、分析和建议串成完整流程,并展示施工文本。执行这条流程会触发多次外部 API 调用、embedding 模型加载和文档读取;本书未运行这些调用,示例修订也不能充当工程验收结论。
真正部署时,还需要核对适用地区、规范版本、原条款与例外,提供逐项引用、人工复核和变更记录。单元 50 的扩展设想、致谢和论文引用可用于了解后续方向与背景,但不证明这些能力已经实现。
21.7 如何做有意义的离线实验
离线实验可以先把容易混淆的机制拆开检查。配套脚本用明确的小向量和英文分词测试公式、短窗口反例、重复重排修复与预算控制;它没有使用真实 BGE 或 DeepSeek,结论只覆盖这些固定输入下的程序行为与算术,不能衡量语义质量。
若要评价真实系统,应准备带 gold evidence(人工标注的正确证据)的查询,分别计算 Recall@k、排序质量和建议正确率,并检查引用是否真正支持结论。答案读起来流畅,无法代替这些检查。
补充练习一:知识库为空时,哪里会出错?
答案:平均长度计算中的除以 0、最大值操作和 embedding shape 都需要保护。没有可用文档时,应返回“无可用证据”,而不是继续生成确定结论。
补充练习二:
补充练习三:为什么不应把 0.9 confidence 展示成合规保证?
答案:它来自参考数和错误数的启发式计算,没有独立标注数据、可靠性曲线或错误率校准,也没有验证规范适用性。
来源与改编说明
本章依据 Datawhale Happy-LLM 固定提交的Extra-Chapter/CDDRS/CDDRS.ipynb,以原创叙述、推导和离线反例扩写。第八章实现原署名及 agentic-rl-lab 来源见上游 README;Extra-Chapter 作者归属保留在全书授权页。本章与配套改编采用 CC BY-NC-SA 4.0,仅非商业使用,不代表原作者认可。文中的本地结果只证明指定离线检查通过,不代表复现上游模型效果。