主题
第14章 OPD:让教师评价学生走过的路径
学生已经生成了一段回答,教师还能怎样帮助它学习?OPD 保留学生实际生成的 token,让教师逐个评价。本章先解释这种评分怎样变成更新信号,再检查分数、位置与采样策略能否对应起来。
讨论以固定版本的演示代码为范围。本次仅修订文字,没有调用教师模型、更新 LoRA,或重新执行离线实验。
14.1 谁负责生成,决定了蒸馏覆盖什么
监督蒸馏可以先让教师写答案,再教学生模仿。这种做法有一个覆盖范围的问题:学生部署后,可能走进教师示范中没有出现过的中间状态。On-Policy Distillation(OPD)因此先让学生生成,再让教师对这条学生轨迹逐 token 打分。
教师评价的是学生已经走过的路径。它不重写一份更好的答案,而是回答:“在学生实际走到的上下文中,我会给这个 token 多大概率?”固定同步实现
仓库用 DeepMath 的 question 构成提示题库,不使用参考推理来计算交叉熵。学生是 LoRA training client,教师是只打分的 sampling client;模型名默认值属于这个提交的配置,不保证未来服务仍提供相同型号。
让两端评价同一条路径,有一个前提:tokenizer 与 token ID 必须兼容。同一个整数在双方都要表示同一个 token,聊天模板与上下文语义也要一致。仅仅词表大小相同,还不能确认兼容。
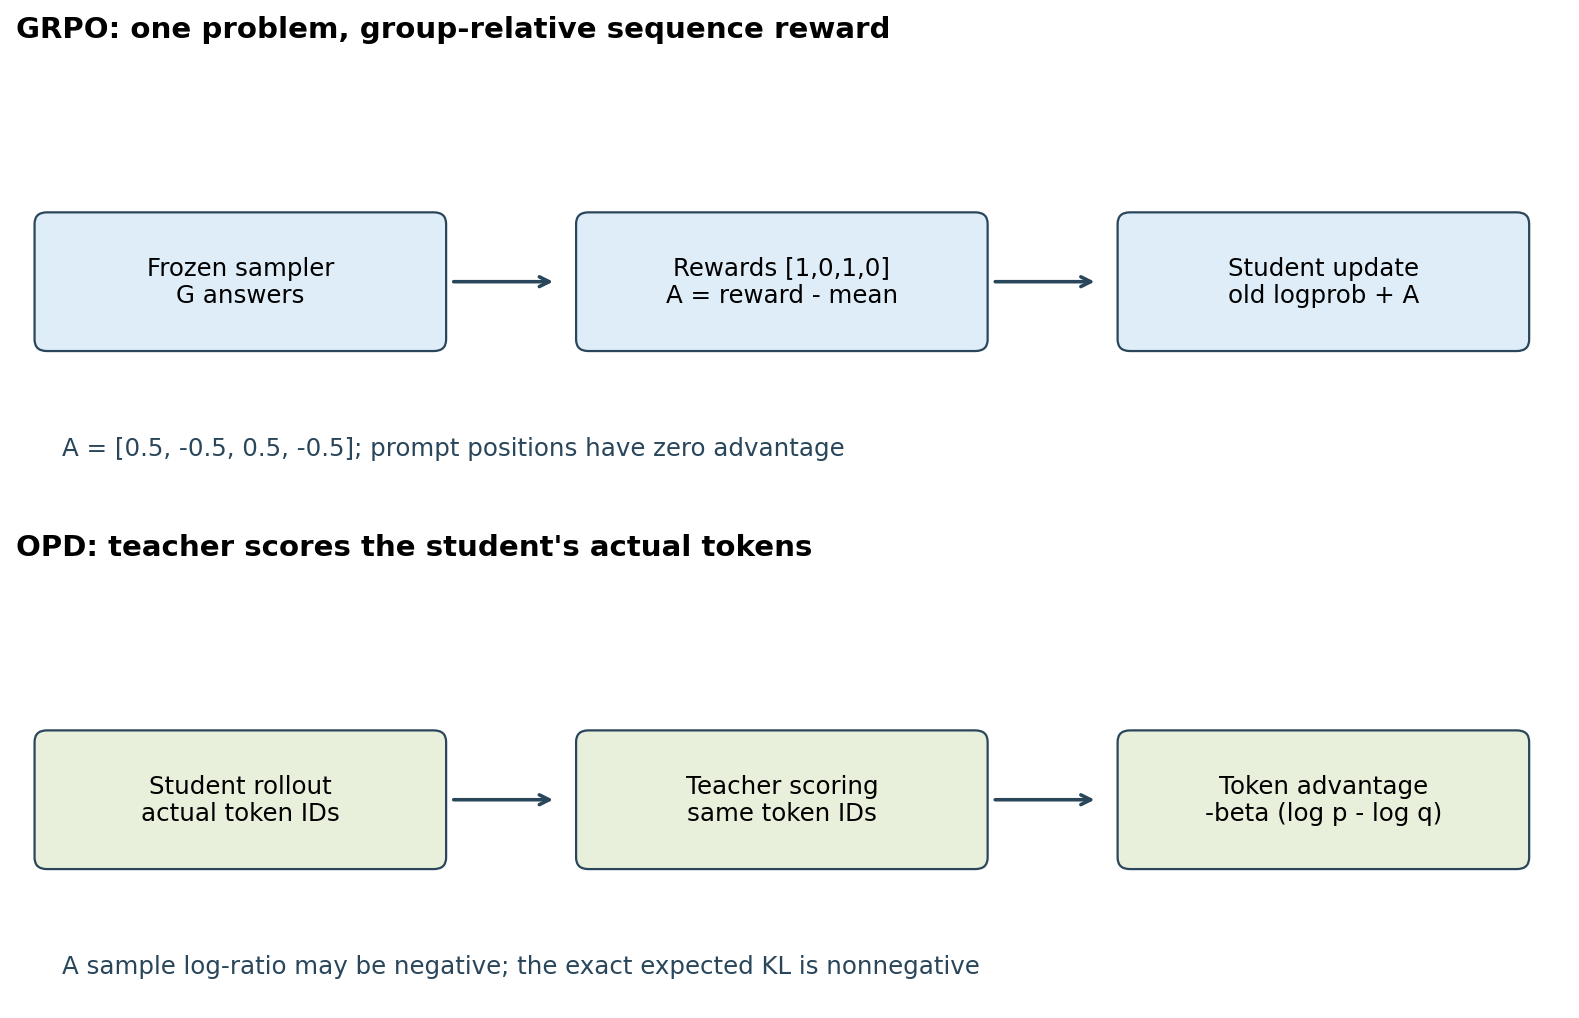
下半图中,教师只打分,不另生成替代回答;两端必须共享 token 语义。
14.2 为什么单个 token 的“KL”可以为负
理解评分信号之前,先区分整个分布的差异与单次采样得到的差值。在固定历史
这里要求
设
代码用这个差值逐 token 构造
若研究完整序列目标
再回到实现:仓库把采样时的差值当作固定优势,交给 importance_sampling,执行局部策略更新。它没有显式地把所有未来 token 的累积 KL 传播给早期动作。因此,这里的逐 token 局部替代目标(surrogate),不能直接说成对完整序列 KL 的无条件精确求解。
14.3 教师分数与学生 token 的对齐
信号算得对,还要放到正确的 token 上。completion_teacher_logprobs 将 prompt_ids+completion_ids 整段送到教师,得到按原 token 位置排列的 logprob。第一 token 可能没有前文,所以返回 None;函数只切取从 len(prompt_ids) 到末尾的 completion 段,并要求数目恰好等于 completion 长度,且不能出现 None。
这里有两套位置约定。教师接口按被预测 token 的原位置返回 logprob;训练 Datum 则用 input[:-1] 预测 target[1:]。因此,取教师分数的切片与构造训练数组的右移,需要分别核对,混用会产生一位错位。build_opd_datum 的四个向量仍长
位置对齐后,还要确认分数来自哪个策略。学生的 old_logprobs 必须来自生成这条回答的 sampler。如果事后用更新过的模型重算,再当作采样时的概率,比率就失去了原来的含义。
截断采样、温度、top-p/top-k 也会影响实际行为分布。服务返回的 logprob 究竟在这些变换之前还是之后,需要查服务契约;保存了 logprob,并不等于已经精确校正所有采样变换。
14.4 同步与异步:省等待,不省一致性检查
同步版按问题依次生成和评分。异步版的 run_prompt_rollout 则先 await 一个问题的学生结果,再用 asyncio.gather 并发提交该问题不同 completion 的教师评分;main 还会并发处理多个问题。内部的 run_and_track 只在任务完成后更新进度,不改变教师评分与样本的对应关系。
并发能减少等待,但先后依赖仍然存在:学生 token 确定之后,教师才能给它评分。
| 选择 | 等待方式 | 策略新鲜度 | 主要风险 |
|---|---|---|---|
| 同步,每步刷新 sampler | 顺序请求 | 每步当前权重 | 网络等待较多 |
| 同步批次内异步并发 | 同批次请求重叠 | 仍可每步刷新 | 突发并发、错误传播 |
| 每 | 复用旧采样器 | 更新之间变旧 | 不再严格当前策略采样 |
并发之外,还要看采样器多久刷新。sampler_refresh_steps=1 时,每步重新保存当前学生快照;设得更大,可以减少保存开销,却会让采样策略落后于正在更新的学生。importance ratio 可以用于校正,但不能保证任意旧数据都可放心复用,比率方差与支持集缺失的问题仍然存在。
异步 API 本身也可能需要等待两次:先 await 提交操作,取得 future,再 await future 拿到实际结果。仓库先提交 forward/backward 和 optim,再等待二者。这个写法依赖远端训练客户端对操作次序的约定,不能照搬后就认定梯度计算与优化器步骤可以任意并发。
14.5 数据、下载和日志也会改变复现
同样的训练设置,还需要对应同样的数据范围。shard_name 生成十个 parquet 分片的五位编号,modelscope_file_url 编码 repository、revision、FilePath;download_if_needed 先写临时文件再替换,避免未完成的文件被误当成完整文件。
load_deepmath 依次准备指定分片,用本地 parquet reader 读取,验证 question 字段,再按 seed 打乱并截取 sample_size。这里要留意分片选择:前几个分片与全数据的分布可能不同,固定种子并不能独自保证抽样无偏。
启动前,parse_args 检查分片范围,以及 steps、batch_size、group_size、sampler_refresh_steps 是否为正数。空数据、温度是否合法、上下文是否超限,也需要独立检查。build_prompt 则控制 suffix 和 thinking 模板。
日志由 start_swanlab 将 Path 转成字符串后记录;关闭开关应在创建日志前处理。main 记录 reverse-KL 样本值的 mean/std、completion token 数、耗时与服务端指标,最终保存 sampler weights。解读速度时别漏掉测量范围:这里的 token/s 包含网络和服务排队,不能当作本机 CPU 吞吐。
配套离线例用两类分布的精确枚举检查 KL 与单样本差值,原稿记录的输出位于 qa/13_16_offline_rl.json。本次未重跑程序,也未重新核验日志。这类数学检查不包含教师模型调用或 LoRA 更新,不能据此声称训练已经收敛。
14.6 练习与答案
补充练习一:将
补充练习二:学生生成三个 token,教师切片只返回两个,该怎么办?答案:拒绝该样本,记录上下文长度、接口版本和 shape;不能用0补齐,因为 logprob=0 表示概率1,补齐会制造极强假信号。
补充练习三:教师更大就一定更适合吗?答案:不一定。目标领域正确性、词表兼容、打分成本和偏差都重要。应以固定预算、独立题集和同一采样口径比较学生蒸馏前后,另抽查教师自身错误。
来源与改编说明
本章依据 Datawhale Happy-LLM 固定提交的docs/chapter8/opd/README.md,以原创叙述、推导和离线反例扩写。第八章实现原署名及 agentic-rl-lab 来源见上游 README;Extra-Chapter 作者归属保留在全书授权页。本章与配套改编采用 CC BY-NC-SA 4.0,仅非商业使用,不代表原作者认可。文中的本地结果只证明指定离线检查通过,不代表复现上游模型效果。