主题
第20章 思考预算与生成:更多 token 应该花在哪里
20.1 先定义预算,再讨论效果
程序怎样控制“思考预算”?可以允许单条回答更长,也可以同时采样更多答案;可以提前停止,还可以在模型想结束时追加提示,让它继续检查。这些做法改变成本的方式不同,提供的采样机会也不同。比较效果之前,必须先说明预算限制了什么。
s1 的 budget forcing 提供了一种延长或限制测试时生成的思路,但不能据此推断:无需训练,任何模型都能靠延长生成变得更聪明。s1 原论文
上游仓库 Extra-Chapter 的 s1.py 使用本地 Qwen3-14B 路径与 vLLM,开启 thinking 模板,在 </think> 停止后追加 Wait!,尝试继续推理,再显式补结束标记进入最终答案阶段。
这个脚本演示了预算控制的机制,没有复现 s1 的全部数据筛选、微调和评测。readme、images 与 output 中的材料属于上游说明和运行记录,应与本章引用的配套离线检查区分开。
20.2 把一条回答的长度分成三部分
设 prompt 长度
max_tokens 通常控制本次请求新生成的数量;prompt+completion 的总长还受模型最大上下文限制。两项限制需要分别检查。vLLM SamplingParams 官方文档
例如,预算为 100、已用 70,下一次最多生成 30 个 token。若在续写前还要追加 4 个控制 token,就要先确定:这 4 个算不算在思考预算里?如果预算包含控制 token,留给下一次生成的就只剩 26 个。
两种口径都可以使用,但请求上限和日志计数必须遵循同一规则。若发请求时不扣除插入文本,统计时却又把它计入整段长度,预算就对不上。
源码中的 count_thinking_token 将 prompt 与输出文本拼接,再按最后一个 <think>\n 切分并重新分词。count_token 同样会重新编码字符串。这样得到的数量可能受特殊 token 添加、文本边界和模板结构影响。
更稳健的做法是优先使用引擎返回的 token IDs,分别累计新生成 token 和控制 token;同时显式记录当前处于思考阶段还是答案阶段,避免仅凭最后一次字符串 split 判断。
20.3 原预算循环为什么需要边界测试
run_thinking_budget_sample 将思考已用量初始化为 0。每轮先以 thinking_budget-think_token_count 作为请求上限,调用 generate 后再计数,直到已用量“>预算”才退出。
问题出在恰好用完预算时:退出条件还未成立,下一轮却会请求 max_tokens=0,可能触发参数校验错误。如果模型提前输出停止标记,而追加文本、重新编码后的计数又没有增加,循环还可能反复续写。
源码虽然声明了 max_token=input_token_count+thinking_budget,但没有用这个变量实际限制上下文。变量名表达了意图,并不意味着限制已经生效。
修订循环时,应先在发请求前检查 remaining <= 0,用完预算就停止。每轮返回后,验证新生成数量不超过请求上限;追加控制 token 前,再检查剩余预算。遇到空输出或计数没有前进的情况,也要明确退出。这样,每个继续执行的循环都会消耗有限预算,才能说明它为什么一定会终止。
最终答案还要另留
配套 examples/20_21_offline_retrieval.py 用预设输出(fixture)模拟预算循环,不调用模型。检查记录中,预算为 8,两个预设回答分别占 3 和 4 个 token,中间控制 token 占 1 个,最终恰好用完 8 个,之后不再提交零长度请求。脚本还用空输出检查无进展时的退出行为。这些检查覆盖的是控制逻辑,不能证明思考内容正确。
比较效果时还要注意两条调用路径的预算差异。run_sample 是不使用 budget forcing 的对照,但它的总生成上限为 32768;run_thinking_budget_sample 则在思考阶段之外,仍允许答案阶段生成 4096 个 token。若直接比较文本长度或答案质量,必须说明两边各自允许消耗多少预算。
脚本末尾用时间戳命名输出,便于保存一次演示。要复现实验,还需要记录模型与分词器 revision、种子、引擎版本、题目 ID、停止原因、token 计数与配置哈希。
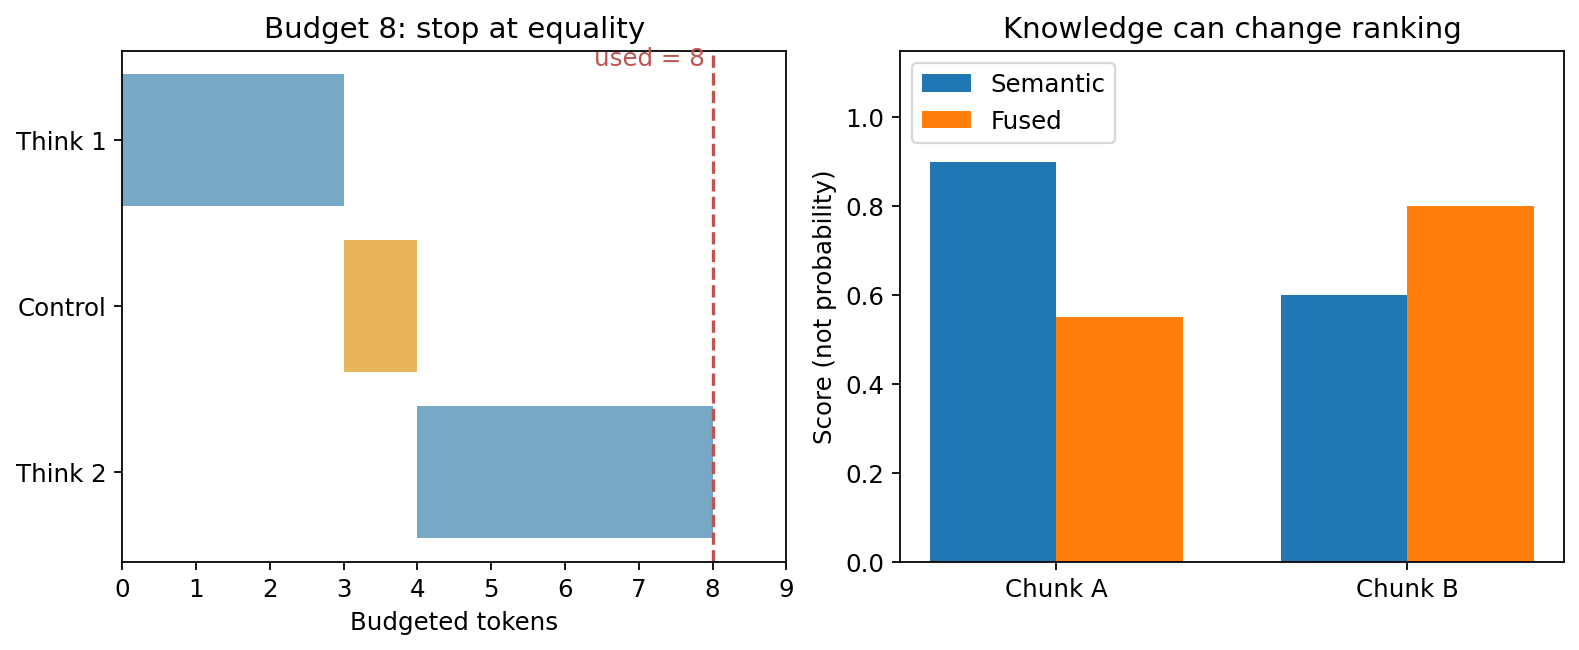
左图把控制 token 计入预算,恰好用完 8 个时停止;右图供下一章比较融合排序。
20.4 贪婪、采样与束搜索分别优化什么
对于词表大小
实现时,应先减去最大 logit,保持数值稳定。
top-k 保留最高
贪婪解码每步选择概率最大的 token,却不保证得到概率最大的整条序列。看一个示意树:第一步
束搜索按累积 logprob 对候选排序,同时保留有限数量的前缀。它仍是近似搜索,并且容易偏好短序列,因此常引入长度惩罚。即使找到了模型概率最高的序列,也不等于找到了事实最正确或最适合当前对话的回答。
| 方法 | 选择规则 | 可控优势 | 失败方式 |
|---|---|---|---|
| 贪婪 | 每步最大概率 | 简单、便于复查 | 局部选择错过全局路径 |
| 温度/top-k/top-p采样 | 截断后随机抽样 | 可调探索和多样性 | 低概率错误、跨种子波动 |
| 束搜索 | 保留多条高分前缀 | 显式搜索候选路径 | 长度偏好、重复、成本增长 |
| 预算强制 | 干预何时结束/续写 | 控制测试时计算 | 冗长、自我推翻正确答案 |
Extra-Chapter/generation-method/llm_generation.py 的 test_decoding_strategies 对自定义模型 generate_super 展示贪婪、三次采样、三束和温度对照;test_original_generation 是接口失败时的回退示例。
generate_super 不是通用 Transformers API,必须确认具体模型实现支持传入参数。异常后回退只能说明另一条路径可运行,不能将其标成原策略测试成功。示例解码完整返回序列,是否包含 prompt 取决于 generate_super 的契约,也应核查。
运行这些示例之前,还要检查代码来源。model_down.py 的 snapshot_download 使用 master 分支,没有固定 revision;主脚本又允许 trust_remote_code=True。可复现实验应先固定代码和权重 revision、审查远程自定义代码,再决定是否允许执行。本书不下载或执行该模型。
20.5 怎样证明额外思考值得付费
要判断额外计算是否值得,应在同一题集上同时报告单题预算、正确率、延迟分布、生成数和停止原因。
只观察到“答对的轨迹更长”,还不能说明增加长度导致答对。按结果挑选轨迹会带来选择偏差,题目难度也会同时影响长度和正确率:更难的题可能生成得更长,却更容易出错。
更有力的比较是固定模型和题目,预先设置一组预算档位,使用多个随机种子,再与预算相同的多样本方案比较。这样才能区分:收益究竟来自单条推理变长,还是来自多采样了几次。
上游两份 output 文本可用来观察循环与答案阶段,不能单独估计总体收益,也不能据文件时间戳推断当前硬件吞吐。
本章引用的配套检查记录只覆盖两分支概率树、温度分布与预算模拟,输出见 qa/20_21_offline_retrieval.json。它们帮助核对机制,不能替代模型效果评测。
补充练习:预算正好耗尽与超预算有何区别?
答案:正好耗尽时就应停止继续思考。退出条件应为 remaining <= 0;等到
补充练习:多采样 8 次,只选其中正确的答案,能否宣称单次能力提升?
答案:不能。采样机会增加了,而且选择过程使用了答案信息。应报告 Pass@8,并说明选择器能否在不知道标准答案的情况下选中正确结果。
来源与改编说明
本章依据 Datawhale Happy-LLM 固定提交的Extra-Chapter/s1-vllm-thinking-budget/readme.md,以原创叙述、推导和离线反例扩写。第八章实现原署名及 agentic-rl-lab 来源见上游 README;Extra-Chapter 作者归属保留在全书授权页。本章与配套改编采用 CC BY-NC-SA 4.0,仅非商业使用,不代表原作者认可。文中引用的离线检查记录只支持指定计算和控制逻辑的结论,不代表复现上游模型效果。