主题
第 18 章 Transformer 设计复盘:从文本到注意力,哪里最容易接错
18.1 先沿着张量走一遍
一段文本要经过分词、整数编号、嵌入查表、位置处理,才成为 Transformer 的输入。每一步都可能运行成功,却悄悄改变任务:空格被删除,特殊标记被拆开,窗口末尾缺少目标,或者把隐藏状态误认为词表概率。
本章把 Happy-LLM 的 架构补充 与 文本处理补充 放在一起,重点解释各层之间必须满足的约定:先看模型接收和返回什么,再回到分词、窗口和标签,检查送入模型的数据是否仍表达原来的任务。
设批大小为
PyTorch 的 nn.Transformer 不自带分词器、词嵌入、位置编码或语言模型头。上游架构说明把最终 output 口头称为概率时,省略了输出头和 softmax 这两步。对照接口检查形状,比凭类名推断功能更稳妥。
架构补充依据的是 PyTorch v2.5.1;配套小张量检查记录的环境是 2.6.0+cpu。阅读代码说明与数值结果时,需要区分这两个版本。
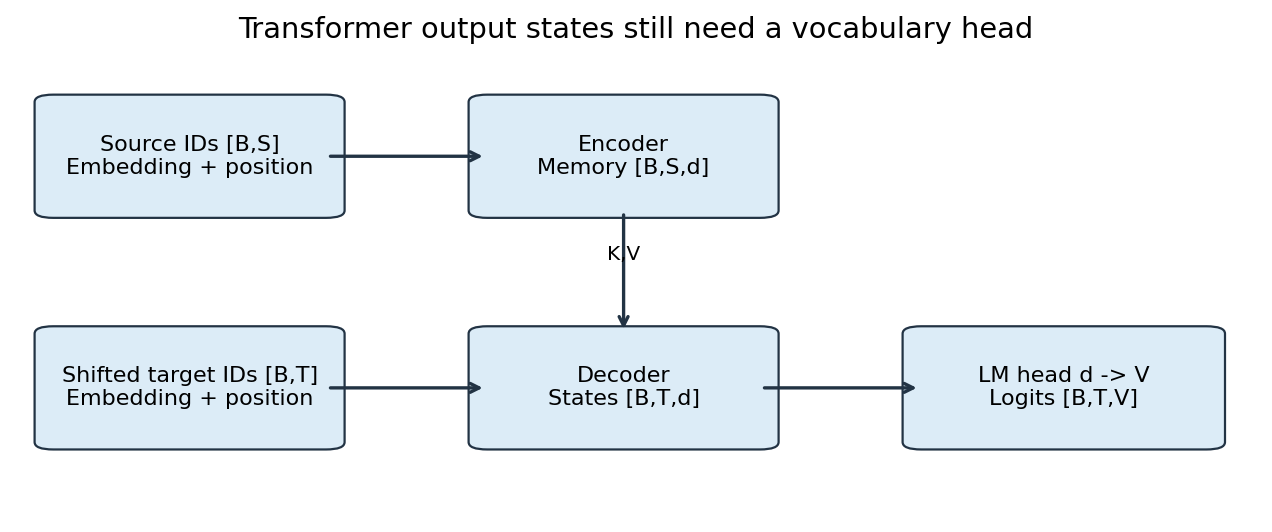
图 18-1 自绘数据流。Transformer 输出隐藏状态后,还需词表输出头;K/V 表示交叉注意力读取的 memory。
18.2 Encoder、Decoder 与注意力各自做什么
Transformer.__init__ 根据 d_model、nhead、编码和解码层数、dim_feedforward 构造模块。TransformerEncoderLayer 管一个 block 的注意力、FFN、残差和归一化,TransformerEncoder 将它复制并串联;解码侧对应 TransformerDecoderLayer 和 TransformerDecoder。这些层各自持有参数。虽然初始化时由同一个原型复制而来,后续更新仍可不同,不能按共享权重理解。
Transformer.forward 先将 source 送入 encoder,得到 memory,再让 decoder 处理 target 和 memory。默认 batch_first=False 时接口使用
注意力用
这里
分母中的缩放则用来控制内积尺度。若独立零均值的 query/key 分量方差约为 1,内积的方差随
判断是哪一种注意力,要追踪 Q/K/V 从哪里来。encoder 自注意力的三者都来自当前源隐藏状态,decoder 自注意力的三者都来自当前目标隐藏状态。交叉注意力则跨过了这条边界:decoder 用目标隐藏状态产生 Q,以 encoder memory 产生 K/V。高层的 Q/K/V 不再直接来自最底层 embedding。掩码数量不是分类依据,只有一个 mask 也完全可以是交叉注意力。
取两个二维 query/key:
第一行只能看自身时,权重为 [1,0],输出 [2,0]。第二行看两者,softmax 输入为 [0,1/√2],配套检查记录中的权重约 [0.330238,0.669762],据此计算的输出约 [0.660477,2.679046]。这个例子同时检查了转置方向、缩放、softmax 的轴和 mask 的生效位置。
多头注意力将投影后的表示分为
拼接后的输出投影与 block 后面的 FFN 承担不同工作。FFN 对每个位置使用同一套参数:
18.3 两种 mask 与标签移位必须分别核对
decoder 训练常用 teacher forcing:把正确目标序列右移后作为输入,同时预测所有下一个 token。训练可以并行计算各位置;自回归推理仍要逐步生成。因此“Transformer 每次只能算一个输出”只适用于通常的逐 token 生成过程,不适用于训练前向。
因果 mask 约束目标位置之间的访问。位置
key padding mask 处理的是另一件事:每个样本哪些 key 是填充。它要随着样本变化,形状也与位置之间的访问矩阵不同:
| 接口参数 | 常见二维形状 | 要表达的事情 |
|---|---|---|
src_mask | 源位置间是否允许互相访问 | |
tgt_mask | 目标位置间的因果或自定义约束 | |
memory_mask | 每个目标 query 允许访问哪些源 key | |
src_key_padding_mask | 各样本源 padding 的位置 | |
tgt_key_padding_mask | 各样本目标 padding 的位置 | |
memory_key_padding_mask | 交叉注意力应忽略的源 padding |
上游把 memory_mask 描述成源样本长度,容易与 memory_key_padding_mask 混淆。通常 encoder 不需要因果 mask,但不能由此推出 encoder 不接受结构 mask。不同 API 对布尔 mask 的 True 含义也可能不同:nn.Transformer 系列的阻断语义,不能原封不动迁移到所有底层 attention API。
上游截图中的 attention 函数先以 mask == 0 填很小的负数,再 softmax,之后可对权重做 dropout,最后乘 value 并返回输出与权重。这要求调用方提供的是“1 允许、0 阻断”的 mask。
即便 mask 的含义一致,数值处理仍可能出问题。使用 -1e9 近似负无穷在低精度下还要考虑表示范围。整行全部被屏蔽时,不能假定 softmax 总能给有效概率;应保证每个真实 query 至少有一个合法 key,或显式处理空行。dropout 后返回的权重也未必每行和为 1,因为训练期缩放已改变数值。
18.4 位置编码的代数性质不等于长文本能力保证
不含位置信号和位置相关 mask 的自注意力具有置换等变性:把输入位置一起重排,输出也相应重排,模块本身没有指定“谁先谁后”。这不意味着所有带因果 mask 的网络完全没有顺序线索,但它解释了为什么通常要显式提供位置。
正弦位置编码在第
固定偏移
这来自正弦与余弦加法公式。它说明:对固定偏移,存在一个只依赖该偏移的线性变换。至于模型能否处理训练时没见过的长度,这个代数关系并未给出保证。
配套检查记录取
可学习绝对位置表则用 [3,4] 查表成 [3,4,256],位置表 [4,256] 在 batch 轴广播。这是 GPT-2 式绝对位置示例,不宜泛称所有 GPT 系列都使用同一位置机制。
上游用残差展开解释位置信息能向上传递,这说明存在直通路径,但“绝不会消失”过强。若子层学出
回到具体实现,编码层的 norm_first 分支分别是 pre-norm 的 _sa_block、_mha_block、_ff_block 正是分别封装这些操作。
18.5 第一张词向量图能证明什么
模型内部的形状看清后,再回到入口:文本究竟怎样变成向量?文本处理补充第 1 节的 tokenize 用正则 \w+|[^\w\s] 保留单词与标点,丢掉空白。build_vocab 按唯一 token 排序编号;encode_text 以 <unk> 处理未知 token。其 vocab.get(token, vocab['<unk>']) 默认表达式会先求值,所以词表必须真的包含 <unk>,即使当前 token 都已知也不能省掉它。
WordEmbeddingModel.__init__ 只创建 nn.Embedding,forward 只是查表。main 添加 <pad>/<unk>、建立 14 项词表、用 10 维随机 embedding 编码 14 个位置,再打印余弦相似度。visualize_embeddings 把取出的向量用 PCA 压到二维,画点、标注、保存图片。
这张图展示了“整数如何变成向量”,其中没有训练语义关系的步骤。即使随机初始化的图上猫和狗更近,也不能据此说明模型学到了它们的语义关系;PCA 又会丢掉部分距离信息。重复 token 查到相同行,图上可能完全重合,这是查表性质而非学习成果。
更精确地说,ID [2,3,2],第 0 和第 2 个输出应相同;反向传播时,第 2 行参数会累加这两个位置的梯度。ID 只是地址,编号 8 不比编号 4 “语义大一倍”。
18.6 三种正则分词器,保留的信息并不一样
第 2 节 SimpleTokenizer.__init__ 建立 pad、unk、bos、eos 配置,有文本才调用 build_vocab。tokenize 使用 \S+|\s+,会把 Hello, 当一个 token,却保留整段空白。build_vocab 按频率降序、同频按字符串排序建立映射,encode 查表,decode 使用 prev_token 和 rstrip 拼接。示例文本可以往返,但不能因此推断任意输入均无损;尤其未建词表时 encode 的 unk 查找会失败。
同一节还展示了另一条路线:BPETokenizer 是 tiktoken 的包装:构造时 get_encoding 加载指定编码;tokenize 返回每个 token 的 bytes;encode/decode 直接委托底层编码器。
这里返回的 bytes 不能逐个当作可显示的字符,一个中文字符或 emoji 的 UTF-8 字节可能横跨多个 token。应先拼回完整字节序列再解码,避免单 token 强行转字符串造成替换字符。缓存不存在时加载编码可能访问网络,本书没有运行此路径。
第 3 节又定义了名为 Tokenizer 的类,其正则 \w+|[^\w\s]|\s+ 同时保留单词、标点和空白。build_vocab 使用 Counter、min_freq 和确定性排序;encode(add_special_tokens=True) 在 ID 层包上 BOS/EOS;decode 可去特殊标记,但最后用 re.sub 把所有空白归一化成一个空格,并 strip。分词时虽然保留了空白,解码时仍会破坏代码缩进和换行。
test_tokenizer 的未知文本示例还暴露另一问题:当 remove_special_tokens=True 时,unk 也被删除,未知词就无声消失。给人展示时应保留未知信息,而不是制造看似流畅的缺词句子。
定制特殊 ID 还需要检查唯一性、非负和连续性。上游以 len(special_tokens) 作为下一个 ID,若自定义 ID 是 0 和 10,后续逻辑未必冲突,但 embedding 的行数若只按项目数设定,就会越界。正确的策略是强制连续编号,或统一按最大 ID 加一分配容量。
18.7 “加进词表”不等于“识别成一个特殊 token”
第 4 节的另一个 Tokenizer 增加 sep 与 cls,构造、计频、编码、解码基本重复上一版。test_special_tokens 在 ID 层手工插入 sep,因此这部分能工作;可 add_special_token('<mask>') 只更新正反词表和计数,没有更新 special_tokens 集合,也没有修改 tokenize 的正则。
配套正则检查记录将 '<mask>' 拆成 ['<','mask','>']。注册的新 ID 根本没有被使用,原教程打印的三个 unk 就是证据。
要让新 ID 真正生效,需要让 tokenizer 优先匹配已经注册的特殊字符串,例如按长度降序转义后组合成专用分支;并把新 token 同步记入特殊 token 集合。更稳妥的是使用成熟 tokenizer 的专用注册接口,同时检查新增词表项是否需要扩展模型 embedding 和输出头。
正文有些“不同文本之间插入……”的位置缺少可见标记名,应把它视为源文档排版缺失,而不是猜一个 ID 后照做。特殊标记的文字写法、整数 ID、模型表容量和模板位置四者必须一致。
还要检查解码是否保留了未知信息。上游第 4 节的训练示例不包含大量测试词,去掉所有特殊 token 后输出只剩零散已知词;这不是完成了未知词识别,而是丢失了信息。
18.8 手写 BPE 的合并过程与失败边界
第 5 节的 SimpleBPETokenizer 有两个状态:最终词表和 bpe_ranks 合并优先级。build_vocab 先登记特殊符号与训练字符,再统计相邻字符对,反复选择最频繁的一对,记录其 rank,并合并为新 token。
比如训练串 abab,初始 [a,b,a,b] 中 (a,b) 出现两次,(b,a) 一次;先合并 (a,b),得到 [ab,ab],再合并可得到 [abab]。推理应按训练时的 rank 合并,而不是每条输入重新选择最高频对。
_get_stats 累加带频次的相邻符号对,_merge_vocab 用带边界的正则替换,_word_to_pairs 返回集合但正文主流程没有调用它。
推理时,_get_pairs 读取 token 列表中的邻接对;bpe 处理空串、单字符和特殊 token,再重复选择最小 rank,扫描并合并不重叠匹配,直到没有可用规则。tokenize 对 text.split() 后的各词调用 bpe;encode 查最终词表并可包 BOS/EOS;decode 直接拼接 token。
这个教学实现不是完整的 byte-level BPE。训练阶段把字符用空格串联,再以 split() 取符号,会让真实空格与符号分隔混在一起;推理的 text.split() 又直接删除原始空白。因此 Hello world 可能解码为 Helloworld。
字符覆盖也有限。它只登记训练中出现过的字符,陌生字符仍然是 unk;而覆盖全部基础字节的 BPE 才能在其输入编码规则内避免因未见字符而出现同类问题。test_simple_bpe_tokenizer 中丢空格和未知字符的输出,应当读成反例,不能因为最后打印“测试完成”就当所有性质已通过。
_merge_vocab 以字符串为字典键,合并后键若相同,直接赋值可能覆盖计数;可靠实现应聚合频次。使用字符 tuple/list 作为内部表示还能避免空白字符的二义性。
换用专业编码器后,仍要检查加载和兼容性。test_tiktoken_bpe 展示专业编码器的往返与 token 字节;捕获 KeyError 后改用另一个编码只处理编码名问题,不解决网络失败,而且更换编码会改变 ID、词表和模型兼容性。
18.9 滑动窗口:多出来的最后一条样本在预测什么
有了整数序列,接下来要把它切成训练样本。第 6 节 TextWindowDataset 保存整数序列、上下文长度、stride 与 pad ID。__len__ 返回预计算样本数,__getitem__ 取长度 create_data_loader 再设置 batch 和 shuffle,test_sliding_window 检查单样本、批形状和不同 stride。
若要求输入与目标都来自真实文本,起点
上游用 [107,108,109,110],目标 [108,109,110,0],其中 0 是补出来的 pad。
这个补齐值会改变训练目标。若直接用于交叉熵,模型被要求在真实文本结束后预测 pad。可以保留这一条,但补齐位置必须在 loss 中忽略;或者明确加入真实 EOS,表达文档确已结束。
当 __getitem__ 的末端调整并不构成完整的索引校验。
窗口之间的关系也会影响评估。窗口高度重叠会重复呈现 token,并改变其在不同上下文中的权重,不能简单说重叠必然导致过拟合。真正危险的是先切高度重叠窗口再随机分训练测试集;应先按文档或来源划分。
最后再核对一次标签约定:这里的 targets 已经右移。若把这个数据直接交给还会内部移位标签的因果 LM,就会再次错位。手写训练循环可以用 logits 对右移后的 targets;标准 causal LM 常应传未移位 labels。两种约定都能正确,混用才会出错。
18.10 CBOW 教会了什么,没有教会什么
前面的随机 embedding 只演示查表;第 7 节开始用预测任务更新词向量。这里 Vocabulary 的 add_token 依首次出现顺序分配 ID,build_from_texts 遍历 token 序列,encode/decode 提供 unk 回退。它不同于之前按词频排序的词表,不能把两者 ID 混用。CBOWDataset 为每个中心词收集左右各 __len__ 返回样本数,__getitem__ 返回上下文整数张量与一个中心词标签。
CBOW.__init__ 创建 embedding 和 forward 查表成
train_cbow_model 建词表、创建数据集和 DataLoader,使用交叉熵与 Adam;每轮执行清梯度、前向、反向和更新,最后只返回 embedding。
读训练结果时,需要先确认平均方式。上游按 batch 平均 loss,最后一个较小 batch 获得相同权重;精确样本均值应按 batch 样本数加权。空数据集还会导致 DataLoader 或除零错误,应在训练前检查。
训练之外还有保存问题。test_word_embedding 之后重建词表,只有输入和遍历顺序完全相同才能重现 ID,因此工程上应把词表与权重一起保存返回。
示例只有五个五词句子,左右各取两个词,因此总共只有五个中心词训练样本。即使 50 个 epoch 的 loss 下降,也很可能只是记住少数搭配。
查看近邻输出时,也要去掉容易误导的项目。输出中的“最相似词”还包含词自身,余弦相似度自然为 1,应排除后再看邻居。大小写的 Football/football 和 Sports/sports 是不同 ID;未知词的 unk 向量若没有接受充分训练,也没有合理语义保证。
第 8 节 test_position_embedding 只展示形状和随机位置向量,不验证语言能力。它在顶部初始化 tokenizer,但后面直接使用硬编码 ID,位置广播实验其实无需加载 tokenizer。这个观察能帮助把大而难复现的示例缩成离线、可检查的最小程序。
18.11 练习、检查与来源
本书补充练习:
- 目标长度 5、源长度 8,交叉注意力分数矩阵与 memory padding mask 分别是什么形状?
- 给
<mask>分配新 ID 后,正则仍把它拆成三段,应该修词表还是分词规则? ,完整目标窗口有多少条? - CBOW 交换左右上下文位置会改变预测吗?为什么?
答案:
- 单头单样本分数为
[5,8],padding mask 为[B,8]。 - 需要使分词规则识别完整特殊 token,同时维护注册集合和模型词表容量;仅改字典不够。
。 - 当前均值聚合实现不变,因为相加可交换;这也是其表达能力限制。
配套程序 examples/17_19_contract_checks.py 的检查记录覆盖注意力数值、位置平移等式、特殊标记拆分和滑窗计数,结果见 qa/extras/17_19_contract_checks.json。原文的 CBOW 50 轮实验、PCA 随机图或 tiktoken 在线资源加载不在这些检查范围内;上游打印的 loss 和相似度仍属于上游记录,不是本书实测。
架构补充的 18 张图分别承担整体结构、类和构造参数、encoder/decoder 初始化、forward、注意力来源、norm 分支和注意力函数截图等作用。原编写记录说明,这些图已用于核对架构,本章改用文字与形状解释,没有复制第三方截图。文本处理的 PCA 图也仅作为随机嵌入演示核对,没有用于推断语义质量。
来源为 Datawhale Happy-LLM 固定提交 1e0b3a1e6f8936b8ba4bbd0673e8e2227d196c96,链接见本章开头;文本处理章节署名蔡鋆捷(福州大学,GitHub)。架构材料所讨论的上游实现可对照 PyTorch v2.5.1 transformer.py。本章依 CC BY-NC-SA 4.0 提供原创改编、解释和纠错,保留 Datawhale 与贡献者归属,不声称官方认可。所有函数出现位置,包括重名 Tokenizer 的不同版本,均在覆盖台账分别标识。