主题
第 04 章 训练规模很大,结论仍要落到证据上
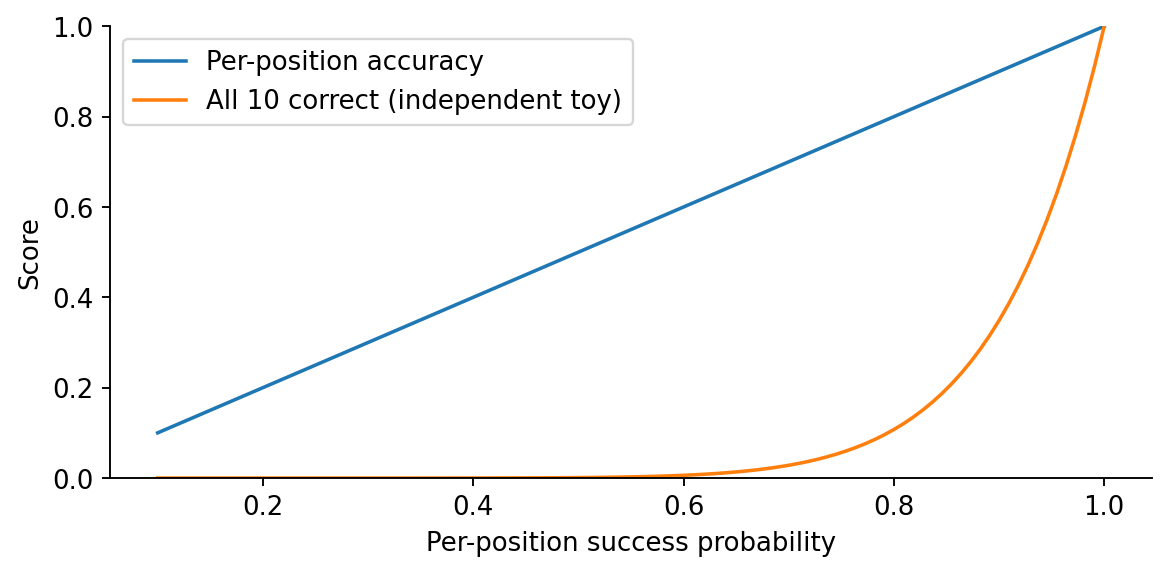
图 04:原创独立性玩具计算:严格全对指标会放大平滑底层变化。(本书自绘)
04.1 “大模型”不是一条统一的参数门槛
源教程第四章把大语言模型放在预训练语言模型的发展线上,讨论上下文学习、指令遵循、逐步推理和多模态扩展。要比较这些能力,先得明确“大模型”指什么。不同研究、产品和时期使用的参数门槛并不一致,LLM 没有统一的参数下限。扩大模型、增加数据、选择合适的目标,可以提高某些任务表现。但要判断它是否可靠、能完成哪些推理或语言任务,仍需查看相应证据。
阅读历史表格时,也需要先分清它记录的是什么。源章列举的发布时间、机构归属和“开源”类别存在简化,开权重、开放代码、开放数据与满足开源许可不是同一回事。这段历史材料有助于理解研究路线如何迅速分化;若把简化后的厂商时间线当作当前产品排名,就会误读它的用途。评估具体模型应记录准确名称、版本、权重许可、上下文配置和测试日期。[源教程 §4.1.1;源固定版本见章末。]
04.2 能完成一道题,不等于具备不受条件限制的能力
上下文学习是把示例放进当前输入,让模型据此生成;通常没有更新权重。微调则通过梯度更新持久参数。两种方法可能解决相似任务,付出的成本却不同:提示占上下文与推理 token,微调消耗训练资源并需维护权重版本。示例的顺序、标签名称、相似程度都会影响结果。GPT-3 的研究使 few-shot 提示受到广泛关注,但不能因此把上下文利用的全部历史都从 GPT-3 算起。[源教程 §4.1.2;GPT-3 原研究。]
指令遵循表示模型根据自然语言要求改变输出行为。这种行为受预训练、指令数据和优化方式影响,仍有失败条件。两条相互冲突的要求、资料中伪装成指令的文字、超出能力的任务都可能让它失败。
逐步推理则需要区分可见的文字与任务是否做对:步骤写得流畅不证明每一步正确,不应把长答案自动计为更强推理。可以检查中间算式、最终答案和换一种表达后的稳定性,但不能仅凭语气评分。
比较不同规模的模型时,某些测量曲线会出现看似突然的变化,这常被称为涌现。解释这种变化之前,需要先问:变化来自模型的能力,还是评分方式放大了差异?若一道多位数任务必须所有位置都正确才得 1 分,单个位置准确率从 0.6 平滑提高到 0.9,十个位置全对的概率就从
04.3 多语言、长上下文、多模态和幻觉的条件
模型在不同语言上的表现是否均衡,需要结合训练数据、分词效率和具体任务判断,“大”这个名称提供不了答案。
长上下文能力也要拆成三个问题:模型能接收多少 token,能否在其中找到证据,能否正确综合证据。位置编码有可外推公式不等于长距离检索可靠。传统 BERT 的常见 512 配置也不是所有预训练模型的硬性上限;不能把某一训练配置说成整个架构的上限。[源教程 §4.1.3。]
多模态模型又多了一层输入转换。视觉编码器可以把图片变成语言模型能接收的向量,两个模块之间仍需要对齐数据和训练;能接收图像,也不意味着能生成图像。第 19 章将处理这个接口。
除了能接收哪些输入,还要检查回答是否有依据。幻觉包括编造事实、错误引用和不受证据支持的断言。RAG 能增加可查材料,却不能保证模型不误读、忽略或篡改材料;增加上下文与消除事实错误是两件事。第 10、11 章会把证据检索与答案忠实度分开测量。
04.4 预训练、SFT、偏好优化分别在改变什么
预训练用大规模文本学习预测分布;SFT 用指令与示范回答让目标行为更常出现;偏好优化让某些回答相对另一些回答更受偏好。这三个阶段构成一条常见路线,实际训练不一定只按这个顺序各做一次。持续预训练、反复 SFT、直接偏好优化、可验证奖励训练都可能出现在不同配方中。[源教程 §4.2。]
SFT 的损失与因果预训练可以同为交叉熵,区别主要在数据与被监督位置。对聊天样本,提示部分常设忽略标签,只在助手回答上计算损失。若所有角色都监督,模型也会学习用户问题的分布;这并非数学错误,但与只优化回答的目标不同。少量 SFT 数据可能改变输出格式,却不能保证注入了覆盖广泛的新知识。不过,SFT 也不能一概归为“只教格式”:有监督数据本身可能包含新事实和技能,效果要结合数据和训练来判断。[源教程 §4.2.2。]
RLHF 的一种经典做法先训练奖励模型。对同一提示的偏好回答
奖励模型训练好后,再优化策略的期望奖励,同时用 KL 惩罚限制偏离参考模型。这一过程仍有风险:策略可能利用奖励模型的缺陷获得高分,偏好标注也可能有偏差。KL 系数决定了提高奖励与限制分布偏移之间的权衡。第 09 章明确区分上游未完成入口和本书补充;第 13 章再处理实际策略优化数学。[源教程 §4.2.3。]
04.5 计算量估算不是采购清单
稠密 Transformer 训练常用粗略估算
算出总量以后,还没有解决如何分配预算的问题。这个乘积公式本身推不出“token 必须是参数量的 1.7 倍”或“20 倍永远最优”。要决定
估算内存时,同样需要把项目拆开:参数、梯度、优化器状态和激活各占多少,不能只看权重大小。一个常见混合精度 Adam 账本可近似为每参数 2 字节低精度权重、2 字节梯度、4 字节主权重及两份 4 字节动量,共 16 字节;具体实现可能不同。激活随 batch、长度、宽度和层数变化,KV cache 主要是自回归推理账目,不能直接塞进这张训练静态状态表。
数据并行让各卡处理不同样本并汇总梯度;张量并行分拆一次矩阵运算;流水线并行把层分给不同设备。ZeRO-1 分片优化器状态,ZeRO-2 再分片梯度,ZeRO-3 再分片参数。分片减少重复存储,同时带来通信与调度成本。因此,哪一阶段效率更好要结合硬件和工作负载测量,不能认定 ZeRO-1 在所有硬件下利用率都最高。
CPU offload 将部分存储移到 CPU 一侧,可以节约设备内存,但也会受到总线带宽和 CPU 内存的限制。具体训练时间不能仅由模型参数量推断。[源教程 §4.2.1 的并行、ZeRO 和 offload 内容。]
04.6 数据配比同样是实验变量
算力预算相同,数据怎么选、怎么混合,仍会改变模型学到的内容。网页、书籍、代码和百科各有覆盖面与噪声。清洗、去重、语言筛选、许可核对和测试集去污染,会影响实际分布。某篇论文的配比不是可直接搬用的“最佳比例”:目标语言、下游任务和质量阈值变了,比例的含义也变了。低资源领域重复采样能提高曝光,也更容易记忆少数样本。训练前应按来源切分验证集,保留清洗规则与统计量,不能只记录总 token 数。
补充练习。 两个系统在 100 道题上分别答对 70 道和 73 道,能否宣布后者全面更强?一个模型训练 loss 持续降低,但独立验证集 loss 上升,优先检查什么?
答案。 不能:还需相同输入、采样设置、数据版本、置信区间和具体错误类型,也不能从单一任务外推“全面”。后一现象应先排查过拟合、训练与验证分布差异、评估实现和数据泄漏,再决定如何调整训练;单纯增加规模不会自动修复这些问题。
core_checks.py --section evidence 只计算前述评分曲线与 FLOPs 示例。配套已保存记录包含这些数值,不包含大模型能力测试。
04.7 来源与证据边界
本章改编 Datawhale Happy-LLM 第四章,按 CC BY-NC-SA 4.0 提供,保留项目归属;新增预算推导和原文强断言的限制说明。固定原章。参考:GPT-3、Chinchilla、涌现测量研究、InstructGPT、ZeRO。本章没有复现论文的大规模训练,也未测量当前商业服务。
04.8 PPO-RLHF 的四个角色,以及原章公式需要修正的地方
前面介绍了奖励模型与策略优化;若继续阅读源章 §4.2.3 的 PPO-RLHF 流程,还会遇到 actor、reference、reward、critic 四个角色。actor 是正在更新的策略,reference 提供固定的行为参照,reward 给完成回答打分,critic 估计前缀状态之后的期望回报。其中,critic 通过预测未来回报来降低策略梯度的方差,训练目标与 reward 的偏好打分不同。
这四个角色可以由不同大小的网络、共享部分参数或其他实现承载,所以仅凭角色数无法推算固定显存;240 GB 这样的数字需要具体配置支持,不能用于所有场景。
参考策略通常对 actor 采样的同一条回答计算概率,而不是各自生成一条回答后对两个字符串算 KL。对某一步状态
若
理解上式时,要区分 old 和 ref:old 是产生 rollout 的策略快照,ref 是稳定的参照策略。critic 则常通过最小化预测值与回报目标之间的误差来训练。
源章把
RLHF 也不要求每个 rollout 都实时找人打分;人类偏好通常先用来训练奖励模型,再由奖励模型批量提供反馈。冻结 reward 的主要作用是稳定打分目标,冻结 reference 的主要作用是定义偏移约束,它们不能简单合并解释成“都是为了保留原知识”。DPO 是另一种直接使用偏好数据的目标,减少显式奖励模型和在线采样训练的复杂度,但不是对所有数据和任务都无差别替代 PPO。