主题
第 09 章 少训练一些参数,究竟省了什么
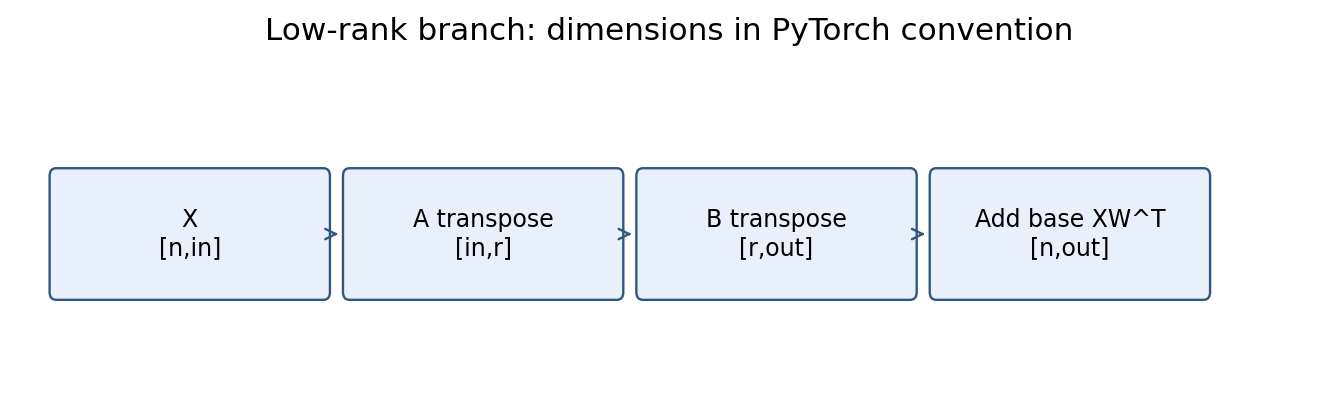
图 09:LoRA 旁路通过低秩中间维度 r,最后和冻结基座输出相加。(本书自绘)
训练参数少了,省下的究竟是权重、梯度,还是优化器状态?本章先用 LoRA 的矩阵计算回答这个问题,再检查源代码怎样接入模型,最后区分量化与偏好训练各自改变了什么。
以下实现细节沿用原稿对固定版本的静态审查。文字修订没有执行示例或训练;数学小例、框架运行和真实微调质量的验证范围会分别说明。
09.1 参数高效微调有不同的插入位置
全参数微调允许所有权重变化,也需要为这些参数承担梯度与优化器状态的开销。参数高效微调则只训练较小的一部分:Adapter 在原层之间插入小网络,prefix/prompt tuning 学习输入或中间层的前缀,LoRA 给已有线性变换增加低秩更新。[源第六章 §6.3.1。]
冻结大部分基座参数,可以减少需要更新的参数及其相关状态,但训练仍要处理激活,并让梯度信号通过相应网络。所以,可训练参数量不能直接换算成全部训练内存;采用这些方法,也不保证每种任务的效果都超过全参数微调。
源教程把 LoRA 概括为不适合学习知识,这个判断需要收窄。低秩限制会影响模型的适应能力,但某项知识能否学会,还取决于数据、秩、目标模块、基座能力和评测方式,不能从一次失败推导出普遍结论。
这里讨论的前提是利用已有基座进行适配。如果要从随机初始化训练整个语言模型,冻结随机基座、只训练少量 adapter,并不是本书此前介绍的从零预训练方案。
09.2 低秩更新怎样进入线性层
先看一个线性层。按 PyTorch 的权重布局,
常见初始化方式是让 A 随机、B 为零。这样新增旁路起初不改变基座输出,也决定了两组参数最初怎样收到梯度:第一步
配套 core_checks.py --section adapters 用小矩阵检查这个现象,并比较合并权重前后的输出。它是独立的数学检查程序;本次没有重新执行,也不能据此认定后面的源代码片段完整可用。
09.3 逐分支阅读源 LoRA 示例
源 LoraLayer.__init__ 记录 r、alpha、dropout、是否合并及是否禁用 adapter 等状态。Linear.__init__ 则先构造普通 Linear 和 LoRA 状态,再创建 A/B 两个线性层、冻结基座 weight、设置 scaling,并按 fan-in/fan-out 约定处理转置。[源 §6.3.4。]
读到这里,还不能把片段当作可直接复制的完整实现:adapter 专用初始化和部分配套函数并未全部展示。冻结 weight 也不会自动冻结 bias 或其他层,接入后需要枚举 requires_grad=True 的参数,确认实际训练范围。
forward 根据状态选择不同路径。禁用 adapter 时,如果增量已经合入基座,就先减去增量,再使用原权重;启用但尚未合并时,先算基座结果,再加上经过 dropout 的低秩旁路;已经合并时,只计算一次基座线性变换。
因此,合并不能只是无条件相加。状态管理不当,重复合并就可能把增量加两遍,禁用和取消合并也必须相互对应。比较合并前后的结果时,应使用 eval 模式:训练中的 dropout 会引入随机性,不能要求带 dropout 的前向结果与静态合并权重逐值相同。
确认分支后,还要检查 LoRA 究竟替换了哪些层。target_modules=['q_proj','v_proj'] 是名字列表,而 re.fullmatch(pattern,key) 接收模式字符串;两种参数形式需要分别处理,不能把源文展示的两段直接拼起来。不同 PEFT 版本与模型架构可能采用不同匹配规则。先打印被替换模块清单,才能发现没有匹配到目标层,或意外替换了过多层的问题。
09.4 PEFT 接入并不替你选择损失
源 §6.3.5 用 LoraConfig 设置 task_type=CAUSAL_LM,inference_mode=False,r=8,lora_alpha=32,lora_dropout=0.1,再调用 get_peft_model 包装模型,并交给 Trainer。包装完成后,模型仍必须提供因果语言模型 logits 和 loss 接口;示例 AutoModel 不对所有架构都等价于 AutoModelForCausalLM。能否自动推断目标模块,也要核对具体模型和版本。
选择 adapter 之后,还要单独选择训练目标。SFT 使用回答 token 的交叉熵,DPO 使用偏好对的相对概率目标,KTO 使用带好坏标签的样本目标。LoRA 决定哪些参数参与更新,并不会把普通 SFT Trainer 自动变成 DPO/KTO 训练器。
因此,源文的“其他无需修改”只能放在有限条件下理解:某些已经配置好的偏好训练器可以复用 adapter 接口。偏好数据、参考策略、损失和训练器本身的配置,仍需要按对应方法准备。
09.5 QLoRA 的 4 bit 不是用整数直接完成所有计算
LoRA 减少需要训练的参数,QLoRA 进一步压缩冻结基座的存储。其研究包含 NF4、双重量化和分页优化器等设计:基座权重以低比特形式保存,计算时按块解量化到适合计算的类型,adapter 和激活通常并非 4 bit。[源 §6.3.1 的 QLoRA 入口;QLoRA 原研究。]
这也解释了两类内存节省从哪里来。冻结参数不需要对应的优化器状态;量化基座则进一步降低常驻权重的存储成本。两者都不意味着训练中的全部数值会以 4 bit 整数计算。
为了说明量化怎样近似实数,本书给出一个对称均匀量化示范。它与 NF4 不同。令
这个小例说明“存储码加尺度”怎样近似实数,不是 QLoRA 实现,也不验证 bitsandbytes、GPU 4 bit 内核或真实微调质量。NF4 的非均匀码本不能由这几行均匀量化冒充。
量化后合并 adapter 还可能需要重新量化,误差与内存占用都要测量。原有验证未提供 GPU、对应依赖和真实模型的训练结果,本次也没有补做这些实验。因此,这里不报告 QLoRA 显存节省倍数,也不把数学小例称为 4 bit 训练复现。
09.6 偏好对齐:上游明确未完成,先学接口和目标
固定版本的主文 §6.4 介绍偏好对齐的动机、RLHF/DPO/KTO 的轮廓,以及它们与 SFT/PEFT 的衔接。独立文件名仍带 [WIP],末尾“7.2.2 奖励模型训练”只有引导文字,没有完成可执行的奖励模型训练,编号也与当前章不一致。
下面补充概念说明,帮助衔接后续章节;这些是本书的原创解释,不代表原教程已经完成相应实现。
强化学习的状态可对应提示与已生成前缀,动作对应下一个 token 或工具调用,策略给出动作分布,奖励评价结果,价值函数估计未来回报,环境模型预测状态转移。语言模型可以承担策略的角色,但这与强化学习定义中的“环境模型”不同。
轨迹
目标是
落实到偏好数据,需要把同一提示、候选回答、chosen/rejected 和标注依据放在一起。较长答案可能更完整,也可能只是冗长,标注标准需要区分两者,避免模型只学到长度偏差。奖励模型通过成对比较学习相对分数,不能当作客观真理的判定器。
DPO 可以写成对 chosen/rejected 的策略相对参考模型 log-prob 差进行 logistic 优化,参考模型与系数都会影响目标。KTO 则不要求每条好坏样本都组成显式比较对,数据组织方式与 DPO 不同。这里只解释这些关系,没有运行偏好训练,也没有补全上游 WIP 程序。
09.7 练习、答案与来源
补充练习。 设
答案。 A/B 共
本章改编 Datawhale Happy-LLM 第六章 §6.3—§6.4 及 WIP 文件,采用 CC BY-NC-SA 4.0,保留项目署名;QLoRA 数学示例和测试为新增。固定目录。原研究:LoRA、QLoRA、DPO、KTO、Prefix-Tuning。
09.8 不能直接运行的 LoRA 片段
原有静态审查发现,源正文的 forward 代码围栏保留了类内缩进,直接单独运行会报缩进错误。即使去掉公共缩进,if 分支和 elif 之间还插入了三引号字符串 主要分支,这是一条独立表达式语句,会打断 if/elif 语法;应改成真正的 # 注释或移到分支内部。
此外,transpose 辅助函数和 adapter 的 reset/merge 完整实现并未包含在这一片段中。本书的低秩矩阵测试是独立重写的完整程序,不以“解析了几个类定义”声称整个片段可运行。
09.9 一个可读懂但未声称训练过的 DPO 目标
最后把 DPO 的目标具体写出来,就能看到它与 SFT 的差别。令同一提示为 x、偏好回答为
它鼓励偏好回答相对参考模型的提升幅度大于 rejected 的提升幅度。若两者相对提升相同,括号为零,损失为
beta 控制目标中的缩放,与普通交叉熵的学习率不是一个量。理解这个公式,可以帮助检查偏好训练需要的输入与损失,但不等于完成训练验证。本节是原创公式展开;上游 WIP 仍未包含完成的偏好训练程序,本次也没有运行 DPO 或 KTO。