主题
第 10 章 评测要回答一个明确的问题
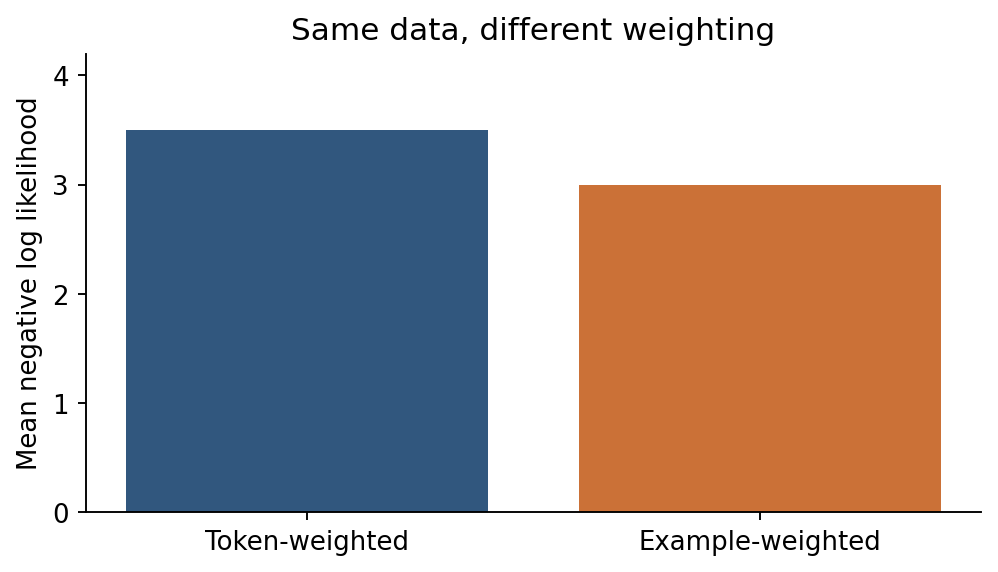
图 10:损失的归约权重会改变报告数字与优化目标。(本书自绘)
模型分数更高,是否就更适合手里的任务?回答这个问题,要先说明测了什么、怎样评分,以及分数能支持多大的结论。本章从实验条件讲到评分代码,再检查数据泄漏和小样本波动。
以下沿用固定教程与原稿中的评测说明,不更新榜单,也不把数学样例当作真实模型成绩。
10.1 分数之前先写实验条件
比较两个模型时,如果提示、采样次数、工具或答案提取规则不同,分数差就不能简单归因于模型本身。为了让别人能复核,应随结果记录模型版本、tokenizer、数据版本、split、提示、示例、最大输出长度、随机种子、采样策略、工具权限与评分程序。服务端会变化的模型还要记录日期和可取得的版本标识。[源第七章 §7.1。]
实验条件一致,也不代表一个平均分足以说明问题。模型可能在常见题型上进步,却犯下更多代价较高的错误;准确率、稳定性、拒答、延迟和资源成本,也需要分别观察。
所以,选择测试之前,先写清应用中哪些错误不可接受。这样才知道榜单上的成绩与自己的任务有什么关系。
10.2 源教程列出的数据集,各自在测什么
源教程列出的数据集侧重点不同。MMLU 用多学科选择题检验知识和问题解决表现,不能概括全部自然语言理解能力。GSM8K 关注小学层级的文字数学题,MATH 涵盖更复杂的数学问题;看这类结果时,还要区分最终答案与解题步骤是否正确。
ARC Challenge 使用科学选择题,HellaSwag 考查常识情境下的合理续写选择。MGSM 则把小学数学题评估扩展到多语言:同一题在不同语言下的表现能暴露差异,但仍不能代表完整的多语言能力。[源 §7.1.1。]
原稿依据原论文对 GPQA 作了纠正:它使用领域专家编写的研究生难度选择题,涵盖生物、物理、化学。源文把它描述为面向客服的开放问答、零样本通用应用,这不准确。题目难度与专业监督问题是它的主要动机,而不是客服场景。比较结果时还应说明所用子集,不能把不同子集成绩混成一个 GPQA 数字。[GPQA 原论文:https://arxiv.org/abs/2311.12022。]
BFCL 的工具调用测试需要看对应版本的任务定义:选择工具、参数正确性、多调用、是否需要工具等都可能分别计分。函数名答对、参数类型却错了,仍不能算一次成功操作。
长上下文测试也要分清具体任务。InfiniteBench/En.MC 属于长上下文评测中的具体任务,不能把某个子任务名概括成所有长篇科学文献理解。needle-in-a-haystack 及 multi-needle 把目标信息插入长文本,主要测定位和提取;即使找全所有针,也不证明能综合整份法律或医学文件。[源 §7.1.1 的工具与长文本类别。]
这里列出名称,是为了比较测试类型,不复刻未经核实的当前榜单成绩。基准版本、题目泄漏和提示设置会改变结论,读者实际选型时应从官方数据说明读取具体定义。
10.3 三种榜单机制,不是一把尺子
源 §7.1.2 的 Open LLM Leaderboard 代表自动基准集合,Arena 代表人类对不同回答的偏好比较,OpenCompass 既有评测基础设施也有基准集合和展示。这些机制回答的问题并不相同。偏好胜率高,可能与回答更长、更迎合提问方式有关;选择题成绩好,也不能保证工具失败后能恢复。
榜单名称与组织形式会变动,本书讨论固定教程里的评测机制,不保证当前服务状态或排名。
金融 CFBenchmark、安全 Flames、日常多轮 BotChat、法律 LawBench、医学 MedBench 是源 §7.1.3 列出的垂直入口。这些入口帮助读者按领域选题;得到测试成绩,并不等于获得实际执业、安全合规或医疗可靠性认证。领域模型还要核对地区、时间、资料版本、允许拒答条件和人工复核。这里不作金融、法律或医疗行动建议。
10.4 从预测到分数,中间有一层容易出错的代码
分类准确率是正确样本数除以总样本数;不平衡数据中,永远猜多数类也可能很高。抽取任务可用 precision=
语言模型困惑度为 core_checks.py --section evaluation。]
生成题要先规定怎样提取答案。模型可能先猜错再纠正,取第一个数字会误判;规则过于宽松,又可能从多个矛盾答案中挑出一个正确值。抽样 pass@k 与单次准确率也不能混用,因为多抽 k 次消耗了额外预算。
如果使用人工或模型裁判,应隐藏候选身份、随机安排顺序、写清评分标准,并抽查一致性。裁判给出的判断同样可能出错,不能当作无误差的事实。
10.5 数据泄漏可以在训练前,也可以在评测时发生
评分程序之外,还要检查测试题是否已经以其他方式进入了开发过程。训练语料直接包含测试题,只是最明显的一种泄漏。按文档切块后再随机分 train/test,会让相邻块共享大段内容;对同一个来源做轻微改写,也可能跨 split 重复。反复用测试集选择 prompt、checkpoint 或阈值,实际上把它变成了开发集。
划分数据时,应先按来源或时间切分,再切块;保留一个不参与调参的最终评估集,近重复检测需要覆盖文本与任务结构。
少量题目上相差几个百分点还可能是抽样波动。比较两个模型时,最好查看它们在同一道题上的配对结果,不要机械套用独立误差公式;题目簇相关时,置信区间也要按簇考虑。没有足够样本和误差分析时,报告“这组条件下观察到差异”比宣称“全面领先”更准确。
10.6 可运行的小评测与练习
core_checks.py --section evaluation 检查 token 加权 loss、困惑度、集合抽取 precision/recall/F1。样例 gold 为 {a,b} 与 {c},预测为 {a} 与 {x},得到 precision=1/2、recall=1/3、F1=0.4。这些是固定样例的评分结果,用来检查实现,不代表任何真实模型成绩。本次文字修订没有重新执行这个程序。
补充练习。 测试集 90% 样本为负类,模型全部预测负类,准确率是多少?正类 recall 呢?RAG 找到正确文档但回答编造了数字,应该归为检索失败还是生成忠实度失败?
答案。 准确率 90%,正类 recall 为 0,因此只看准确率会漏掉完全失效的正类识别。后一种至少是生成忠实度失败;还需检查送入生成器的具体 chunk 是否包含正确数字,不能只看整篇文档 ID。
10.7 来源说明
本章改编 Datawhale Happy-LLM 第七章 §7.1,CC BY-NC-SA 4.0,新增指标推导、GPQA 纠错与实验设计。固定原章。原研究:MMLU、GSM8K、MATH、GPQA、HellaSwag、InfiniteBench。未运行这些完整数据集或更新当前榜单。