主题
第 05 章 把一个小型 LLaMA 风格解码器拆开
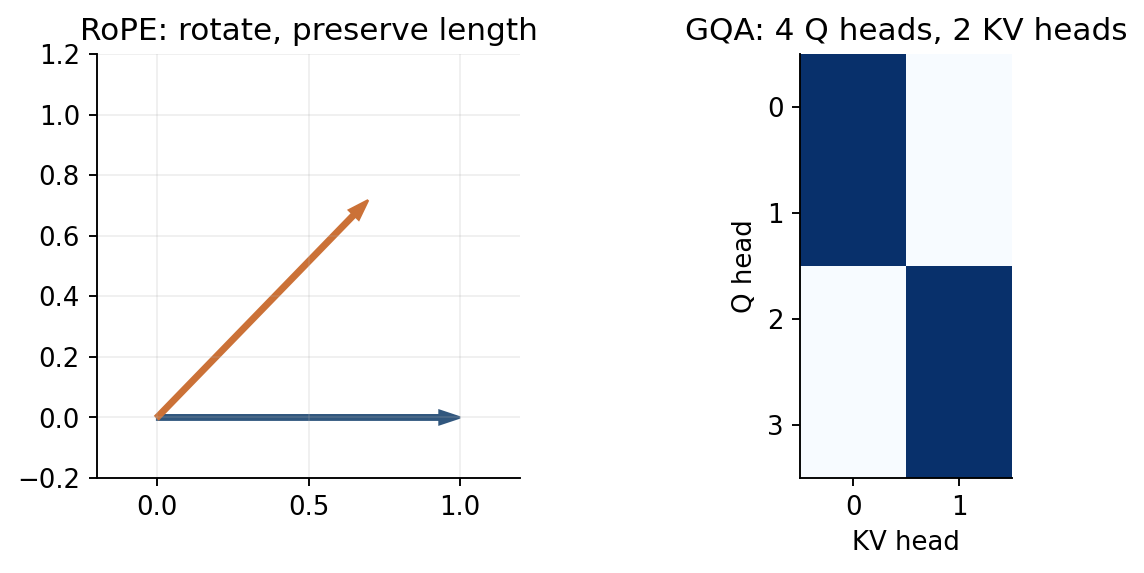
图 05:左图是二维旋转;右图明确 GQA 的分组对应,不是交错复制。(本书自绘)
05.1 先固定尺寸,再开始写层
把注意力、位置编码和前馈层接成一个模型,第一步是约定各层接收和返回的张量形状。上游第五章 §5.1 因此从 ModelConfig 开始。本书用 k_model.py 的 ModelConfig、Attention,见章末。]
配置还包括层数、词表大小、中间层宽度、宽度对齐倍数、归一化 epsilon、最大长度、dropout 和 pad ID。上游默认宽度 768、12 层、16 个查询头、8 个键值头和词表 6144 是一份教学配置,不能作为 LLaMA 2 的官方通用配置使用。model_type="Tiny-K" 用于框架识别;继承 PretrainedConfig 只说明它采用了框架的配置基类,生成和训练接口是否符合 Transformers 约定,还需要逐项检查。
05.2 RMSNorm 调整长度,不减去均值
先看归一化层。给定一个位置的向量
虽然输出逐维缩放,每个分量仍通过共同的分母相互影响。梯度可以把这种关系写清楚。忽略对
第一项直接缩放当前分量,第二项来自所有分量对分母的共同影响。epsilon 防止全零向量除零,也使严格的尺度不变性变成近似性质。
回到实现,上游 _norm 计算平方均值与倒平方根,forward 转 float32 计算后转回原 dtype,再乘 weight;配套的 float64 梯度检查保留 float64,避免强制降精度干扰数值检验。混合精度生产实现需要单独验证溢出和输出 dtype。
05.3 RoPE 为什么能把相对位移放进点积
归一化控制向量的尺度,RoPE 则把位置信息写进 Q、K。把相邻坐标写成
第
precompute_freqs_cis 的输入应是每头宽度,而非总模型宽度。它建立 reshape_for_broadcast 将表重排为 apply_rotary_emb 先按相邻二元组拆开实部、虚部,再旋转、stack、flatten 回
阅读其他实现时,还会看到把“前半维、后半维”配对的方式。它与相邻配对都很常见,但必须和权重、位置约定保持一致,不能只凭 RoPE 这个名称直接替换。
推理时若使用缓存,还要处理位置偏移:追加 token 的位置不能每次重置为零。本书小模型不实现 KV cache,每次重算裁剪后的窗口,因此配套实验没有验证缓存正确性。
05.4 GQA 减少 K/V 头,并没有删除 Q 头
普通多头注意力中,Q、K、V 都有 [0,1] 扩展成 [0,0,1,1],分别服务两组 query。如果扩展成 [0,1,0,1],query 与键值头的分组对应关系就变了。[源教程 §5.1.3.1、§5.1.3.3;GQA 研究见参考。]
repeat_kv 在
减少键值头,首先减少了投影参数:K/V 每个只需要
上游 Attention.__init__ 构造 Q/K/V/O 投影,前向旋转 Q/K、重复 K/V、拆头并计算因果注意力。flash 的值只检查是否存在 scaled_dot_product_attention,没有使用配置里的 flash_attn 开关。还需区分 API 与执行内核:即使存在这个 API,当前设备也未必选中 FlashAttention 内核,CPU 可以使用数学后端。本书不把 CPU 测试称为 FlashAttention 性能验证。手写回退分支还需特别测试左填充的全屏蔽查询行。
05.5 SwiGLU 用一个分支控制另一个分支
源 MLP 使用
增加分支后,参数预算也要重新计算。普通两层 FFN 若中间宽度为 multiple_of 的倍数。向上对齐是为了配合计算布局,数学公式本身并不要求这样做。MLP.__init__ 明确给出 hidden_dim 时不再按默认公式推导;forward 顺序就是门控、下投影、dropout。
最后把这些模块组装成一层。DecoderLayer 保存层编号,创建两次 RMSNorm、一个注意力和一个 MLP。前向为
05.6 词表头、共享权重和输出协议
Transformer.__init__ 创建 embedding、多层 decoder、末尾 norm 和词表线性层;将 tok_embeddings.weight 指向 output.weight 后,输入和输出共享同一参数。统计参数时,这份共享权重只能算一次。
位置表注册为 persistent=False 的 buffer,意味着跟随设备移动,但不写入 state_dict,重载时要依据配置重新生成。
_init_weights 用正态初始化;随后对名称以 w3.weight 或 wo.weight 结尾的参数重新缩放。这里 w3 是门控的另一路上投影,不能把代码注释中的“残差投影”不加核对地套到它身上。
这些层能接起来之后,还要检查调用方如何传入数据、取出结果。上游 forward 有两个接口问题。第一,形参 tokens 没有默认值,虽然内部接受 kwargs['input_ids'],纯粹调用 model(input_ids=...) 仍可能在进入函数前就因缺少 tokens 失败。
第二,输出写入 last_loss 而非框架训练器通常读取的 loss,且为未归约向量。这些协议差异不会因继承基类而自动消失。配套训练脚本自己处理 mask 和归约,因此特定调用方式可以配合这份代码工作;换成其他 Trainer 时,仍需适配输入与输出约定。
_prepare_attention_mask 把 3D/4D mask 取一个切片后转为正值布尔掩码,适合它约定的有效位置标志,却不能无损接收一般加性 attention bias;例如允许位置 0、禁止位置负无穷的浮点 mask 会全部判为 False。接入外部 mask 前,必须先确认它表示有效位置,还是加到分数上的偏置。
选择推理输出位置时也有布局要求。sum(mask)-1 只适合从左开始连续有效、右侧填充的布局。mask [0,0,1,1] 的最后有效位置是 3,而这个公式得到 1;第 07 章用它检查生成入口的左填充冲突。
05.7 本书实现与检查
配套 examples/core/tiny_lm.py 是独立小实现:Config 固定尺寸,RMSNorm 保留计算 dtype,rotary 处理相邻配对,Attention 显式实现 GQA 与因果矩阵,Block 组合规范 Pre-Norm 残差,TinyLM 输出所有位置 logits。它只接受没有 padding 的非空训练块,使用范围不包括任意带填充的聊天批量。
配套已保存的 CPU 实验使用
可以运行 python examples/core/core_checks.py --section architecture 检查 RoPE 保范数、共同平移保持点积、RMSNorm 与 RoPE 的 float64 自动微分对照有限差分,以及 GQA 重复顺序。已保存的检查记录位于 qa/core/checks.json,其中这些检查均通过。记录验证的是上述代数与数值性质,不能据此认定整个上游模型或 GPU 内核已经复现。
补充练习。 如果
答案。 第一种
05.8 归属与参考
本章据 Datawhale Happy-LLM 第五章 §5.1 与 固定 k_model.py 独立改编,新增实现、审查与测试;适用 CC BY-NC-SA 4.0。原研究:RMSNorm、RoFormer、GQA、GLU Variants。完整上游署名和许可见书前说明。
05.9 正文代码与独立文件不是同一版本
第五章 Markdown 内的 Transformer.forward 仍固定 ignore_index=0,没有独立 k_model.py 后来加入的 attention_mask 处理。其 Attention 和 DecoderLayer 的接口也未传 padding mask。因此正文片段主要用来理解数学组装,独立文件则增加了部分批量生成与填充逻辑;这些新增逻辑仍有前文指出的限制,使用时需要逐项核对。两处共有的 RMSNorm、RoPE、GQA 和 MLP 对应 §05.2—§05.5;初始化、共享权重、输出容器对应 §05.6。源码映射台账分别记录了重复定义,重复出现不代表新增了一种算法。
正文的 generate 用 if idx_next == stop_id 判断停止,单元素张量可能工作,batch 大于 1 时会遇到张量布尔值歧义;而且在拼接之前 break,返回结果不包含 EOS。独立文件已经换成逐行 finished 标志,并把 EOS 拼进输出后再检查全部完成。是否返回 EOS 会影响后续解码与测试,见 §07.4。
Markdown 里单独展示的带缩进方法块不是可独立运行脚本,需要结合相应的类阅读。单独解析这种片段失败,只说明它缺少语法上下文,不能据此否定算法。
RMSNorm 的示例围栏把 out: 和 torch.Size([1, 50, 768]) 放在代码后,前者不是合法 Python。它标注的是上游示例输出,不能当作本书实验的运行记录;执行时也不能原样运行整个围栏。配套测试以完整程序为准。