主题
第16章 ReTool:工具执行反馈、奖励与隔离边界
解释器返回一个数值,或报出一个错误,模型接下来会怎样做?ReTool 把这些反馈接回生成过程。本章既检查这条轨迹怎样训练,也检查执行环境实际提供了哪些保护,哪些仍然缺失。
本次只做固定源码说明的文字审读,不执行模型生成代码,不重跑离线实验,也不把协议检查当作隔离安全验证。
16.1 把计算交给工具,也把工具失败放进学习过程
模型生成一段 Python 计算式,解释器返回数值或异常,模型再决定怎样修改推理。反馈可以在推理中途改变后续动作,这使流程比“先完整推理,最后调用计算器”更灵活。不过,轨迹和执行成本也会增加,而且模型生成的程序仍是不可信输入。ReTool 原论文讨论这种强化学习方向;本章核对的是Happy-LLM 固定实现。
本书不执行模型生成代码。离线 fixture 只把请求映射到预写结果,足以检查解析、消息拼接、奖励和预算;它不能证明真实解释器隔离安全,也不能证明模型学会使用工具。
16.2 工具调用与终局答案是不同类型
先确定一次输出属于哪种动作。protocol.py 声明 code_interpreter 工具和调用格式,在工具调用分支中,parse_assistant 要求恰好一个完整工具调用,后面不能再跟内容,代码本身也必须非空。Python 会用到尖括号和引号,所以不能照搬搜索 query 的字符限制。没有合法调用的输出,则进入最终答案或非法分支。
ParsedAssistant 保存类型、规划文本和代码;initial_messages 放入系统约束与题目;tool_message 关联调用 ID;stop_sequences 提供当前模型结束本轮的标记。这些信息共同决定请求怎样解释、结果接回哪里。
_build/_render 类工具将 chat template 的返回转换成一维 token,并明确不重新编码已经采样的 assistant 文本。build_next_prompt 使用占位 assistant 内容来确定模板增量边界:真实文本可能含有 </think>,触发模板拆分 reasoning/content;如果用真实文本定位边界,就可能找错位置。_encoded_text_tokens 与 _suffix_prefix_overlap 负责统一类型与消除结束符重叠。这是与 Search-R1 实现相近但非完全相同的地方。
reward.py 的 extract_last_boxed 以花括号计数提取最后一个闭合 \boxed{…},能处理嵌套;answers_equivalent 调用 math_verify 判断数学等价。score_answer 按正确+1、错误−1给终局奖励。与 GRPO 的简单字符串匹配相比,这里能处理更丰富的表达式,但也增加了依赖、解析边界和错误诊断的复杂度。
符号解析本身仍需限制时间与复杂度,不能因为使用了数学库,就认为任意字符串都能安全、准确地处理。
16.3 从代码动作到新的上下文
RolloutConfig、AssistantTurn、Trajectory、SampleRequest 延续上一章的职责,PendingExecution 另外记录待执行代码,以及它属于哪条轨迹。
推进一轮时,make_request 先扣除已占用的上下文预算,read_sequence 保持实际 token 与 logprob 对齐。begin_advance 保存本轮动作,判断需要调用代码工具还是终止;execute_pending_async 并发提交同轮代码请求,finish_advance 再将执行结果接到下一轮 prompt。
fit_tool_content 与搜索版不同,它更倾向保留输出尾部,因为最终数值和 traceback 的错误位置常在那里。这种选择也有代价:长输出头部可能包含单位、列名或必要条件,只留尾部不保证语义完整,日志中应明确标记截断。若工具观察装不进上下文,轨迹结束,不能越过最大长度继续生成。
advance_round 统一处理一轮动作与执行,再写回结果。rollout_batch 是同步入口,已有事件循环的 eval 应 await rollout_batch_async,不能嵌套 asyncio.run。score_trajectory 赋终局奖励,assign_group_advantages 按同题中心化;退化组计数在 train.py 统一完成,以免日志双计。
所有 assistant 动作共享终局优势,工具反馈 token 的优势为0。这种信用分配容易实现,但无法区分两种过程:错误代码是否带来了有益反馈,还是只造成了无价值的重复执行。如果最后答对,无效调用也可能获得正信号。
因此,除了终局奖励,还应分别查看调用数、成功率、超时率和答案收益。答对了,并不自动说明这条工具路径高效。
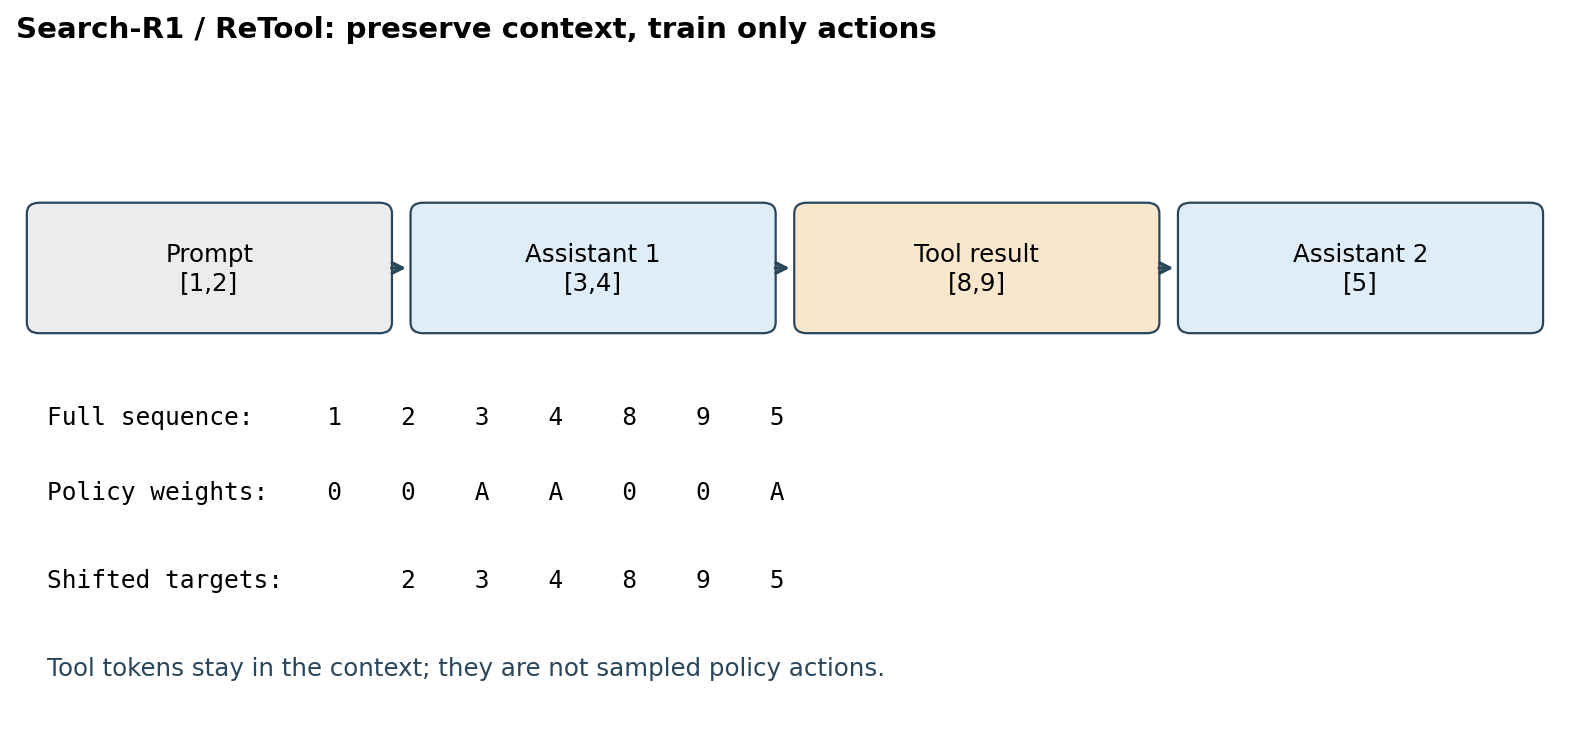
相同的反馈 mask 也适用于代码解释器:观察不是被采样的策略动作。
16.4 源码的 LocalPythonSandbox 能做什么,不能做什么
sandbox.py 的 LocalPythonSandbox 用新的 Python 子进程运行每次代码,没有跨调用变量状态;ExecResult 保存是否成功、stdout、stderr、returncode、超时和延迟;SandboxStats.metrics 把累计计数换成比例。
run_code 用 argv 列表启动解释器,不经过 shell,代码通过 repr 放入引导串。这样可以减少 shell 转义问题,但不限制 Python 代码本身的能力。
源码提供了几类资源控制。BoundedSemaphore 限制并发;进程组和 wall-clock timeout 便于终止子进程树,另有 RLIMIT_CPU;stdout/stderr 写入临时文件,由 _read_capped 与 _truncate_tail 只读取有限尾部;环境变量则限制 BLAS 线程数。
arun_code 用线程池适配异步调用,format_tool_content 将结果区分为成功、错误、超时和无输出。这些处理能描述执行状态,但还不能回答程序究竟被允许访问什么。
检查访问范围,就会看到另一组限制:子进程继承 os.environ,工作目录、文件访问和网络也没有被这个类隔绝。代码没有建立容器/虚拟机安全边界,没有网络禁用、秘密清除、只读根目录或严格磁盘/内存配额。将输出落盘只限制读回内存,不限制子进程写满磁盘。因此,这些措施属于稳定性保护,还不足以构成可以运行任意不可信程序的安全沙箱。本书不运行 run_code 或 arun_code。
输出清洗的范围也要说清。sanitize_tool_content 替换少量聊天模板标记,以免它们直接污染 observation 边界;它并非通用提示注入防御,也不进行代码安全审查。
另一个容易被名字误导的函数是 ensure_trailing_print。它只是逐行字符串启发式:最后一行不是以 print 开头就包进 print(…)。赋值、return、注释、缩进块、多行表达式都可能被它改坏;它不解析 Python AST。是否需要更稳健的 AST 变换,要在理解这些行为之后决定,不能仅凭函数名认定转换正确。
| 风险 | 当前措施 | 仍缺什么 |
|---|---|---|
| 永不结束 | CPU/墙钟超时、杀进程组 | 边界外资源及系统级清理验证 |
| 巨量输出 | 临时文件、读尾限额 | 磁盘配额和执行期输出限制 |
| 读取机密 | 未提供隔离 | 无秘密环境、严格文件权限/隔离 |
| 发起网络请求 | 未提供网络封锁 | 网络默认拒绝与明确白名单 |
| 返回恶意指令 | 替换模板字符 | 把工具内容视为不可信数据 |
16.5 数据准备、训练与公平评测
prepare_data.py 的 strip_dapo_template 只剥完整外层模板,残缺时保持原文;normalize_row 统一 DAPO 题目与答案,write_jsonl 持久化,main 下载并划分 train/dev。本书不运行下载。data.py 读取、验证、固定种子打乱、循环取批;MathExample 是问题与参考答案容器。
整理训练数据时,train.py 的 build_datum 检查每轮 prefix 扩展,保留观察的真实 target,同时把它的 advantage 置零;build_training_datums 跳过零信号。datum_size 与 datum_loss_token_count 分别统计计算长度和学习长度,pack_micro_batches、weight_micro_batch_for_global_mean 则沿用上一章的装箱与样本加权推导。
日志里,rollout_metrics 额外汇总代码执行统计,merge_trainer_metrics/pick_mean_loss_metric 避免混用损失口径;serializable_config/save_checkpoint/main 分别负责配置、持久化和训练控制。两章可以共用数学解释,但具体代码目录与功能差异仍需分别核对。
评测入口 eval.py 同时支持 text-only 与 retool。load_aime25 验证本地评测结构;extract_last_boxed 处理嵌套花括号;normalize_aime_answer 把前导零等规范成整数字符串。
build_text_prompt_ids 构造纯文本单轮条件;evaluate_problem_text_only 对每题采样
对
这里
只固定
16.6 离线反例、练习与答案
配套 examples/13_16_offline_rl.py 检查 print(2+2) 请求对应的固定返回 4、未知请求拒绝、观察 mask,以及前缀不一致时的拒绝。这些输出字符串是预先设置的测试输入,fixture 不解释或执行代码。
本次没有重跑该程序。即使这组协议检查通过,也不能称作“代码执行通过”,更不能据此确认真实解释器的隔离安全。
补充练习一:两条轨迹奖励 [+1,−1],中心化优势是什么?答案仍为 [+1,−1];若都正确则为 [0,0]。能否因此删除所有成功组?训练确可跳过无信号组,但评测统计仍应保留它们。
补充练习二:ensure_trailing_print 对最后一行 x=3 会产生什么?答案是 print(x=3),在这里不再等价于给变量赋值再输出。测试字符串变换就足够暴露问题,无需启动子进程。
补充练习三:只有超时限制的本地子进程,能否读取本机密钥?答案:如果权限和路径允许,完全可能;超时只控制时间,不限制读取对象。部署前必须另建经过评估的隔离环境,且不把凭证传入。
来源与改编说明
本章依据 Datawhale Happy-LLM 固定提交的docs/chapter8/retool/README.md,以原创叙述、推导和离线反例扩写。第八章实现原署名及 agentic-rl-lab 来源见上游 README;Extra-Chapter 作者归属保留在全书授权页。本章与配套改编采用 CC BY-NC-SA 4.0,仅非商业使用,不代表原作者认可。文中的本地结果只证明指定离线检查通过,不代表复现上游模型效果。