主题
第 08 章 使用 Transformers,仍然要核对模型和数据的约定
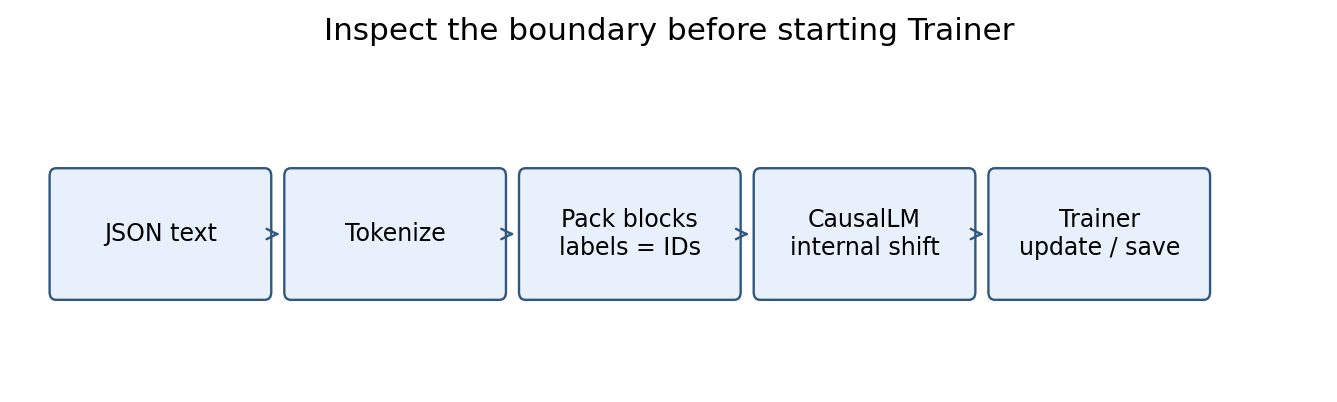
图 08:框架内部 shift 与手写外部 shift 只能选择一处。(本书自绘)
把训练交给框架后,仍有几件事需要自己确定:模型从哪里开始学,输入和标签怎样对齐,哪些位置参与损失,以及训练结束后用什么判断结果。本章沿源代码的数据和训练流程检查这些约定,帮助读者在启动训练前发现配置与实际行为的差异。
以下讨论针对本章引用的固定版本。代码片段、配置值和 notebook 单元范围来自原有静态审查;本次文字修订没有运行这些训练或下载入口,也没有验证新版本兼容性。
08.1 从配置构建和从权重加载,差了一整段训练历史
先分清三个名字相近、作用不同的调用。AutoConfig.from_pretrained 读取结构配置;AutoModelForCausalLM.from_config 按配置随机初始化模型;模型的 from_pretrained 则加载已有权重。配置读取接口里出现 pretrained,不代表随后随机初始化的模型继承了已有知识。
源第六章用 Qwen2.5-1.5B 配置演示从零训练,主脚本也允许传入已有模型继续训练。选择前一条路径,训练从随机参数开始;选择后一条路径,已有权重就是起点。两者所需预算和训练结果的含义因此不同。[源 §6.1.1—§6.1.2,pretrain.main。]
这套工具各有分工:Transformers 提供模型接口与加载,Datasets 处理数据映射与缓存,Trainer 组织训练循环,DeepSpeed 提供部分分布式和内存优化。它们能省去重复工程,但标签错误、数据泄漏或 tokenizer 不匹配仍需自己检查。源码中的 trust_remote_code=True 还可能让加载过程执行模型仓库代码。本书只作静态阅读,没有下载权重或执行这些远程代码。
参数名称也要追到实际使用处。预训练脚本的 ModelArguments 包含模型、配置、tokenizer 路径及 dtype;DataTrainingArguments 包含训练文件列表、block_size 和预处理 worker 数。SFT 的参数类则包含已有模型路径、dtype、训练文件和块长。源码虽然声明了 dtype,却没有在模型加载调用中完整使用它。因此,看到 dataclass 中有一个字段,还不能断定相应设置已经生效。
08.2 tokenize、拼接、切块和 shift 的边界
数据先经过 tokenize_function:批量提取 text,交给 tokenizer,得到 input_ids 以及可能的 attention_mask。随后 group_texts 将每个字段分别展平,按固定长度切块,再复制 input_ids 作为 labels。[源 §6.1.3;pretrain.py 的嵌套函数。]
这里没有提前移动 labels。标准 CausalLM 的损失计算通常会在模型内部,让当前位置的 logits 对齐后一位置的标签;具体行为仍应以所用模型为准。第 07 章手写模型则在外部完成右移。如果把已经右移的标签再交给内部 shift,目标通常会变成相隔两个位置。因此,接入模型前要先确定由哪一处负责对齐。
切块还有一个容易忽略的分支。源实现遇到总长度大于等于 block_size 的拼接结果,会向下取整,丢掉尾部不足一块的 token;总长度小于 block_size 时,却保留这个短块。使用 batched map 时,丢弃发生在每个映射批次,而非只发生在整个语料末尾。
这会影响后续组 batch。多个映射批次可能留下长度不同的短块,default_data_collator 又不负责自动 padding,于是堆叠可能失败。可以过滤短块,也可以改用支持 padding、并能正确忽略填充标签的 collator;无论选择哪种,都应记录丢弃或补齐了多少数据。
跨文档拼接同样需要明确规则。如果边界处没有 EOS,前一篇结尾就会被用来预测下一篇开头。加入 EOS 能提供边界标记,却不会自动阻断跨文档注意力;若要求各段互不读取,还需段内 mask。缓存也不能代替这类检查:命中缓存只说明某份映射结果被复用。为了复现,应同时记录 tokenizer、源码、输入哈希和关键参数。
08.3 Trainer 入口里有哪些实际动作
pretrain.main 把前面的步骤串起来:解析三组参数后初始化 SwanLab,设置日志、检查输出目录中的 checkpoint、设置 seed;然后选择随机初始化或加载权重,读取 tokenizer 和 JSON 数据,执行分词与分块;最后创建 Trainer,选择恢复路径,训练并保存。[源 §6.1.4—§6.1.5。]
预处理中的 main_process_first 让主进程先执行,其他进程随后有机会复用缓存。它并不表示其他进程永远不会走到映射语句,因此还要结合实际缓存和分布式配置判断执行过程。
启动前也应检查输出目录与日志。原有审查记录指出,输出目录非空却找不到标准 checkpoint 的情况下,源码有报错检查;使用时还应核对该检查的触发条件及覆盖设置。日志语句 logger.info('训练集特征:', column_names) 没有为参数提供格式占位符,可能在格式化时出错,应使用 %s 或格式化字符串。参数量统计除以
IterableWrapper 将 dataset 包成迭代式对象,但长度、shuffle 和分布式分片怎样处理,要按项目固定的 torchdata/Trainer 版本核对。源码依赖旧版接口,requirements 记录了依赖,并不保证换版本后仍兼容。
同样,Trainer 默认使用的 collator 不能一概理解成做 MLM。是否随机遮词取决于具体 collator,源 notebook 中“默认为 MLM”的注释不能当作一般规则。原有验证没有安装这组框架或运行 Trainer 训练;书中的参数更新验证使用前章独立 CPU 程序,两者的验证范围应当分开。
08.4 SFT preprocess 的标签错误为何严重
SFT 的 preprocess 接收多条 conversations,每轮含 from 和 value,手工拼接 system、human、assistant 标记及换行,再补齐到 max_len。SupervisedDataset.__init__ 一次把全部选中样本预处理成张量;__len__ 返回样本数,__getitem__ 返回 input_ids、labels 和 attention_mask。也就是说,样本在开始迭代前已经处理并存入内存,数据大时要留意这部分开销。[源 §6.2.1—§6.2.2。]
标签设置中的关键问题是 IGNORE_TOKEN_ID = tokenizer.pad_token_id。普通 CausalLM 的交叉熵通常用 -100 表示忽略位置;除非具体模型另有实现,合法的 pad ID 仍是需要预测的类别。于是,原本希望忽略的用户和 system 位置,会变成要求模型预测 PAD 的目标。
修复时应只把不参与监督的 label 设为 -100,input_ids 仍保留合法词表 ID。两者用途不同:输入要提供上下文,标签决定哪些预测计入损失,不能把它们同时替换成 -100。
标签区间也不能只靠固定长度推算。源代码中的 len(system)-3、[:-2] 等写法依赖特殊标记与换行的具体编码长度。换 tokenizer 后,这些长度可能变化;即使长度断言通过,也不代表标出的区间恰好是助手回答。应按每段实际 token 长度构造 mask,并保留需要学习的助手终止标记。human 与 user 的选择同样应服从模型使用的聊天模板。
读取消息时还有两个边界:source[0] 要求列表非空;若第一项不是 human,代码直接丢弃一项,可能丢掉系统消息或其他角色。attention_mask 又由 input_ids != pad_id 推导,如果 PAD 和 EOS 共用 ID,真实 EOS 也会被屏蔽。
最后,命令行参数未必控制了实际长度。这里的 main 只读取前 10000 行,并硬编码 max_len=2048,没有使用声明的 block_size。启动训练前,可以先逐项对照两三个样本的 token、label 和 mask,检查这些边界;这有助于发现错位,但不能代替对全部数据的检查。
08.5 DeepSpeed JSON 与 shell 配置逐项读
先看 ds_config_zero2.json 的 stage=2:它对优化器状态和梯度进行分片,参数仍复制。offload_optimizer.device="none" 表示未将优化器卸载到 CPU,所以即使同时出现 pin_memory,也不能据此认定已启用 CPU offload。
通信相关字段还包括 allgather/reduce_scatter、overlap_comm 和 contiguous_gradients,它们控制通信与梯度缓冲的组织方式。bucket size 的 2e8 通常是元素数量,不能直接换读成 200 MB;实际字节数还取决于元素类型。
有些配置要等集成层结合训练参数解析。optimizer 指定 AdamW,但学习率、betas、epsilon 和 weight_decay 都设为 auto;scheduler 使用 WarmupLR,warmup 上下限与步数也为 auto。fp16 与 bf16 的 enabled 同样是 auto,这不表示两套精度同时启用。
梯度累积、裁剪、全局 batch 和每卡 micro-batch 也由集成层解析。通常可以按“每卡 batch × 数据并行卡数 × 累积次数”计算有效全局样本 batch,但样本长度和有效 token 数仍须另外统计。
pretrain.sh 与 finetune.sh 给出两张卡的配置样例,包含机器本地路径、batch=16、累积=4、学习率
脚本第一行单独设置 CUDA_VISIBLE_DEVICES=0,1,没有 export。如果该变量此前也未导出,子进程未必收到它,应在启动命令前显式传入或 export。两份脚本还关闭了评测、开启了 SwanLab;训练日志与训练完成都不能代替独立评测。本书没有运行这些样例。
下载脚本通过 CLI 获取模型或 BelleGroup 数据,使用镜像及示例路径,原有审查还指出 os.system 的退出状态缺少充分检查。使用前应分别确认下载是否成功、文件是否完整、许可是否允许所需用途。requirements 只记录上游依赖,不代表应当自动安装和执行其中所有内容。
08.6 三个 notebook 的每段在做什么
pretrain.ipynb 先展示预训练,再转入 SFT。按原有单元编号,0—1 引入预训练,2—5 读取配置、随机创建模型并展示结构与 tokenizer;其中 .to('cuda') 明确要求 GPU。6—9 读取 JSON 数据和字段,10—13 定义分词、查看结果、定义分组并执行映射,数据处理机制与 §08.2 相同。
14—17 设置 TrainingArguments 与 Trainer 并启动训练;由于 eval_dataset=None,这一入口没有独立评测。18—21 转向 SFT,读取数据与 tokenizer;22—25 定义并测试 preprocess、Dataset,再构造训练集,仍需检查 §08.4 的标签和长度问题。notebook 在 Dataset 类内截取前 10000 项,脚本在读取文件时截取,只是限制发生的位置不同,不能据此判断学习目标不同。
process_dataset.ipynb 只有一个代码单元:打开目标文件后按 i<=1000000 循环,原审查记录的读取次数是 1000001 次。即使提前遇到文件结束,循环仍继续写空串。统计有效样本时应以成功读取的行数为准,不能直接使用循环次数。
whole.ipynb 的名称也不代表完整训练流程。单元 0—2 是 tokenizer 规划说明;单元 3 使用 ByteLevelBPETokenizer 训练 52000 词表,但 dir_path="" 仍待填写,os.listdir 返回的文件名也需与目录拼接。单元 4 则从另一个示例目录加载 vocab/merges,添加 BertProcessing,设置截断,再编码世界语示例。保存路径与加载路径没有接通,这份 notebook 也不包含完整 LLM 训练,不能将它写成已复现的全流程。
08.7 练习、答案与来源
补充练习。 已经把标签外部右移后,再送入内部 shift 的 CausalLM,会预测距离当前位置几步的目标?如果 block_size=8、一次映射只有 5 个 token,源 group_texts 返回什么?
答案。 通常变成跨两步对齐;应只 shift 一次。后者返回一个长度 5 的块,而不是丢弃或自动补齐到 8;之后默认堆叠不同长度块可能失败。
本章改编 Datawhale Happy-LLM 第六章 §6.1—§6.2、实践 readme 与三份 notebook,CC BY-NC-SA 4.0,新增逐步审查。固定目录。框架接口以项目固定代码为讨论对象;不承诺未经验证的新版本兼容,不声称本次运行了 Transformers、DeepSpeed 或 GPU 全参数微调。