主题
第 11 章 RAG 先找证据,再检查回答有没有用对证据
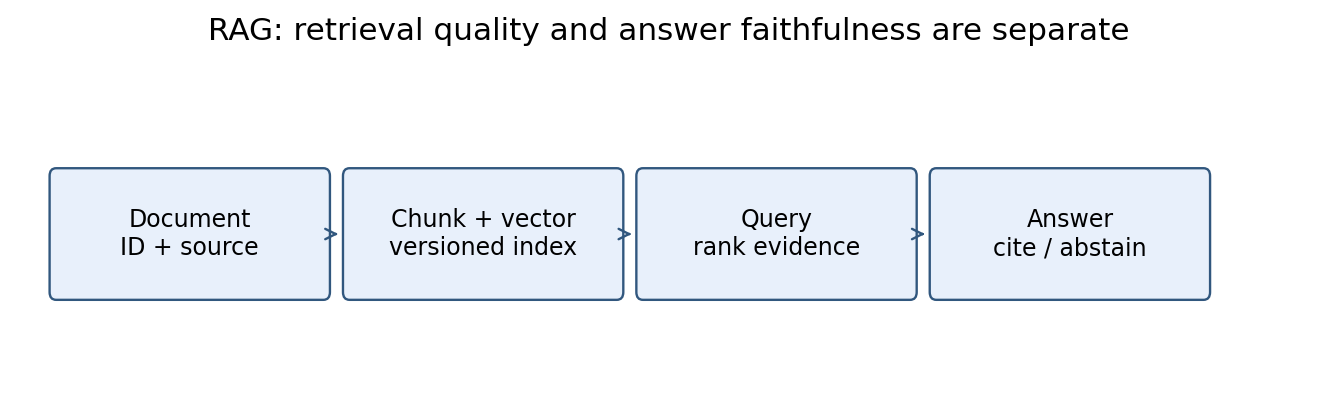
图 11:先追踪证据来源,再分别检查检索和回答。(本书自绘)
同一个错误回答,可能是检索没找到证据,也可能是生成器没有用好证据。本章沿文档读取、切块、向量检索到回答生成的顺序,检查怎样保留来源、定位失败。
实现细节来自原稿对固定源码的静态审查;离线样例的既有结果会单独说明。本次文字修订没有运行联网 demo 或重新执行实验。
11.1 检索和生成是两个可以分别失败的系统
想让模型回答一份新文档中的问题,不一定要先重新训练。RAG 把问题交给检索器,找出相关片段,再把片段与问题交给生成器。知识更新主要发生在索引和资料库中,权重可以不变。不过,找到文档之后仍需检查回答:来源可能过时,片段可能缺少条件,模型可能误读,资料中也可能夹带恶意指令。[源第七章 §7.2.1—§7.2.2 Step 1;RAG 原研究见章末。]
为了追溯这些问题,最小系统也应保留文档来源、chunk ID、内容、向量和索引版本。问题向量与文档向量必须来自兼容的 embedding 模型与维度。只存向量数组和文本字符串,短期能跑,更新模型或资料后却很难追溯错误。
11.2 文档读取的损失不能留到生成阶段补救
ReadFiles.__init__ 保存根路径并调用 get_files;后者递归选择 .md、.txt、.pdf。由于遍历没有显式排序,跨环境时文件顺序可能不同。get_content 逐文件读取并切块后展平,只保留文本,原文件路径与页码会丢失。后续若需要引用原文,就应让每个 chunk 一起保存来源元数据。[源 RAG/utils.py,§7.2.2 Step 2。]
read_file_content 根据扩展名选择读取方法。read_text 按 UTF-8 读取;read_markdown 先转成 HTML,用 BeautifulSoup 提取纯文本,再用正则删除网址。这一步可能连溯源链接和部分内容一起删掉。
PDF 需要另外检查。read_pdf 将各页 extract_text 的结果拼接,没有处理返回 None、扫描页 OCR、表格顺序与页间分隔。抽出了字符串,也不代表阅读顺序正确,因此仍要抽查。另一个入口 Documents.__init__ 和 get_content 读取的是已经整理好的 JSON,不负责校验其结构。
get_chunk 以行组织文本,使用 cl100k_base 计算长度,目标是最大长度减去 overlap 后的主体块。长行按 token 分片,普通行逐步加入;但重叠部分通过 prev_chunk[-cover_content:] 按字符截取,混用了 token 和字符单位。由于两处计量不同,最终 chunk 不一定满足所声称的 token 上限。
边界值也需要检查。cover_content=0 时 Python 的 [-0:] 等于整串,也会意外复制前块;cover_content>=max_token_len 会使步长非正。应检查
长度正确之外,还要看内容是否完整。行首尾 strip 会改变代码缩进,换行也不总代表一句完整话。更稳妥的方法按段落、句子或语法边界优先分组,再用硬 token 上限兜底。overlap 太小容易丢关系,太大增加冗余、索引成本和重复证据;因此应结合任务的检索结果调节,不能认定固定 150 总是最佳。
11.3 embedding 和余弦相似度分别承担什么
BaseEmbeddings.__init__ 保存 path 与 is_api,get_embedding 抛 NotImplementedError,由子类实现。cosine_similarity 将两个向量转 float32,遇到 NaN/Inf 时返回 0,零范数也返回 0,其他情况按下面的公式计算
当两个非零向量均归一化时,它就是点积;未归一化时,直接点积还会受长度影响。维度不一致时应主动报错。
源实现把坏向量转换为 0 分,虽然便于演示,却可能掩盖服务故障。生产系统应记录并区分“无相似度”和“计算失败”。浮点舍入也可能让结果极轻微超出理论区间。[源 §7.2.2 Step 3。]
OpenAIEmbedding.__init__ 创建兼容客户端并读取环境变量;get_embedding 把换行替为空格,向指定模型请求一个向量,非 API 路径未实现。这里要区分客户端接口与实际服务商:类名 OpenAIEmbedding 说明使用了兼容客户端,不能据此认定服务商是 OpenAI;源 .env_example 指向另一服务的兼容端点。源注释中“免费”是当时说明,本书不把它作为当前价格承诺。传入文档会把内容发送给端点,接入真实资料前必须核对授权和隐私。
11.4 VectorStore 是线性扫描,不是已经优化的向量数据库
VectorStore.__init__ 保存文档列表,默认参数为可变列表,应改成 None 后创建新列表。get_vector 对每个文档调用 embedding 并保存 self.vectors;persist 写文档和 vectors 两份 JSON;load_vector 读回。
持久化时还要注意,文档文件名固定拼成 doecment.json,拼写不规范但保存与加载一致,修改一端必须同步另一端。未先调用 get_vector 就 persist 会缺少属性;两份文件分别写入也可能在中途中断后不一致。[源 VectorBase.py,§7.2.2 Step 4。]
get_similarity 转调余弦;query 向量化问题,对全部向量逐个评分,argsort 后取倒序 top-k。文档数 N、维度 d 时,评分约
取结果的边界也会影响行为。源码 [-k:] 在 k=0 时等于 [0:],会返回全部文档而不是空集,应主动要求 k 为正整数。空库、维度错、文档/向量数量不等、相似度全零和并列排序都需要明确行为。
更新资料或模型时,索引中还应记录 embedding 模型与版本。新模型即使输出同样维度,坐标语义也可能不同,把旧文档向量与新问题向量比较没有保证。持久化后的最小验收是重新加载并对固定查询获得相同候选和分数,不只是检查 JSON 能解析。
11.5 生成接口要保护来源边界
BaseModel 保存模型名,chat/load_model 是未实现的占位方法。OpenAIChat.chat 创建客户端、读取环境变量,把问题与上下文填进 RAG_PROMPT_TEMPLATE,追加到传入 history,再调用服务并返回文本。这会修改调用者传入的 history,但回答并未自动加入其中。多轮使用时,需要明确由谁维护完整消息,避免只保存提问而漏掉回答。异常、重试、长度预算与超时也还没有完整处理。[源 LLM.py,§7.2.2 Step 5。]
模板要求“不知道就说不知道”,可以表达回答规则,但不能保证事实正确或系统安全。资料里的“忽略前面的要求”应被当作待分析文档内容,不能获得工具执行权限。回答中的每个关键事实最好能追溯到 chunk ID;资料冲突时要报告冲突,不能随意合并成一个确定答案。
评测时也要分开两部分:检索模块测 recall@k,生成模块测忠实度和引用正确性。这样才能判断错误发生在找证据,还是使用证据的阶段。
demo.py 读取 ./data、生成向量、持久化、检索 top-1 并取 [0],最后调用聊天模型。检索结果为空时,会在 [0] 处失败;而且每次运行都会重新索引,并未实现自动增量更新。.env_example 仅为配置样例,不能放真实密钥到书稿或日志;requirements 的精确版本记录原环境,不保证未来所有包仍兼容。本书不执行 demo 的联网路径。
11.6 离线替身只验证协议,不验证语义模型
examples/core/offline_rag_agent.py 中 mock_embedding 仅统计“检索、生成、工具、许可”四个词的出现次数,明确不是神经 embedding。
OfflineStore 保存带 ID/来源的三条手工文档,query 验证 k、按余弦排序且对零匹配返回空,save/load 在一个 JSON 中保存版本并检查重建向量一致。mock_answer 直接复制首条证据或返回不知道,不是真实 LLM。
原稿记录,运行 python examples/core/offline_rag_agent.py 后,“检索和生成”命中 d1;无关键词的问题返回不知道;零向量、k=0 和持久化往返都被检查。日志在 qa/core/rag_agent.json。本次没有重新执行或复核该日志。原有记录的验证范围是这组 fixture 下的索引、排序和接口连接,不能外推为同义词召回、中文语义检索或真实生成质量。
补充练习。 文档包含“退款需在七天内申请”,chunk 恰好只保留“退款可申请”。检索分数很高时,回答是否可信?换了 embedding 模型但维度没变,可否复用旧向量?
答案。 不能,关键时间条件已经在切块阶段丢失。维度相同也不代表坐标空间相同,除非有兼容性证据,否则重建索引并重测。
11.7 来源与署名
本章改编 Datawhale Happy-LLM 第七章 RAG,源码文件署名“不要葱姜蒜”,予以保留;独立新增离线替身、失败测试与解释,采用 CC BY-NC-SA 4.0。固定 RAG 源码。原研究:Retrieval-Augmented Generation。上游引用的第三方流程图未复用,本书图均自绘。