主题
第15章 Search-R1:把搜索结果放回可训练的轨迹
模型搜索一次、读到一段证据,再继续回答,这几步怎样变成训练数据?本章沿着一条搜索轨迹,检查动作、观察和奖励怎样对应起来,再看预算与评测如何约束这条流程。
以下讨论固定版本的实现。本次只做文字审读,没有调用搜索后端、训练模型或重跑实验。
15.1 一次搜索为什么不是普通文本续写
问“《小王子》的作者出生在哪个国家”,模型可以直接作答,也可以先搜作者,再搜出生地。强化学习在这里学习的是:何时需要证据、怎样写查询、看到结果后是否继续搜索以及何时结束。一次完整轨迹中,模型动作与外部观察交替出现。搜索结果会影响下一次决策,却不是模型自己生成的动作。因此,训练时必须区分:哪些 token 是模型做出的选择,哪些只是它读到的证据。
上游借用 Search-R1 的研究方向,具体脚本使用 PyTRIO 与可切换搜索后端;它不是原论文所有训练组件的逐行复刻。Search-R1 原论文给出搜索交织推理的研究背景;以下实现细节以固定源码为准。
15.2 协议先决定合法动作,再决定奖励
先看一次输出会被如何解释。protocol.py 提供 search 工具 schema、system prompt、ParsedAssistant,以及模板渲染和解析。在工具调用分支中,parse_assistant 要求一次 assistant 输出只包含一个结构完整的工具调用,调用后不能再跟最终答案;query 必须非空,且不能含尖括号,调用前的规划文本则可以保留。
没有工具标记的文本会被标记为 answer。这只是把它送入答案分支,还不代表它符合最终答案格式。
reward.py 的 extract_answer 找恰好一个非空 Answer: 行。注意实现使用 MULTILINE 正则,额外的非 Answer 行并不必然导致拒绝;提示中“只输出一行”的要求比解析器实际执行的条件更严格。这类差异需要在测试中明确呈现,不能只照着提示词描述解析器行为。
格式检查之后,score_answer 对格式无效给−0.1,格式有效但未命中给0,命中任一参考答案给1。normalize_answer 转小写、去 Unicode 标点、英文冠词及多余空白,这种英文问答口径不能直接搬到区分大小写的标识符或需要标点的化学/数学表达式上。
以两条轨迹奖励 [1,0] 为例,组均值0.5,优势 [0.5,−0.5];若 [0,−0.1],优势 [0.05,−0.05]。两组优势的幅度不同,是因为格式惩罚较小;正确性差异与单纯格式优劣带来的更新信号,尺度也就不同。
分组本身同样重要。assign_group_advantages 按 question_index 分组,绝不能把不同题混成一组,否则任务难度差异会被误当作同题动作优劣。
15.3 保存 token,比重新渲染一份漂亮对话更重要
读这套代码时,需要同时追踪两种表示。messages 用于协议、日志和人工复查,训练则使用当时真正采样到的 token。
两者不能随意互换:token 解码成文本后再编码,不保证得到原来的序列;聊天模板还可能去掉空白、补特殊标记,或重排 reasoning/content。重新渲染出的对话即使看起来更整齐,也可能已经不是采样时的那条轨迹。
build_next_prompt 先取得模板规范的 assistant 结束片段和 tool observation 增量,再接到 previous_prompt_tokens+completion_tokens 后面。_suffix_prefix_overlap 找采样尾部与结束片段前缀的最长重叠,防止重复添加已返回的结束符。如果模板在加入工具消息时改写了历史前缀,函数就直接报错。
在这些拼接之前,_render_chat 把字典、张量或嵌套列表返回统一成一维整数列表;这些 shape 处理看似琐碎,却是后续长度断言成立的前提。
例如第一轮 prompt [1,2]、回答 [3,4]、工具观察与下一轮前缀 [8,9]、最终回答 [5],完整 token 为 [1,2,3,4,8,9,5]。策略标记为 [0,0,A,A,0,0,A]。右移后 target=[2,3,4,8,9,5],advantage=[0,A,A,0,0,A]。观察仍留在上下文中,target 也保留真实值,只是优势为 0,不参与策略损失。如果直接删掉观察,最后答案在训练时看到的历史,就与 rollout 时不同了。
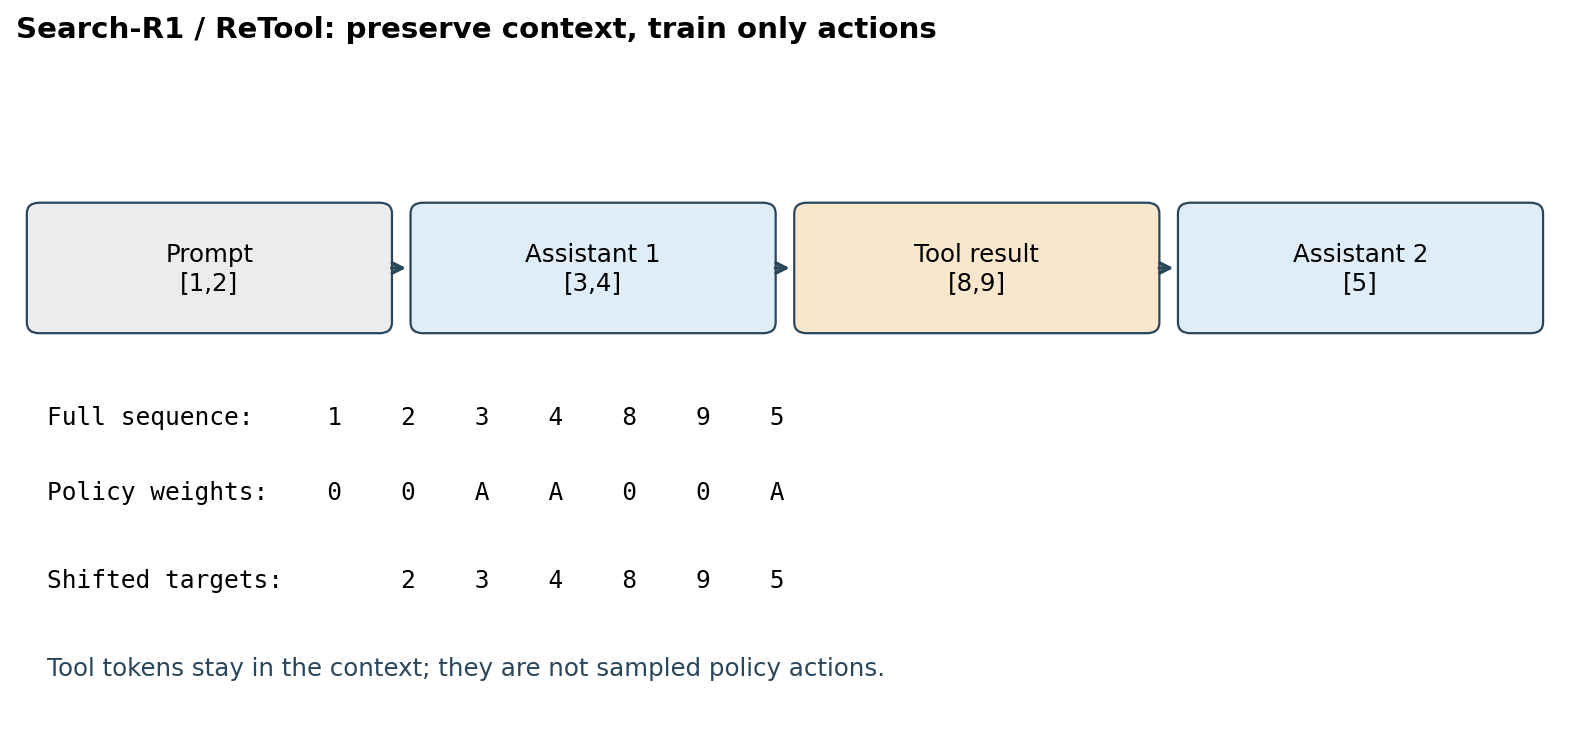
蓝色是模型动作,橙色是外部观察。观察进入上下文,策略权重仍为零。
15.4 多轮状态机怎样终止
要推进多轮轨迹,先得保存状态和预算。RolloutConfig 记录每轮 assistant、总轨迹、工具返回、轮数与调用次数的预算;Trajectory 保存问题索引、组索引、messages、turns、final_text、奖励和 done。
每轮的真实 prompt、completion 和旧 logprob 由 AssistantTurn 保存。SampleRequest 打包同 prompt 的采样请求,PendingSearch 则记录尚未完成的工具动作,以及它属于哪条轨迹。
make_request 按当前真实 prompt 长度计算 max_tokens=min(单轮上限,总上限-已有长度)。剩余
resolve_searches 用受限线程池执行后端搜索,并按原请求顺序关联结果,避免完成顺序串题。随后,finish_search 经 fit_tool_content 写回工具结果与下一 prompt。
搜索结果按完整条目添加,超过工具 token 或总轨迹预算就停止;若第一条就放不下,可能一条也不接纳,轨迹结束。保持来源条目完整有利于解释,但会损失部分可截断证据,这是与 ReTool 保留输出尾部的不同取舍。
rollout_batch 驱动活动轨迹一轮轮推进,完成后 score_trajectory 写入格式与精确匹配结果,再按题分组生成优势。回调只报告完成数,不能改变奖励。为避免工具挂起拖住整个 batch,超时、有限重试、并发上限必须在后端一起生效。
15.5 搜索后端是实验环境,不是可随便替换的细节
search.py 的 SearchItem 统一标题、证据、来源与链接,SearchResult 统一成功/失败返回;SearchStats 记录请求数、延迟和错误等统计。create_search_client 选择 Wikipedia、DeepSeek Evidence 或 Zhihu 后端,resolve_search_concurrency/timeout 给出后端默认值。因此,同一个训练 checkpoint 换了搜索后端,测到的就是另一套环境下的结果。
WikipediaSearchClient 通过 Wikimedia Action API 取得页面片段,_wait_for_rate_slot 序列化启动时刻,_request 完成查询;网络错误由 _error_result 转成轨迹中可见的工具返回。
DeepSeekSearchClient 从环境或已有登录配置读取凭证,search 对超时、429、5xx 作有限重试,parse_evidence 解析编号证据,format_item 保留出处。
ZhihuSearchClient 清洗多凭证、轮转选择,遇到 429 时,将该凭证标为本次运行不可再用。这里仅解释源实现,不是本书在授权外轮换账号绕过限流的建议。生产服务应遵守额度与条款,限流时优先退避或停止。
无论使用哪个后端,_error_result 都不应暴露密钥,第三方响应正文和日志也需要检查。搜索文本可能包含恶意提示、过期内容或互相矛盾的证据。把文本放进 tool 消息,可以标明来源,却不能自动保证模型忽略其中的恶意指令。本书离线例用固定返回值验证状态、预算与 mask,不发真实搜索。
15.6 训练装箱:为什么按最长长度算
轨迹完成后,build_datum 按轮整理训练数据。它要求下一轮 prompt 是已有完整 token 的前缀扩展,把新增观察的优势置零,再给 assistant token 赋同一轨迹优势。build_training_datums 跳过零优势轨迹,以及没有 assistant token 的轨迹。
装入微批时,这个提交还设了保护值:单条上下文上限 8192,微批最多 32 条,padding 后矩形面积最多 64000 token。这些数值属于该实现的配置,不能当作与硬件无关的推荐。
为什么用矩形面积?若一批长度为 [1000,100,100],padding 后需要
设第
这一步加权成立的前提,是服务端按样本取均值。如果服务端按 token 取均值,就要改用有效 token 数对应的权重,不能直接照搬。
日志也需要遵守同一口径。merge_trainer_metrics 对预加权的均值损失求和,pick_mean_loss_metric 则避免把总 loss 当作均值。rollout_metrics、source_reward、degenerate_group_count 分别记录生成情况、来源差异和零信号组。
serializable_config 负责路径序列化,save_checkpoint 同时保存训练 state 与推理 sampler 权重。main 将这些环节与 rollout、装箱、前后向和优化串起来,形成完整训练流程。
15.7 固定评测集仍需固定工具
prepare_data 从指定 parquet 清理答案,extract_answers 兼容不同参考字段,normalize_row 统一问题/答案/来源,prepare_split 输出本地 JSONL;select_dev 按来源固定抽取开发题,write_jsonl 与 print_counts 分别保证落盘与可见来源分布。
准备好本地文件后,data.py 的 load_examples 验证其结构,shuffled_examples 固定种子打乱,take_batch 循环取批。重复问题应在划分前去重,不能只看行号不同。
eval.py 的 chunks 控制并发批大小,trajectory_record 保存复查轨迹,evaluation_metrics 按来源算 EM,再对来源均值求宏平均,summary_record 将配置与汇总写到 JSONL 末行。假设来源A有90题对81题,来源B有10题对1题,
analyse.py 的 load_summary 从末尾取汇总,load_metrics 整理比较,configure_style/add_value_labels/make_figure 绘制结果;make_deepseek_figure 特意在同一 DeepSeek 环境比较 Base 与 Step20。图能正确画出文件中的数值,不代表实验条件就可比较。输入 JSONL 对应的后端、预算、样本和采样参数,仍要逐项核对。本书没有重跑这些模型对比,不能把上游图里的改进写成此次实测。
15.8 练习与答案
补充练习:若工具观察有100 token,而模型动作只有10 token,把全部110 token一起做策略损失会怎样?答案:观察来自外部搜索,没有对应学生采样概率;训练会把第三方文本当模型行为,并且在数量上支配损失。正确处理是保留上下文、屏蔽观察的策略梯度。
补充练习:同一问题只找到无关证据,但最终答案恰巧正确,奖励是否能够识别?答案:当前终局 EM 不能。可以额外做证据支持与搜索效用评估;若要把它们纳入训练奖励,需要独立设计和验证,避免奖励器本身引入可钻漏洞。
来源与改编说明
本章依据 Datawhale Happy-LLM 固定提交的docs/chapter8/search-r1/README.md,以原创叙述、推导和离线反例扩写。第八章实现原署名及 agentic-rl-lab 来源见上游 README;Extra-Chapter 作者归属保留在全书授权页。本章与配套改编采用 CC BY-NC-SA 4.0,仅非商业使用,不代表原作者认可。文中的本地结果只证明指定离线检查通过,不代表复现上游模型效果。