主题
第 19 章 拼接式视觉语言模型:图像真的进入语言模型了吗
19.1 一条下降的 loss 曲线可能掩盖整条断路
一个模型能流畅回答“图里有什么动物”,不代表它看过图。它可能只根据问题猜一个常见动物;甚至在训练 loss 很低时,图像分支仍然没有接通。Happy-LLM 的 拼接微调补充教程 记录了这样一次错误:外层模型的 image token ID 已修改,内层模型仍使用旧 ID,导致语言模型没有收到预期图像特征。
这个错误提出了一个具体问题:怎样确认图像特征确实进入了语言模型?本章沿着视觉编码器、连接器和语言模型之间的数据流,检查接口是否接通,再区分接口正确与模型具备视觉能力各自需要的证据。
来源作者为情感机器实验室陈少宏;上游感谢 zhihuazhao-bit 和 KMnO4-zx 的代码与文章审阅。本章在原文基础上补充原创推导,并引用配套 CPU 小张量检查记录。上游作者的经历与这些离线检查分开叙述。
教程将 SmolVLM2 的视觉模块与 Qwen3-0.6B 拼接,希望利用已有视觉特征和中文语言能力,只训练较小连接器。固定提交的范围是系列第一篇;模型系统评测、数据优化和更多结构实验属于计划内容,不能写成已经完成。
19.2 拼接的是表示,不能只换一个模型名字
设一张图经视觉编码器后有
接下来,在文本序列预留
上游用 SigLIP 风格视觉骨干和 Qwen3 的文本模型。这里沿用它报告的特征宽度:视觉 768,原文本 576,新文本 1024。这种架构可复用语言模型的 causal self-attention,并不需要额外的 decoder cross-attention。原文将此特点与“早期 LLaVA”作对照时不够严谨,不能据此把所有早期 VLM 都归为交叉注意力路线。这里讨论的是当前拼接接口的工作方式。
理解视觉序列的长度时,要分清图像切分和 patch 压缩。image splitting 生成全局视图与局部高清裁块,让细节更容易保留,通常增加视觉序列量。
连接器之前的空间重排把邻近 patch 的特征并到通道,降低 token 数。如果每边按因子
源代码片段配置 scale_factor=4。按上述重排规则,单线性投影真正面对的是
固定范围 README 未包含 SmolVLMConnector 的实现,因此实际权重 shape、是否带 bias、重排顺序仍应在所装版本中打印核验,不能仅凭示意图宣布已完成模型级复现。
上游报告约 12M 可训练参数,与通道扩展后的量级相符,但它的总参数口径和权重共享细节没有在本章重新加载核对。
参数量小也不意味着训练显存很小:语言模型仍要对整条视觉加文本序列做前向,并保留将梯度传回连接器所需的计算信息。
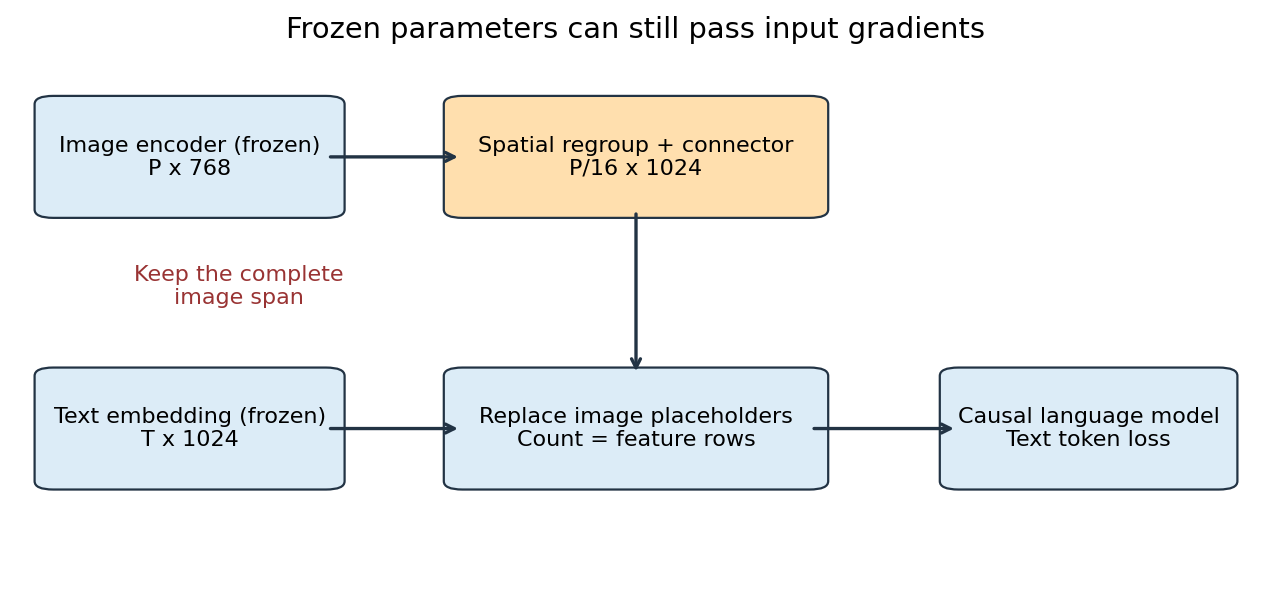
图 19-1 自绘接口图。以每边合并 4 个 patch 的重排为例,视觉序列缩短 16 倍;图像占位数量须与特征行数一致。
19.3 Tokenizer、模板和嵌入替换必须使用同一套 ID
第一处改动是让 Qwen tokenizer 识别图像占位符。上游用已有 <|image_pad|> 替代 SmolVLM2 的 <image>,避免后者被分成普通词片。不要仅检查字符串“看起来相同”:应打印单独编码的 ID,确认恰好一个 token,再对照 processor、外层模型、内层模型和 config 的 image_token_id。
SmolVLM2 的格式还包括局部块行列标记与全局图提示,它们负责描述多个视图在序列中的排列。Qwen3 的角色开始、结束、思考段和工具调用边界则承载语言模型已学到的上下文习惯。迁移模板时,需要保留视图排列和角色边界各自的约定,逐项核对特殊字符串的作用。
原文展示的示意模板两端重复出现 <vision_start>,不能仅据排版假定它就是实际完整模板;最终应检查外部项目里的 chat_template.jinja 和 tokenizer 配置。这个外部文件不在本书固定 Happy-LLM 范围内,不能把这里的模板讨论当作对该文件的逐行核验。
训练样本已有 assistant 答案,使用 add_generation_prompt=False;推理只提供用户问题,才追加生成前缀。关闭 thinking 模式也要在训练、推理一致实施。单纯保留工具调用 token 不保证工具调用能力完全保留,它只是减少一种模板不匹配。
最重要的数量约束是:每个样本展开后的图像占位 token 数,等于该样本实际提供给语言模型的视觉特征行数。只检查“有一个 image 标记”不够,因为 processor 常把一个图像标记展开为很多位置。设样本中 mask 为
配套最小例的检查记录显示,两个占位位置对应两个特征时,数量检查通过;截掉其中一个占位符后,检查失败。真实系统还需要按样本和视图核验顺序,整个 batch 的总数相等不能排除样本之间错配。
19.4 替换 backbone、输出头和配置,是同一个手术
第二处改动先加载视觉语言模型与 Qwen3 因果语言模型,把 smolvlm2.model.text_model 指向 qwen3.model,把 smolvlm2.lm_head 指向 qwen3.lm_head。Qwen3 backbone 输出
原文还解释了任务头的区别:因果语言建模逐位置预测词,序列分类产生整条输入的类别分数,token 分类为每个位置分类,抽取式问答预测参考文本中的答案位置。分类头具体取哪个位置、怎样处理 padding,要按任务模型实现核对;不能因为同属 Qwen3 就把它们当成可互换输出。
配置片段把多处 vocab_size 改为 Qwen 的 151936,把图像 ID 写为 151655,生成停止 ID 写为 151645。它们是上游特定模型配置的记录,不应硬编码到不同版本。应从 tokenizer 或模型配置解析,再验证 ID 未越界、对应 token 正确。
源片段里 model.config.vocab_siz 少了字母 e,赋值可能创建一个无效新属性而不报错;这是“Python 能执行”与“模型会使用”之间的典型差异。
保存后重新加载,才算检查了一次完整改动。需要确认模型类、嵌套 text config、tokenizer、processor、模板和 generation config 都能恢复;仅在内存里替换对象未必让 save_pretrained 自动知道重建自定义架构的方法。
README 提供的是带省略号的关键代码片段,不能直接作为自包含程序运行。这里的分析覆盖这些片段,不代表对外部完整工程的运行验证。
第三处改动用 VisionConfig、TextConfig、ConnectConfig 提供宽度与重排因子,构造新 SmolVLMConnector 后移到指定设备,并转换为 bf16。
现代 Python dataclass 中,嵌套可变配置实例常应使用 field(default_factory=VisionConfig) 等工厂,而不是把一个实例直接写作默认值;这样既避免共享状态,也避免版本相关的可变默认值错误。原文示例需结合 Python 版本修正后使用。
19.5 冻结参数,不是切断梯度
上游 freeze_model 遍历 text_model.named_parameters() 与 vision_model.named_parameters(),将 requires_grad=False,返回模型。它没有显式遍历 lm_head,因此文字所说的“仅 connector”与“connector 加语言模型头”不能只凭这段函数判定。
当 lm_head 与输入 embedding 共享同一 Parameter 时,冻结 embedding 可能同时冻结 head;未共享时则可能留下很大的可训练头。应打印每个可训练参数的完整名称、shape 与数量,并按模块汇总,不能只看总比例。
视觉与文本主干冻结后,连接器仍需梯度。设冻结语言模型为
冻结 no_grad() 内,会把这条路径切掉。视觉编码器在不需要更新且输出仅作为连接器输入时,可以另行讨论不记录其梯度,但不能把这个策略直接套到连接器之后的语言模型。
配套 CPU 检查使用一个 3→4 的可训练线性连接器和一个 4→5 的冻结输出层。记录显示,交叉熵反向传播后,连接器梯度范数为 1.8544523573,冻结层参数梯度为 None。对一个连接器权重作中心有限差分,误差约
上游的失败实验说明了为什么需要这些检查:允许语言侧更新时,没有视觉输入也能靠语言共现降低 loss;冻结语言侧后才暴露出视觉分支几乎没有有效梯度。
调试时应同时检查三个条件:连接器梯度是否非零、换图是否改变视觉嵌入、固定问题换图是否影响答案分布。单看梯度非零仍不足够,梯度可能来自错误接线;单看回答不同也不足够,随机采样本来就会变。
19.6 数据整理函数做了哪些取舍
接口接通之后,还要检查数据整理是否保留了原任务。上游使用 The Cauldron,报告它汇集多种视觉任务,并提到若干子集加载异常。数据规模、下载体积及加载状态均来自原文记录。mimic_cgd、localized_narratives、okvqa、ocrvqa、clevr_math 的问题应在复现记录中列成缺失数据,而不能悄悄忽略后仍说数据完全一致。
data_collate_fix2k 对每条样本取 images[:1],再取 texts[0],构造一个 user 和 assistant 对话。因此它丢弃后续图像和后续问答。对于需要对比两张图的问题,丢掉一张图就改变了判断答案所需的信息;正确策略是筛除多图依赖样本,或保留完整多图接口,而不是默认第一张已足够。
processor 接收格式化文本与图像列表,将序列截断或填充到固定的 2048 长度,输出模型需要的张量。随后复制 input_ids 得到 labels,再将 pad 和 image ID 对应的标签设为 -100。
这属于“全部文本监督”,用户问题与模板中未屏蔽 token 也参与损失;它不是仅 assistant 回答监督。若要只监督回答,应依据模板产生的 assistant 区域 mask 或经过核验的 token 边界生成标签,不能用字符串长度代替 token 长度。
设第
函数最后 batch.to(device,dtype=torch.bfloat16) 是否只转换浮点值,依赖 processor 返回容器的具体实现。不能假设普通字典或任意容器都有相同规则。务必断言 input_ids 与 labels 仍为整数,pixel values 等浮点输入才转换到支持的 dtype。
按 token 值屏蔽 pad 时,若 pad 与 EOS 共享 ID,可能把真实结束符一起屏蔽;以 attention mask 标识真正 padding 更明确。
截断还可能破坏图像占位数量约束。上游报告视觉 token 常占约 0.8K—1.3K,文本常为数百 token,因此使用 2K 上限。这是那批数据的经验,不能保证所有新图像都安全。更可靠的做法是先计算视图展开数量,预留完整视觉区和最小回答预算,超长样本再缩图、减少视图或丢弃。若回答被全部截掉,剩下的标签又全为 -100,即便张量形状合法,也没有可用于监督的目标。
packing 可以提高利用率,但多图归属、跨样本 attention、位置 ID 和标签边界都必须重做,不能直接用文本 packing 代替。
19.7 训练配置与断点恢复如何解释
上游配置每卡 1 样本、累积 4 步、8 卡,总有效 batch 通常为 32。训练 200 个优化步意味着约 6400 次样本呈现,不等于 6400 个互异样本。seed 和 data_seed 都设 42,remove_unused_columns=False 保留图像与自定义字段供 collator 使用;dataloader_pin_memory=False、gradient_checkpointing=False 是具体环境选择。
学习率
原文另有“超过 1000k step 固定 50”的文字,但这条规则不在展示配置中,不能当作该实验实际执行。
eval_steps=save_steps=0.125 在支持比例语义的 Trainer 版本中表示总步数的比例,而非每 0.125 步;200 步下约为每 25 步。应固定 transformers 版本并核对解析结果。
其余配置分别控制优化、日志和保存行为。optim="adamw_torch" 使用 AdamW,weight_decay=0.01 对适用参数施加权重衰减;logging_steps=5 控制记录频率,save_total_limit=8 限制保留检查点数量。output_dir 和 overwrite_output_dir=False 决定保存位置与覆盖保护,run_name 为日志实验命名,report_to="swanlab" 会请求外部日志集成。
断点逻辑先检查输出目录:若不允许覆盖,尝试 get_last_checkpoint;非空目录却无有效 checkpoint 时抛异常,避免误写已有内容。Trainer.train(resume_from_checkpoint=...) 恢复训练状态,最后 save_pretrained 保存模型。
要确认恢复后延续的是同一次训练,还需核对优化器、调度器、随机状态、数据顺序与模型配置相同;只载入权重不是同一条训练轨迹。
训练环境记录涉及 8 张 MetaX C500 64GB GPU,以及单卡或 accelerate 多进程命令、SwanLab 登录和资源下载脚本。这些属于上游运行环境的记录。
原文环境列表的 torch >=6.0 与 PyTorch 版本语境不一致,应视为待核实文字,不能按此安装;模型环境应记录实际可用版本,而不是照抄疑似笔误。
精度格式的解释也要区分清楚。原文说 bf16 比 fp16“增加尾数位”,但实际是:bf16 有 8 位指数、7 位显式尾数,fp16 有 5 位指数、10 位显式尾数。bf16 的主要优势是指数范围大,不是小数精度更高。
“batch 越大越好”和“学习率衰减必备”都不是无条件规律。大 batch 改变优化噪声与更新次数,训练步数和学习率要配套;当前实验采用这些配置,不构成其他任务的最优性证明。
19.8 怎样读成功、失败和还没完成的结果
作者先用 cocoqa 做 200 步验证,原文报告训练与测试 loss 约 0.65,三只狗图片却被回答成兔子;增加数据和步数后,同一图能回答狗。更大数据实验报告训练 loss 约 0.61、评估约 0.58,测试集只有 64 条。这些是上游观察,不能作为本书已复现训练、吞吐、时长或模型输出的证据。
“能回答一种动物,所以训练没失败”不足以成立,语言先验同样会输出动物词。单图从错误到正确提示改进,却不能代表通用视觉问答能力。
再看 loss:训练 loss 与评估 loss 不必因数据量大而相等。dropout、样本难度、监督 token 构成、数据分布和统计波动都可能造成差距。学习率降得很低时 loss 进入平台,可能只是步长太小,不能独自证明充分训练。
约 60K 样本、每条 pad 到 2K,最多是约 120M 个处理位置。有效训练 token 数应减掉 padding 和不监督图像位置;若只监督回答,还要减去提示。因此把 12M 可训练参数与 120M 位置的 1:10 比值视为“足够收敛”的定律不成立,完整预训练的缩放经验也不能直接套到冻结主干的视觉对齐。
同理,冻结语言权重和保留模板,并不能证明“全部原有能力完全保留”。图像占位、生成配置、processor 路由、共享输出头是否更新,均可能改变实际行为。
检查语言能力的保持程度,应比较拼接前后的纯文本任务。检查视觉依赖,则应在固定问题下做正确图、错配图、空白图三组对照,并固定解码设置。再按物体识别、计数、OCR、空间关系、中文提问和长回答分别报告结果,才能知道哪一部分真的改善。
上游的硬件利用率截图只能描述那次运行,不说明瓶颈一定在哪里。图像解码、CPU 预处理、数据加载、通信和小 batch 都可能影响利用率,定位应使用实际 profiler。模型推理与效果分析 一节在固定提交中仍写着未来补充,因此尚不能据此讨论完整的模型评测结果。
19.9 本章检查、练习与来源
配套 examples/17_19_contract_checks.py 的检查记录对应 Python 3.12.14、PyTorch 2.6.0+cpu、float64、seed 42、单线程。记录中的结果包括连接器梯度与有限差分一致、12,582,912 的投影参数算术,以及图像占位截断后数量不匹配。
示例标签 [9,7,7,8,4,0] 在图像 ID=7、pad ID=0 时变为 [9,-100,-100,8,4,-100],直接看得出用户侧普通文本仍被监督。这些离线检查不需要下载模型、图片数据集或启动远端日志。
本书补充练习:
- 两张图分别提供 20 和 30 个视觉特征,文本模板共有 50 个图像位置,就足以确认 batch 没接错吗?
- 视觉宽度 768、空间重排因子 2、语言宽度 1024,单投影无 bias 参数有多少?
- 为什么冻结语言模型后不能把它的前向整体放进
no_grad()? - 测试 loss 低于训练 loss,能立即说“没有过拟合”吗?
答案:
第一题不能,还要按样本、视图和位置核对各自 20/30 的归属及排列。
第二题
第三题连接器必须通过语言模型对输入的导数收到梯度,冻结参数与停止计算图是两回事。
第四题不能,需检查评估集来源、规模、dropout、标签掩码和真实任务指标。
本章来源为陈少宏撰写的 Datawhale Happy-LLM VLM README 与资产目录,固定提交 1e0b3a1e6f8936b8ba4bbd0673e8e2227d196c96。目录中的架构图、日志截图和示例图片用于说明上游接口和运行记录;正文只解释这些材料能支持的结论,不复制第三方照片或宣传图。外部 Qwen3-SmVL 工程 和 SmolVLM2 技术报告 是原文提供的继续阅读入口,不属于本章已经逐文件审计或运行的范围。本章原创改编、纠错和离线验证依 CC BY-NC-SA 4.0 提供,不声称官方认可。