主题
第 01 章 先画清语言模型的任务与边界
给程序输入“今天的天空很”,它给“蓝”的分数高于“桌子”。要理解这次预测,我们还得弄清文本怎样变成数字、模型怎样算出分数,以及训练数据怎样影响这些分数。要把预测接成一个可用的对话产品,还需要决定怎样选择续写、什么时候停止。本书沿着这条计算过程构造模型,再把模型接到分类、指令和交互任务中。
本书依据 rasbt/LLMs-from-scratch 的公开源码撰写,固定提交为 cdbd33e6d57a71e20ea31434841095fac50cecd8。上游 ch01 明确没有主章节代码,只提供阅读建议和两个视频入口。因此,本章的概率展开、示意图和练习是为本书新写的教学内容,并非出版书第 1 章的翻译,也不声称逐秒核对了视频。来源:固定版本 ch01/README
1.1 一次预测到底输入、输出什么
设词表大小为
模型用参数
把
用一个只有四个 token 的教学词表来看这一步:词表依次为“天”“蓝”“雨”“结束”,分数为
“蓝”的分数最高,但采样仍可能选中其他项。模型给出了分布,程序还要决定如何从分布中选择。第 14 章会单独讨论这一步。
1.2 从局部预测到整段文本
概率的链式法则把联合概率展开为:
乘许多小概率容易数值下溢。取负对数后,乘积变为求和:
这个目标鼓励模型给语料里实际出现的续写更高概率。语料中的规律会影响模型,缺陷也会:频繁出现的错误陈述同样可能得到高概率。因此,这个目标不直接测量陈述是否真实、建议是否安全,或回答是否符合某个人的意图。训练损失很低,也可能只是模型记住了一段短文本。实现落点:上游 calc_loss_batch 与训练循环
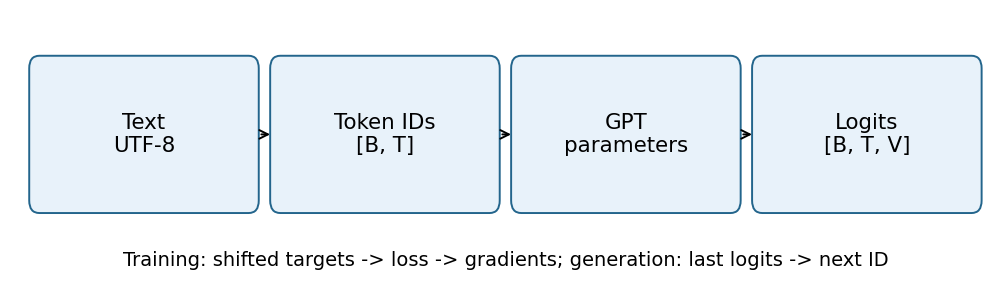
1.3 预训练、微调与使用阶段改变了什么
预训练主要改变参数,使模型学会语料中的续写关系。文本分类通常保留大部分计算骨架,把输出改成少量类别。指令微调仍可使用下一个 token 目标,但训练样本按照“指令、输入、回答”的约定排布;哪些位置计入损失会改变优化重点。偏好训练则比较回答之间的相对偏好,目标函数与普通续写训练不完全相同。
到了使用阶段,还可以通过检索增强把外部材料加入上下文,这不一定需要更新参数。工具调用则多了一层外部程序:程序要验证模型提出的操作、执行工具,并把结果传回来。模型仅仅产生字符串,并不会自动获得读文件、发邮件或运行代码的能力。
这些区别决定了问题该在哪里修。知识过期时可以考虑检索;标签定义含糊时需要改数据;出现越权执行时需要检查程序的权限边界。扩大模型并不能代替这些工作。
本书会建立下表中的机制,但不会把小实验的成功推广为大规模系统的效果。
| 阶段 | 直接输入 | 训练或执行时改变的对象 | 本书能验证的范围 |
|---|---|---|---|
| 预训练 | token 序列 | 模型参数 | 小模型前后向、损失、保存恢复 |
| 分类微调 | 文本及类别 | 输出头和选定参数 | 标签、冻结、梯度路径 |
| 指令微调 | 格式化指令与回答 | 选定模型参数 | 模板、padding、loss mask |
| 生成 | 提示词与采样设置 | token 序列、可选缓存 | 形状、概率、停止和缓存一致性 |
| 外部工具 | 模型输出与权限规则 | 外部系统状态 | 解释接口,不执行不可信生成代码 |
1.4 “从零”应该让哪些部分可检查
本书的“从零”,是把需要理解和检查的计算写出来。我们仍使用 PyTorch 的张量运算和自动微分,自己实现模型层、数据配对、损失、训练循环和生成逻辑。这样,遇到错误时就能逐步定位:标签是否移错了一位,softmax 是否归一化了错误的维度,缓存位置是否从零重算,验证数据是否与训练窗口重叠。
配套的 examples/core_training/core.py 使用 16 维隐藏状态、2 层、4 个注意力头和 16 个 token 的小词表。这个模型随机初始化,可在 CPU 上运行,不使用 GPT-2 的预训练权重,共有 7,264 个可训练参数。第 6 章将推导这个数,实验会把它与上游同结构的缩小配置逐项对齐。
配套实验记录的环境是 Python 3.12.14、PyTorch 2.6.0+cpu,随机种子固定为 2718,CPU 线程数为 1。固定种子有助于在相同条件下重跑;更换设备或库版本后,结果不保证逐位相同。跨 CPU、CUDA、MPS 的区别在第 18 章解释。所有实测输出放在配套 qa/core_training/results.json,没有下载模型权重,也没有运行在线评估。
1.5 按一条可验证的路线读
上游阅读建议强调依次阅读、运行代码、做练习,再带着问题尝试自己的项目。读本书时,可以据此做三个检查:先用一句话说清本节输出什么,再手算一个小例子,最后运行断言,并故意制造一次错误,看看检查能否发现它。只看到 loss 下降还不够,因为标签错位时损失也可能下降。来源:上游阅读建议
第 2 章补足 PyTorch 的最小训练闭环;第 3—6 章沿文本、注意力、Transformer 到 logits 逐步搭建;第 7—12 章处理成本、缓存及架构变化;第 13 章以后进入训练、加载和各种适配任务。读到后面的优化时,仍要用前面的定义检查计算是否正确。即使某个实现快了两倍,只要它悄悄看到了未来标签,就没有通过验收。
1.6 练习与检查
以下是本书补充题。
- 词表有 10 项,输入为 3 条、每条 7 个 token。输入、logits、生成时最后位置 logits 的形状分别是什么?
- 若训练文本中的某个回答出现频率很高,是否足以说明模型生成该回答时事实正确?写出一个反例。
- 为什么训练时能并行计算多个位置,而自回归生成仍要逐步进行?
提示:区分“已知完整训练序列”和“尚未选择出的未来 token”。
答案:形状依次是