主题
第 02 章 张量、自动微分与最小训练闭环
训练语言模型之前,先用一个小分类器走完训练、检查和保存的过程。例子里没有文本,但计算损失、求梯度和更新参数这些动作,后面还会反复用到。本章会沿着一个批次的计算追踪形状和梯度,说明数据、参数、计算图和设备各自负责什么。
上游对应 appendix-A 的两个主 notebook、两种 DDP 启动脚本及练习。本章逐步解释这些实现,并用四个自造样本做配套 CPU 实验。本书的实测结果与上游演示输出分开记录。固定版本 Appendix A
2.1 张量不仅有数值,还有形状、类型和存储
标量的形状是 [],向量是 [D],矩阵是 [B,D]。三维张量 [B,T,D] 在本书中通常表示批次、序列位置和特征维。每根轴代表什么,由程序约定,张量本身并不知道。若误把两个长度相同的轴交换,形状检查可能发现不了,模型的计算却已经变了。
整数 ID 通常用 torch.long,模型权重通常用浮点类型。整数不适合做需要连续梯度的参数。.to(torch.float32) 改变类型,.to(device) 改变存放设备;使用时要知道自己需要改变的是哪一项。
除了类型和设备,还要留意数据是否共享。torch.tensor(numpy_array) 复制数据,torch.from_numpy(numpy_array) 在支持的条件下共享底层内存。后者节省复制,但修改原数组也会改变张量,不能把它误当成快照。
矩阵 A * A 是逐元素乘法,A @ A.T 才是这里的矩阵乘法。
reshape 不等于转置。把 [2,3] 改成 [3,2] 只是按存储访问顺序重排形状;.T 则交换轴。张量转置后通常不连续,view 要求新形状与原有步幅兼容,reshape 必要时会复制。因此,注意力实现里常用 .transpose(...).contiguous().view(...):先交换轴,再取得连续存储,最后改变形状。
配套反例把 arange(6).reshape(2,3) 转置后调用 view(6),触发了错误;改用 reshape(6) 则返回 [0,3,1,4,2,5]。后者虽然成功改变了形状,却没有回到原始行顺序。
2.2 从一个 sigmoid 手算梯度
设输入
要知道权重怎样影响损失,可以沿着概率、logit 和权重之间的依赖逐步应用链式法则:
最后得到
与自动微分的绝对误差约为
上游先使用 sigmoid 再调用 binary_cross_entropy,让概率与损失的关系直观可见。实际实现可把两步合成 binary_cross_entropy_with_logits,避免显式计算接近 0 或 1 的概率后取对数。传给它的是
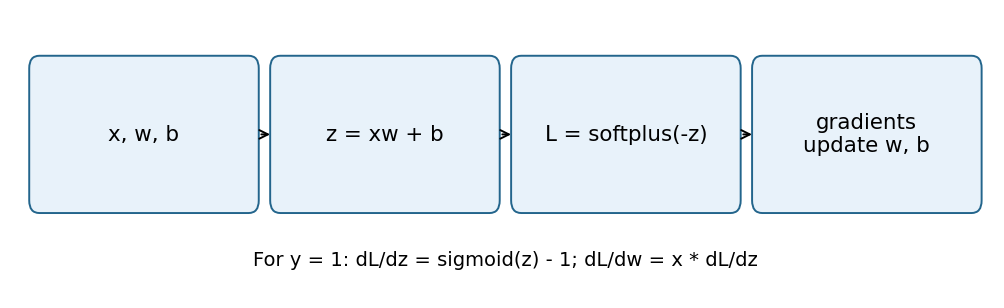
2.3 计算图不会替你决定何时清空梯度
requires_grad=True 让浮点张量参与梯度追踪。前向运算构建本次计算图,torch.autograd.grad(loss, parameters) 返回所请求的导数;loss.backward() 则把导数累加到叶子参数的 .grad。同一张图的中间结果通常在反向后释放。若还要计算一次反向,就需要事先保留图,或者重新做一次前向运算。
保留图和清空梯度,是两件需要分别控制的事。retain_graph=True 保留的是计算图,并不会“让训练记住历史”;optimizer.zero_grad() 清空的是梯度,不会清空模型权重。
由于反向传播会累加梯度,省略清零就会把多个批次的导数加起来。这可以是有意的梯度累积,也可能是忘记清零造成的错误。若确实要累积,还要统一损失的分母,不能无条件把不同大小的批次平均值相加。
推理时 torch.no_grad() 停止记录反向图,节省内存;model.eval() 切换 dropout、BatchNorm 等层的行为。所以,停止记录梯度不能代替切换到评估模式。小网络没有 dropout 时,漏掉模式切换可能暂时看不出差别;换成带 dropout 的 GPT,生成就可能受到随机丢弃的影响。
2.4 用 Module 组织三层网络
上游 NeuralNetwork 使用 Linear → ReLU → Linear → ReLU → Linear,隐藏宽度依次为 30、20。输入 [B,50]、输出 3 类时,权重形状分别为 [30,50]、[20,30]、[3,20],偏置分别为 [30]、[20]、[3]。PyTorch 的 Linear 保存的是 [out_features,in_features],前向相当于
参数数量要把偏置算进去:
上游练习 A.3 改成 2 维输入、2 类输出时,则为 sum(p.numel() for p in model.parameters()) 应得到相同数字。只有 requires_grad 的参数才应计入“可训练参数”,但被冻结的参数仍占存储。
super().__init__() 建立模块注册机制。这里把层放在 nn.Sequential 里注册,PyTorch 就能递归找到参数、切换模式、移动设备和保存状态。自行组装模型时也要保留这层注册关系:普通 Python 列表不会像 ModuleList 那样注册子模块,放进去的层可能因此漏掉参数更新或设备迁移。
网络最后输出的是 logits。多分类时,cross_entropy(logits, labels) 内部进行稳定的 log-softmax。求预测类别可以直接 argmax(logits, dim=1);softmax 保持大小顺序,因此先转概率再 argmax 只增加计算。
2.5 Dataset 和 DataLoader 分别负责什么
上游 ToyDataset.__len__ 返回样本数,__getitem__ 返回指定行的特征和标签;DataLoader 才决定如何打乱、分批、并行读取。五个样本、批大小 2,会形成 2、2、1 三个批次。drop_last=True 删除最后一批,统一大小,但每轮少看一个样本;验证集通常不应默默丢弃尾部。
shuffle=True 打乱的是样本访问顺序,并没有修改特征与标签的配对。数据很少时,num_workers=0 更容易排错;增加进程可能反而被启动和通信成本拖慢。GPU 数据加载可使用 pin_memory 改善特定传输路径,但在 CPU 小实验里不是速度保证。
准确率应累计正确样本数,再除以实际处理的总样本数。例如,两个批次分别有 2 个和 1 个样本,简单平均两批准确率,就会让第二批的单个样本获得过高权重。还要检查加载器是否为空,否则分母会变成零。训练前应确认数据量和 drop_last 的组合没有把所有批次都删掉。
2.6 每一步更新都要有明确先后
有了数据和模型,一次更新就可以连起来:先清空旧梯度,再前向计算损失,然后反向求导,最后更新参数。完整实现见 examples/core_training/run_checks.py 的分类器段,核心顺序如下:
python
optimizer.zero_grad(set_to_none=True)
logits = model(features)
loss = torch.nn.functional.cross_entropy(logits, labels)
loss.backward()
optimizer.step()
backward 计算当前权重下的梯度,step 按优化器规则更新参数。对于 SGD,
本书的小网络为 2→8→2,四个样本分成两个明显分离的类别,学习率 0.2,训练 40 步。实测交叉熵从 0.5594008565 降到 0.0106433481,四个训练样本全部分类正确。这些结果说明训练闭环在这四个样本上有效。由于样本太少、分类又太容易,它们不能证明模型在新数据上的泛化性能。上游使用五个训练样本、两个测试样本的演示,也应按同样标准理解。
2.7 保存的是哪些状态
state_dict() 保存参数和持久 buffer 的名字及张量。恢复时先建立相同结构,再 load_state_dict。恢复这些状态,可以恢复相同的前向计算;要接着原来的训练轨迹继续,还需要优化器状态、学习率阶段、已消费的数据位置和相关随机数状态。原因是下一次更新不仅取决于当前权重,还取决于优化器和数据读取等环节走到了哪里。第 15 章会详细展开。
上游使用 torch.load(..., weights_only=True) 加载权重。本书也只加载自己刚保存的临时检查点,并把张量映射到 CPU。这个选项限制了反序列化时可执行的内容,但陌生文件的来源仍需要核验。本书实测保存、恢复后 logits 最大差为 0。
2.8 从单设备到 DDP,代码多出来的责任
第二个 notebook 把模型、特征和标签移到同一个设备。两个待相加张量分别留在 CPU 和 CUDA 会报设备不一致;同一模型的参数和输入也必须相容。torch.cuda.is_available() 用于运行前检查 CUDA 是否可用。本书环境没有 CUDA 实测,运行了 CPU 分支并不能算作通过 GPU 测试。
两份 DDP 脚本的主体相同:初始化进程组,每张 GPU 一个进程,给每个进程设置设备,用 DistributedSampler 划分样本,把模型包装为 DistributedDataParallel,反向时同步梯度,结束后销毁进程组。
两份脚本主要在启动方式上不同。DDP-script.py 用 mp.spawn 启动;DDP-script-torchrun.py 从 WORLD_SIZE、LOCAL_RANK 或 RANK 读取启动器配置,并且不覆盖启动器已经设置的主地址和端口。单机时 rank 与 GPU 编号容易相同,多机时全局 rank 和本地 rank 不能混用。
sampler.set_epoch(epoch) 让每个 epoch 使用不同的、跨进程一致的打乱规则。DataLoader 此时不能再自己启用 shuffle。默认分布式采样可能为凑齐各进程样本数而补重复样本;再加上 drop_last,实际训练和评估的样本集合需要核对。上游示例的数据极少,因此对多于两张 GPU 的情况专门给出错误提示。增加 GPU 并不会增加样本,划分之后可能反而没有足够的有效批次。
同步梯度时,还要看每个进程处理了多少样本。若各进程批量相同,对各进程的平均梯度再求平均,就等于整体平均梯度。若样本数不同,
本书没有实际启动 DDP。这里解释了相关脚本的计算和职责,但没有验证这条硬件运行路径。
2.9 运行、练习与答案
在配套代码根目录运行:
bash
python examples/core_training/run_checks.py --output qa/core_training/results.json环境需安装匹配的 PyTorch;本书记录的版本和运行日志在配套 QA 中。该命令不下载数据。若已拥有固定上游源码,可以加 --upstream runtime_sources/upstream 运行第 6 章的对照。
上游 A.1、A.2 的环境题分别指向 Python 设置和依赖检查;本书第 30 章集中说明。A.3 参数计数答案已在 2.4 推导。A.4 比较 [100,200]@[200,300] 的 CPU/GPU 时间,正确测量应预热并同步 GPU,不能直接把异步提交时间当完成时间;本书未执行这项 GPU 比较。
补充题:将训练循环的清零移到循环外,解释为什么第二次梯度不再等于第二个批次的导数;再让 drop_last=True 的批大小大于数据量,检查加载器长度。
提示:先打印每步更新前的 .grad 和 len(loader)。
答案:梯度会跨步累加,第二次是旧梯度与新梯度之和;批大小超过数据量时,加载器没有完整批次。程序应明确报错,不能把一次也没有更新的过程报告为“训练完成”。
参考与实现覆盖
- Appendix A Part 1:张量、共享存储、类型、自动微分、网络、数据、训练、保存。
- Part 2:设备迁移与单 GPU 变体,正文明确未运行边界。
- DDP 启动脚本:进程组、采样器、模式、准确率和清理。
- 习题代码。上游图片不复用;本书图为原创。