主题
第 22 章 OLMo 3、Tiny Aya 与可替换模型接口
训练代码通常只要求模型把 token ID 变成 logits。因此我们可以保留同一个训练循环,替换内部架构。但“接口兼容”不等于“权重兼容”,也不等于换一个类名就能保留位置、分词和缓存语义。本章用 OLMo 3 与 Tiny Aya 的具体差异说明这条边界,再把它接回第五章的训练流程。
固定来源:OLMo 3、Tiny Aya、用其他模型重走训练章节。每个模型都有完整前向与 KV-cache 版本;训练目录另有 Llama 3.2 和 Qwen3 notebook。
22.1 OLMo 3 把 norm 放在分支输出
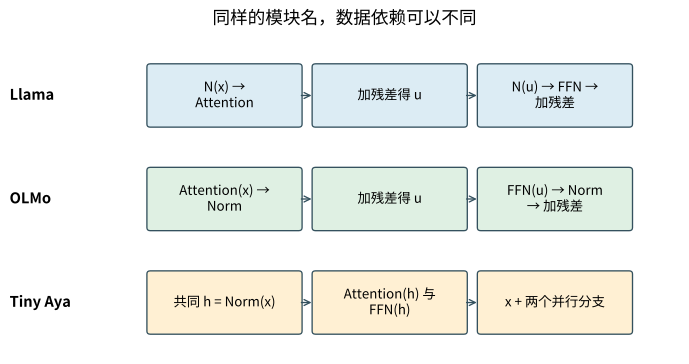
OLMo 3 的 TransformerBlock 先直接对输入计算 attention,再将 attention 输出 RMSNorm 后加残差;FFN 也先计算后归一化再加残差:
它既不是 Llama 的两个 pre-norm,也不是 Gemma 的四 norm。注意整个残差和没有被此处的 norm 归一化,norm 作用在分支输出上。权重映射要落到 post_attention_layernorm 和 post_feedforward_layernorm,不能根据相同的“norm”字样随便改成输入 norm。
OLMo attention 的 Q/K norm 发生在 拆头之前。投影 [1,1]、[10,10] 为例,头内 RMSNorm 会把两头都调成相近尺度,整体 RMSNorm 会保留两头之间约十倍的相对幅度。两种函数即使参数总 shape 可以重排,也不等价。
Q/K 随后 RoPE,KV 按组展开,query 在点乘前乘 attention_bias 明确控制四份 attention 线性层是否带 bias。7B 配置的 KV 头数等于 query 头数,32B 配置则较少;同一个 GroupedQueryAttention 类可同时表示 MHA 和 GQA,不能只看类名判断压缩率。
22.2 YaRN 不是统一放慢所有频率
OLMo 的 compute_rope_params 支持 default 与 yarn。default 是第 19 章的常规 RoPE;yarn 分支先计算不缩放频率
三个嵌套 helper 的作用清楚可分:find_correction_dim 从旋转圈数反解维度;find_correction_range 将边界向下/向上取整并裁到合法范围;linear_ramp_factor 在边界之间生成 0 到 1 的线性权重,并避免分母为零。若权重记为
这里 attention_factor=a,使旋转后的 Q/K 都多乘
模型使用全局和局部 mask,配置 layer_types 确认哪些层用滑窗。缓存版新增 offset 和外部 KV 容器,但不能只凭 sliding_window 字段断言缓存已截断,仍需检查实际切片。load_weights_into_olmo 对应投影整体 Q/K norm 的宽度;把每头 norm 的 checkpoint 强行广播过去会改变模型。
22.3 Tiny Aya:无 bias 的 LayerNorm 仍然减均值
CohereLayerNorm 先升到 float32,计算均值和总体方差,减均值后乘倒标准差,再乘 weight。它省略的是可学习 shift,并没有省略减均值步骤。因此它与 RMSNorm 的区别不会因为两者都只存一个 weight 消失。
Tiny Aya block 只归一化一次,然后 attention 与 FFN 并行地读同一个归一化输入:
与顺序残差 FeedForward 使用 SiLU 门控三矩阵,GroupedQueryAttention 支持可选 Q/K norm,但当前 block 构造时设为 False。
22.4 Tiny Aya 的位置配对与全局层例外
Tiny Aya 的 RoPE 采用偶数/奇数配对。cos/sin 频率以 repeat_interleave(...,2) 展开,旋转向量由 stack([-odd,even]).flatten(-2) 构造。Llama 使用前半/后半配对,二者要经过同一个坐标置换才能对应;只复制 cos 表会让权重布局不匹配。
固定实现仅在 sliding_attention 层对 Q/K 施加 RoPE,全局层没有这个旋转。全局层仍有因果 mask,并非可以看未来;“没有显式 RoPE”与“没有因果限制”是两个问题。局部层的位置信息也会通过残差传播到后续层,不能据此断言整个网络对顺序一无所知。
模型 create_masks 同时生成局部与全局 mask。若提供 attention_mask,代码将其从“1 表示有效 token”转成“True 表示屏蔽 key”,再与 causal/window mask 合并。左 padding 可能让 padding query 没有合法 key;即使这些位置不计 loss,也必须检查 NaN 是否沿后续计算传播。当前 notebook 不等于一个验证过任意 padding/批处理策略的推理服务器。
模型末尾归一化、输出头、logit_scale 相乘,配置可绑定输入/输出词嵌入。count_unique_parameters 检查实际共享,TinyAyaTokenizer 与 apply_chat_template 负责发布模型的角色和结束边界,生成器支持一组停止 token 而不一定只有一个 EOS。notebook 中沿用旧 Llama 描述的 Markdown 句子不应覆盖真正的 Tiny Aya 配置;本章以执行代码为准。
22.5 可替换接口:先约定张量,再约定状态
最小无缓存训练接口是 logits = model(input_ids),输入整数形状
缓存接口多了外部容器、位置计数、请求重置以及可用上下文的约束。本书建议调用方把它们一起作为请求状态管理,而不是把 model.current_pos 留在全局模型上供并发请求共享。这是从代码状态依赖推导出的工程要求,不是本书实现了并发服务。
参数加载另是一层协议:OLMo/Tiny Aya 的加载器分别映射 norm 位置、Q/K 布局、FFN 和 embedding 绑定,不能与 Llama 互换。tokenizer、chat template、BOS/EOS/pad 与输出 logits 的词表轴也是同一份模型契约。模型实例能接收相同 shape,不代表这些协议自动一致。
22.6 用 Llama/Qwen3 重走第五章训练
ch05-llama32.ipynb 和 ch05-qwen3.ipynb 前段分别内嵌对应架构,然后保留后续训练逻辑。GPTDatasetV1.__init__ 先用传入 tokenizer 编码,按步长切 max_length 个输入及后移一位的标签;__len__/__getitem__ 返回窗口与成对样本。create_dataloader_v1 把 tokenizer 作为依赖传入,而不在内部硬编码 GPT-2 编码器,这是替换成功的关键。
calc_loss_batch 将模型输出 calc_loss_loader 对有限批次累积 loss,空 loader 不能返回看似有效的零损失。train_model_simple 对每批执行清梯度、loss、backward、step,按步数评估并累计见过的 token 数。evaluate_model 暂时切 eval/no-grad,再回到 train;generate_and_print_sample 使用相同 tokenizer 和给定起始文本,避免错误的字符串/ID 往返。
generate_text_simple 裁剪上下文、取最后位置、argmax、拼回输入,是确定性演示;text_to_token_ids/token_ids_to_text 处理 batch 维,不能把多个序列随意 squeeze 成一个。plot_losses 用 epoch 与 token 数双横轴展示训练/验证轨迹,不能把较短 token 化带来的批次变化误解为模型必然更省计算。后半段保存/恢复 state_dict 与 optimizer 状态用于续训;模型配置、词表与参数绑定也须同时保存。
两份 notebook 的训练语料获取和完整训练没有在本章执行。这里解释其接口变化,核心优化与数据划分原理见第 13—18 章,不能把接口 smoke test 当成训练复现。
22.7 真实检查与补充练习
source_smoke.py 执行 OLMo/Tiny Aya 各自单元 9—14 的架构定义,用词表 31、宽度 16、两层配置验证输出 qa/architectures/source_smoke.json。没有下载 tokenizers 或 checkpoint,也没有测试宣称的长上下文长度。
题目。 ① LayerNorm 没有 bias,是否等于 RMSNorm?② 整体 Q norm 与头内 Q norm 何时可能相同?③ Tiny Aya 全局层不作 RoPE,会不会允许未来泄漏?④ 同一个训练循环替换 tokenizer 后,数据窗口是否还是同样的自然语言长度?
答案。 ① 不等,是否减均值才是关键差异。② 各头均方恰好相同、eps/缩放参数也对齐时可能一致,一般不成立。③ 不会,因果 mask 独立限制未来。④ 不一定,token 数相同不代表字符、单词或字节数相同,比较成本时要记录统计口径。
22.8 缓存差异与逐层参考测试
OLMo cache 版缓存已归一化、未旋转的key,拼接后以 start_pos - prev_len 旋转全部当前key;block在计算结束后裁掉局部层超窗部分。Tiny Aya cache 版在局部层先旋转新key再追加,且此版本没有同样的窗口裁剪。两者都能用局部mask,但持久内存增长不同。
本书 cache_checks.py 对长度6、窗口3、三个不同长度chunk进行检查:OLMo最大误差 [3,6];Tiny Aya 最大误差 [6,6]。这比只看类名或配置更能说明实际存储行为。日志记录float32容差,不作逐位相等承诺。
各模型 tests/test_*_nb.py 里的 fixture 导入定义、建立固定seed小输入和配置,再比较shape;参考等价测试实例化相应Transformers类、映射同权重、比较logits。olmo3_layer_debugger.py 另有 yarn_debug_config 和 first_mismatch,前者覆盖缩放频率,后者找最早超容差节点;tiny_aya_layer_debugger.py 对齐Cohere的并行残差、层型和位置配置。两套 build_*_pair 的可选checkpoint分支与随机小模型分支分开;hook将张量detach到CPU,按层序比较和报告,最后清理handle。这里仅运行本书的源码小配置实验;参考库未安装,未把跳过的上游对照计成成功。
参考资料
- 固定源码
ch05/13_olmo3、ch05/15_tiny-aya、ch05/14_ch05_with_other_llms。 - OLMo 官方模型资料:https://huggingface.co/allenai/Olmo-3-7B-Instruct。
- Tiny Aya 官方资料:https://huggingface.co/CohereLabs/tiny-aya-global。
- YaRN:https://arxiv.org/abs/2309.00071。
- 未验证:原模型语言质量、长上下文、任意 padding、多请求并发和完整训练。