主题
第25章 指令微调:先把“该预测什么”排对
指令微调仍然预测下一个 token。变化在训练文本的组织:模型看见任务说明、可选输入,再学习接着写回答。模板、移位和掩码中任何一处错一格,都可能产生持续下降的 loss,却训练了另一个任务。
25.1 模板是模型输入的一部分
上游 format_input 把 instruction 与非空 input 拼成统一格式,InstructionDataset 再追加响应分隔符和 output,一次性分词并缓存 token。这里的字符串不仅供人阅读,换行、空格和分隔符都会影响 token 序列。推理时必须保留训练时的提示前缀;把输出答案拼进推理输入,则会让评估看到参考答案。来源:ch07 主源码
设完整 token 序列为
较短的 Phi 风格模板可以减少输入 token,但看起来像特殊符号的 <|user|> 并不自动成为 GPT-2 的单个特殊 token。把字符串写进模板与扩展 tokenizer/embedding 是两件事,后者见第23章。习题7.1实际修改了格式化、数据集响应前缀和生成结果提取,三处必须同步。
25.2 从三条变长序列到一个 batch
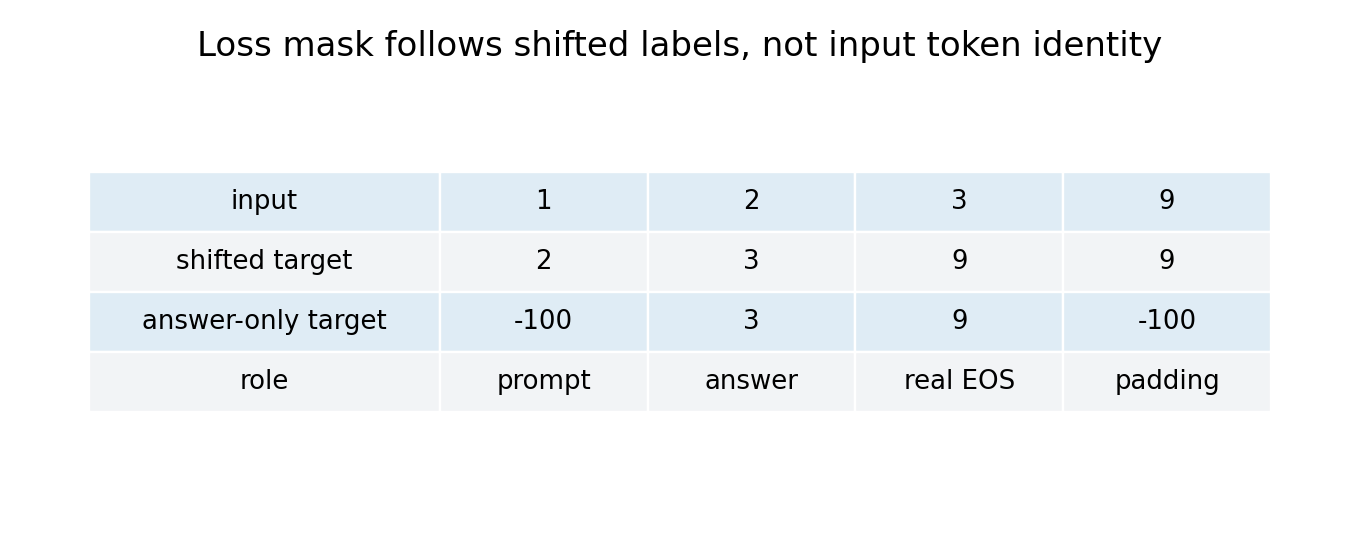
令 EOS 的教学编号为9,忽略标签为−100。一条真实序列 [1,2,3] 中前两个 token 是提示,3 是答案。追加 EOS 后为 [1,2,3,9];输入去掉最后一个,标签去掉第一个,得到 [1,2,3] 与 [2,3,9]。如果 batch 中有更长样本,就再补齐到共同长度。
| 位置 j | 输入 | 原始标签 | 回答专用标签 |
|---|---|---|---|
| 0 | 1 | 2,仍属提示 | −100 |
| 1 | 2 | 3,回答开头 | 3 |
| 2 | 3 | 9,真实终止 | 9 |
| 3 | 9,补齐 | 9,补齐 | −100 |
EOS 应保留一次,使模型学习停止;后续为矩形 batch 补入的 EOS 不应反复贡献损失。上游 custom_collate_draft_1 先展示补齐与移位,custom_collate_draft_2 再减少重复 EOS,最终 custom_collate_fn 加入长度限制和设备转移。逐步版本是为了暴露每一步责任,不是三个可以任意互换的生产实现。
本书例子用真实长度确定哪些 EOS 属于补齐。如果内容里合法包含 EOS 身份的 token,按 targets == eos_id 找“第一个 EOS”会误解真实内容。长度元数据更明确:目标位置 j 在 P <= j+1 <= L 时受监督,右端等号表示预测追加的终止符。
25.3 两种掩码不能互相代替
因果 attention mask 控制位置能读取哪些输入;loss mask 控制哪些输出位置被评分。把提示标签设成−100,不会阻止回答读取提示;这是我们需要的。反过来,把提示从注意力里屏蔽,模型即使看到标签,也失去了遵循任务所需的条件。
设 logits
展平 B、T 不改变这个目标:
python
loss = F.cross_entropy(
    logits.flatten(0, 1), targets.flatten(), ignore_index=-100
)
这一步给交叉熵的是未经 softmax 的 logits,类别轴仍是 V。若先计算 softmax,再交给此函数,相当于把概率当 logits,再做一次归一化。忽略标签必须只存在于 targets;将−100 放入 token 输入,会导致 embedding 的索引非法。
主章节默认还训练提示 token;习题7.2只训练回答。这两种目标都可以明确实现。只看 loss 数字不能直接评判优劣,因为分母和被评分 token 已改变:重复而容易的提示可能降低整体平均值,却不代表回答更好。应在同一留出任务、同一回答评分规则下比较。
交互实验:标签右移与损失掩码
数据实验室 · 标签与损失
下一格是目标,这一格该不该计分?
保留提示、回答和补齐的角色,逐格对齐输入与目标,再算真正参与平均的损失。EOS 与 PAD 即使同 ID,也不该一起删掉。
01
输入 · 先分清角色
勾选:都用 4。取消:EOS 用 4,PAD 用 0。词表始终保留 8 个类别。
0–19。在 X/Y 对齐后,从左侧保留相同数量的位置。
教学词表:问=2、答=3、好=5、吗=6、是=7;空白只用于分隔。这里按字查表,不运行 BPE 或聊天模板。BOS、EOS 与 PAD 由页面添加。
02
过程 · 角色跟着目标走
步骤 1 / 4
先保留角色和真实位置。EOS 与 PAD 都用 ID 4,但只有 EOS 是真实结束标记;这一步还没有移位。
token 和数字保持完整。窄屏可在各区域左右滑动,或聚焦后用方向键查看。
- 原位置 0BOSID 1开始源 mask 0
- 原位置 1问ID 2提示源 mask 0
- 原位置 2答ID 3回答源 mask 1
- 原位置 3EOSID 4真实结束源 mask 1
- 原位置 4PADID 4右补齐源 mask 0
上方展示截断前的原序列。源 mask 先按角色和监督范围建立;目标 mask 取它的下一格,并跟 X/Y 一起截断。错误对照会改用 ID 判断补齐。
X = [1, 2, 3, 4]
Y = [2, 3, 4, 4]
labels = [-100, 3, 4, -100]
loss mask = [0, 1, 1, 0]
输入有效位置 = [1, 1, 1, 1]
| 位置 j | 输入 X[j] | 目标 Y[j] | 目标角色 | labels[j] | mask | 目标概率 p | 原始 −ln p | 计入损失 | 原因 |
|---|---|---|---|---|---|---|---|---|---|
| 0 | BOS · 1 | 问 · 2 | 提示 | -100 | 0 | 0.513519 | 0.666468 | 0.000000 | 提示不计分 |
| 1 | 问 · 2 | 答 · 3 | 回答 | 3 | 1 | 0.279708 | 1.274009 | 1.274009 | 计入目标 |
| 2 | 答 · 3 | EOS · 4 | 真实结束 | 4 | 1 | 0.049930 | 2.997130 | 2.997130 | 监督真实 EOS |
| 3 | EOS · 4 | PAD · 4 | 右补齐 | -100 | 0 | 0.125000 | 2.079442 | 0.000000 | 补齐不计分 |
看最后一个真实 token 的边界:X 仍可能是 EOS,但它要预测的 Y 已经是 PAD。判断这一项要不要计分,必须看目标位置。
03
指标 · 只除以有效目标数
有效目标数2分母,不含 −100 位置
有效损失和4.271139每个有效目标的 −ln p 相加
平均 token 损失2.135569损失和 ÷ 有效目标数
L = 4.271139 / 2 = 2.135569
| 忽略规则 | 有效目标数 | 真实 EOS 数 | 损失和 | 均值 |
|---|---|---|---|---|
| 按真实补齐位置 | 2 | 1 | 4.271139 | 2.135569 |
| 按 PAD ID 全部忽略 | 1 | 0 | 1.274009 | 1.274009 |
按 PAD ID 忽略会漏掉 1 个真实 EOS。即使平均损失更小,也只是少评分了一个目标,不能据此说模型更会回答。
04
解释 · 不计分,仍能作为上下文
loss mask 控制哪些输出位置计入损失;attention mask 控制能读取哪些输入。提示标签设成 −100,不会从输入中删去提示,回答仍可依赖它。上面的“输入有效位置”只标出真实输入与补齐,因果注意力还会限制读取未来位置。
−100 只表示“这个标签不计分”,不是词表 ID,不能送进 embedding。这里的 X 始终是非负的词表 ID。
这些损失是怎么算出来的?
页面使用 8 类固定 logits。四行按预测位置 j 循环使用,先做 softmax,再取真实目标的概率并计算 −ln p;没有训练模型,也没有根据文本生成预测。这组数只用来核对移位、掩码和分母,不表示语言能力。
下面是未经 softmax 的分数,不是概率;未做类别加权或标签平滑。PyTorch 的 CrossEntropyLoss 接受 logits,本例的手算与默认类别索引目标的计算口径对应。
| j mod 4 | 0 · PAD(独立 ID) | 1 · BOS | 2 · 问 | 3 · 答 | 4 · EOS | 5 · 好 | 6 · 吗 | 7 · 是 |
|---|---|---|---|---|---|---|---|---|
| 0 | 0 | 0 | 2 | 0 | 0 | 0 | 0 | 0 |
| 1 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 |
| 2 | 0 | 0 | 0 | 0 | -1 | 0 | 0 | 0 |
| 3 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
和框架接口怎样对应?
本实验显式构造 X=ids[:-1]、Y=ids[1:],用于展示原理。Hugging Face GPT2LMHeadModel 的 labels 会在模型内部移位,调用时要遵守它的接口约定。本页不调用模型,也不把这里的已移位数组当作它的调用示例。
截断在对齐后同时裁剪 X、Y 和 mask。真实角色由构造时的元数据保留,不从 token 文本中猜。真实数据还需要正确的聊天模板、分词与批处理;本实验没有覆盖完整训练流程。
不操作也能读懂:原序列 [BOS, 问, 答, EOS, PAD] 的 ID 是 [1, 2, 3, 4, 4]。只训练回答时,移位后的 labels 为 [−100, 3, 4, −100]。提示“问”作为输入保留;回答“答”和真实 EOS 共两个目标参与平均。
依据:PyTorch 2.6.0:CrossEntropyLoss;Transformers 4.57.1:GPT-2 labels 接口。核对于 2026-10-14。
25.4 截断可能把监督全部截没
allowed_max_length 在 collate 后裁剪输入和标签。若提示很长,回答全部落在窗口外,答案专用掩码会使所有标签都为−100。某些平均损失路径会出现 NaN,因为没有有效项可平均。安全实现应在裁剪后检查有效标签数,过滤该样本、拒绝该 batch,或采用事先规划的提示/回答预算;不能用 nan_to_num 把数据错误隐藏成零损失。
批内动态 padding 让短 batch 少做无用计算,但不同 batch 的有效 token 数不同。若按 batch loss 简单平均来做累计训练或全局报告,会给短回答 batch 与长回答 batch 相同权重。目标到底是每 token 平均还是每样本平均,应在日志中明确。前者倾向给长样本更多权重,后者先在每条样本内平均再按样本平均。
25.5 训练与生成的闭环
主流程 main 依次加载数据、确定切分、创建 dataset/loader、选择 GPT-2 配置和权重、训练、对测试条目生成回答、保存响应与模型。这里复用第13章的训练循环和第14章的生成,不需要再发明一个“指令损失”。plot_losses 同时显示训练步或看过的 token,便于判断比较基准。
load-finetuned-model.ipynb 的 extract_response 从解码文本中删去提示前缀与分隔标记。字符串长度切片要求解码后的前缀与原输入完全一致。更坚固的接口按输入 token 数截取新增 token,再解码。因为 tokenizer 可能规范化空白,字符长度不能普遍替代 token 长度。
本章没有运行 GPT-2 medium 训练。真实 CPU 结果为:两条人工序列经 collate 后共有5个监督标签;错误地去掉所有 EOS 只剩3个,模型失去停止训练信号。梯度检查确认−100位置的 logits 梯度为零,有效位置不为零。实际 loss 为2.4031583297051915,它只校验这组固定随机 logits 的计算链,不是指令能力得分。
练习与答案
补充题:P=4,回答从完整序列下标4开始,移位后的 targets 要屏蔽多少个位置?答案:屏蔽前三个,即 targets[:P-1]。位置3的输入是提示最后一个 token,其标签已经是回答第一个 token。
补充题:截断后只剩提示,怎样处理?答案:先检测 (targets != -100).sum(),再按预先定义的数据策略拒绝或重新分配长度预算;不能把无监督样本计成成功训练。
公开习题7.3改用更大 Alpaca 数据,要同时改 URL 与本地缓存文件名,避免函数复用旧文件。更大数据带来更长训练和不同测试难度,不能横比不同测试集的平均评分。习题7.4接入 LoRA,矩阵与缩放见第28章。
来源
主 notebook、习题实现、公开解答。本章图和小实验原创;不使用原书掩码图片。