主题
第28章 LoRA:冻结大矩阵,学习一个可合并的增量
如果每个任务都更新一整套模型,保存与切换任务都很昂贵。LoRA 把每个选中线性层的更新限制为两个小矩阵的乘积。它减少的是可训练更新的自由度,并不让原模型在前向时消失。
28.1 先统一矩阵朝向
PyTorch 线性层保存
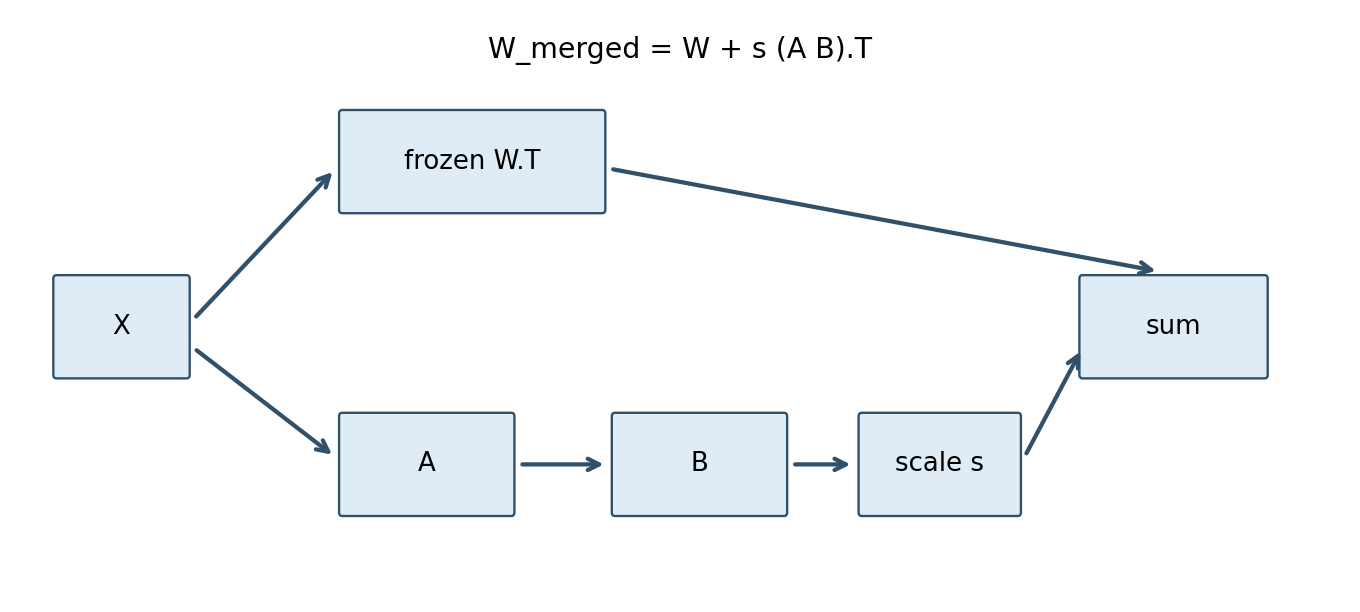
r为rank,s为缩放系数。XA把输入投影到r维,乘B再回到输出空间;增量矩阵AB的秩不超过r。学习A、B可以改变投影方向,不是只保留W的某些固定列。来源:附录E实现
普通矩阵有
28.2 缩放约定必须跟代码走
固定版本附录E与包接口使用
| 入口 | 有效倍数 | rank=16、目标倍数16 |
|---|---|---|
| ch06 additional_experiments | α | α=16 |
| appendix-E、pkg appendix_e | α/r | α=256 |
| ch07 exercise_experiments | α/r | α=256 |
不要只把命令行里的rank改大,就认为是在“公平比较更高秩”。除了参数数目,初始化幅度、有效倍数、学习率都可能改变。α/r是约定,不保证任意rank下优化动力学完全一样。LoRA 原论文
28.3 零初始化其中一边,为什么还能学
上游用随机A、全零B。这样AB=0,安装LoRA后的初始输出与原模型相同。设输出梯度为
初始B=0,所以A的梯度为0,但随机A通常让B获得非零梯度。第一次更新后B不再为0,A也能开始学习。若A、B同时为0,两边梯度都为0,这个分支会停在原地;不是把学习率调大就能解决。
我们的float64实验验证初始输出精确相同,A梯度总绝对值为0,B梯度大于0。这个等价检查不需要预训练权重,随机W就能证明实现结构是否正确。它只验证一次局部运算,不说明rank=2足以适应真实任务。
28.4 替换线性层与参数管理
LinearWithLoRA 保存原linear与新的lora,forward相加。replace_linear_with_lora 递归遍历子模块,遇到Linear就替换,否则继续递归。必须先冻结原模型,再加入新可训练分支,并在替换后建立优化器。如果先建优化器再替换,新参数不会自动进入旧参数组。
替换全部Linear包括注意力投影、前馈与输出头。也可以只选Q/V等部分,但这是另一个实验条件,不能把所有“LoRA”归为相同设置。模块名称、rank、α、基座哈希与目标层清单都应随adapter保存,恢复时先重建相同结构。若仅保存A/B,仍需获得对应基座权重;若保存整个state_dict,文件体积未必很小。
冻结W减少W的梯度与优化器状态,但仍需执行
28.5 合并与反向合并
将增量写回PyTorch的权重朝向,得到
上游 LinearWithLoRAMerged 每次forward构造合并权重,以演示代数等价;部署时可在不需要继续训练的情况下合并一次。这里没有额外非线性、也没有分支dropout时等价最直接;量化、低精度、运行中修改adapter会增加误差或同步问题。
python
merged_weight = weight + scale * (A @ B).T
merged_output = F.linear(x, merged_weight, bias)
本书实测分支与合并最大绝对误差1.6653345369377348×10⁻¹⁶,来自浮点运算顺序,阈值设1e−12。切勿在已经合并的权重上继续同时加LoRA分支,那会把增量算两次。若需要来回切换,保存不可变基座或明确合并状态,不依赖反复加减浮点矩阵完全无损。
练习与答案
补充题:1024×1024矩阵、rank=8,原参数与adapter各多少?答案:1,048,576与16,384,约1/64;这只是权重计数,不是总显存比。
补充题:A和B都置零,梯度为什么为零?答案:每个参数的梯度都乘另一个为零的矩阵。将其中一个随机初始化,另一个零初始化,才兼顾初始等价与可学习性。