主题
第 21 章 Gemma 3、Gemma 4:局部层、共享层与数值约定
Gemma 的教学实现很适合练习“同样叫 RMSNorm、RoPE、GQA,为什么不能交换零件”。Gemma 3 的零中心 norm 参数、局部/全局双套位置频率,以及 Gemma 4 的跨层 KV 共享和逐层输入,都影响真实计算路径。本章按数据流解释,不把模型名当成配置标签。
固定来源是 Gemma 3 两份 notebook 与 Gemma 4 E2B/E4B 两份 notebook。范围是文本前向与生成,不包括视觉、音频模块或全系列配置。
21.1 Gemma 3:残差分支前后都要归一化
Gemma 3 的 FeedForward 用近似 GELU 门控,而非 Llama/Qwen 的 SiLU:
RMSNorm 的 scale 初始化为 0,实际乘数是
四个
21.2 局部/全局层使用不同的位置表和 mask
模型建立 mask_global 挡未来、mask_local 再挡超过窗口的旧位置。TransformerBlock.attn_type 同时选择对应 mask 与对应 cos/sin,不能只改窗口不改位置表。局部和全局层分别使用 rope_local_base 与 rope_base,源码在模型初始化中预计算两套表。
Q/K 拆头后作可选头内 RMSNorm,再 RoPE,KV 按组展开。缩放不总是 query_pre_attn_scalar 时用它的负平方根。源码先缩放 query 再点乘,数学上等价于之后缩放分数,有限精度下舍入路径不同。
Gemma 3 的配置列出具体 layer_types。不要因为技术报告描述某种常见局部/全局比率,就假设每个小型号都具有完全相同比率。实际层数、头宽、KV 头数和窗口由当前配置决定。缓存版本增加 offset 和外部 KVCache,但局部 attention mask 不自动意味着持久 cache 已裁剪;必须看 update 前有没有切片。此处 block 在 attention 完成后,确实把局部层 cache 裁到窗口宽。attention 缓存的是已归一化但未旋转的 key:拼接以后以 start_pos - prev_len 为 key 起点重新旋转,query 则从 start_pos 旋转。不能套用 Qwen 的“缓存已旋转 key”约定。
21.3 Gemma 4:局部头和全局头可以不同宽
get_gemma4_dense_config 为 E2B 与 E4B 返回两套配置。固定源码 E2B 的残差宽度为 1536、35 层、8 个 query 头、1 个 KV 头;E4B 为 2560、42 层、8 个 query 头、2 个 KV 头。两者局部 head_dim=256、全局 head_dim=512,窗口 512。E2B 的层型为四局部加一全局的重复,E4B 为五局部加一全局的重复。第 09 章估算器里的 “E2B-like” 简化宽度不能替代这里的真实配置。
Gemma4Attention 按层类型选头宽,query 总宽为
另一个容易“顺手修错”的点:固定实现直接对
21.4 proportional RoPE 保留不旋转的子空间
全局层的 compute_rope_params 在 proportional 分支中,先按 partial_rotary_factor 计算旋转对数,生成这部分频率,再给剩余对填入零频率。零频率对应 cos=1、sin=0,坐标保持原样。这里指数分母使用完整 head_dim;Qwen3.5 partial RoPE 则按旋转宽度生成频率,两者不能只靠同一个比例统一。
对全局宽度 512、比例 0.25,旋转 64 对坐标、128 个维度,其余 384 维保持不变。因为采用前半/后半配对,旋转的坐标不是简单连续的前 128 维;必须结合配对布局理解。局部层使用自己的普通 RoPE 和较小头宽。
21.5 KV 共享必须寻找同一种层的生产者
E2B 后 20 层共享,前 15 层生产;E4B 后 18 层共享,前 24 层生产。first_kv_shared_layer_idx = n_layers - num_kv_shared_layers 确定边界。共享层在边界之前的层型列表中,反向寻找最后一个与自己同类型的层。这确保局部 query 读局部 KV,全局 query 读全局 KV;它们头宽不同,不能随意交叉读取。
无 cache notebook 提供 reuse_shared_kv 开关,默认 False,此时各层自行生成 KV;打开后用临时字典保存生产者 KV 并在同一次完整前向中共享。有 cache notebook 则从外部容器找到生产者 cache。比较两份实现时应把共享语义对齐,不能拿“所有层自算”的完整前向当作共享缓存的必然等价基准。
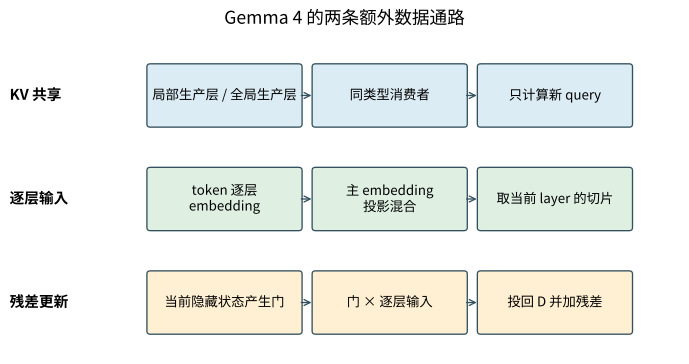
共享消费者只计算 query,从生产者取得已归一化、已旋转的 key/value,不能再追加或再次旋转。源码仍定义消费者 K/V 投影模块,这些参数是否参与前向取决于共享开关;它们的存在不代表消费者有独立 cache。缓存版 block 实际会裁剪局部生产者的 KV;这节省持久存储,但跨层消费者读取发生在裁剪之后,产生下文实测的预填充边界问题。
21.6 逐层输入:每一层都有自己的 token 侧信息
Gemma 4 E 系列的 hidden_size_per_layer_input=P 不为零。模型另外查一张 embedding 表,输出
还有一个从主 embedding 投影到
block 完成 attention 与 FFN 后,用当前状态形成门:
layer_scalar buffer。E2B 还在共享 KV 的后段层启用双宽 MLP,E4B 此配置关闭。节省某一部分计算/存储后,其他部分可能重新分配容量,不能用单一层宽估算全部层。
输出头与主 token embedding 绑定,logit softcap 为
21.7 加载器和后半段 notebook 的职责
Gemma 3 加载器映射四份 block norm、Q/K norm、GELU 三投影、embedding/final norm/output。Gemma 4 加载器还处理不同 checkpoint 前缀、逐层 embedding 与投影、layer scalar、V norm 的无参数约定,以及共享层可能缺失的独立权重。get_tensor 尝试认可的键名前缀,assign 核对 shape 并转到目标 dtype/device。找不到权重不能悄悄视作随机初始化的成功加载,必须检查实际映射分支与报告。
resolve_local_model_dir 只是按多个候选位置寻找已存在文件;后面的 Hub 下载与 safetensors 分片合并是另外的外部动作。tokenizer 包装 tokenizer.json,chat template/终止 token 是生成协议;目录 README 的示例输出不是本书新生成结果。模型许可与代码许可分开处理。本书不复制原图,也不执行认证、下载或生成质量比较。
21.8 实测与补充题
source_smoke.py 白名单执行 Gemma 3 单元 8—13,以及 Gemma 4 单元 9—13、15。在小词表、窄隐藏层上得到有限 qa/architectures/source_smoke.json,PyTorch 2.6.0+cpu、seed 1949、单线程。
题目与答案。 ① Gemma 3 的 norm 参数全零是否让输出全零?不是,实际乘数为
21.9 一个实际失败案例:共享消费者读到了裁剪后的 prompt
本书对 Gemma 4 作了额外的同权重比较:词表31、残差宽16、4层、局部/全局交替、后2层共享、窗口3,输入6个token。基准是无cache notebook 打开 reuse_shared_kv=True 的完整前向;对照是缓存 notebook 一次预填充全部6个token。最大logit差为 3.50999856,不是舍入误差,也不是通过结果。测试程序与日志为 examples/architectures/cache_checks.py 和 qa/architectures/cache_checks.json。
原因是局部生产层先完成自己的 attention,再把 next_cache 裁成最后3个位置;后面的局部消费者从外部容器读取这份裁剪结果。对于 prompt 前半部分的 query,本应可见的早期key已经不在。有限最小值mask还可能让全屏蔽行变成均匀分布,掩盖NaN警报。最后几个query或单token解码看似正常,不代表整个预填充等价。
修复方向是区分“当前前向供所有消费者读取的KV”和“留给下一步的持久裁剪缓存”:在消费者完成以前保留当前块所需的完整视图,之后才裁剪持久状态,并用绝对位置对齐mask。这是建议的修复设计,本书没有修改固定上游,也没有声称完成该修复。原规模checkpoint是否触发同样幅度的差异,未测试。
Gemma 3 的独立分块检查通过,最大误差 [3,6],分别对应局部/全局;这也实际核实了局部裁剪确实存在。
21.10 上游参考对照与逐层调试的范围
Gemma 3 的两个 test_*_nb.py 分别加载普通/缓存 notebook,检查小模型shape,并在参考库可用时将同一随机权重映射到两边比较输出。gemma3_layer_debugger.py 先构造模型对,hook embedding、block、final norm等节点;详细版增加 _register_trace_hook 和 block 内部投影/norm记录,_format_diff_line/format_report 可以只展开首个偏离block或全部block。embedding hook 需补乘真实前向的缩放,否则会把记录点不一致误报成模型错误。hook handle 在比较结束后移除,避免重复注册改变后续记录。
Gemma 4 的 test_gemma4_nb.py 还检查E2B/E4B命名配置、没有旧接口 n_kv_groups 时的前向、流式生成helper、带 model.language_model. 前缀的加载,以及可选本地checkpoint生成。gemma4_transformers_module 临时切换已存在的本地参考源码路径和模块表,结束时恢复;这些环境技巧并不意味着当前安装的Transformers支持Gemma4。本书没有执行其可选本地大checkpoint测试。
tests/test_e2b 与 test_e4b 中的 debugger 各自提供小配置、参考config转换、定义导入、模型对构建、hook收集、层名排序、差异报告。两者必须保留不同的共享层与MLP设置,不能只改文件名。当前环境未安装参考库,故这些上游逐层对照是静态解释边界,不是本书通过项。
参考资料
- 固定源码
ch05/12_gemma3、ch05/17_gemma4。 - Gemma 3 技术报告:https://arxiv.org/abs/2503.19786。
- Google 官方 E2B 模型资料:https://huggingface.co/google/gemma-4-E2B。
- Google 官方 E4B 模型资料:https://huggingface.co/google/gemma-4-E4B。
- 未验证:多模态分支、原尺寸模型、checkpoint 数值对齐、量化与长上下文质量。