主题
第24章 文本分类:一个输出位置,决定模型看见多少内容
把一封短信分成两类,看起来只需把 GPT 的词表输出换成两个数字。难处藏在后面:这两个数字取自哪个位置?补齐后的最后一列算不算文本结尾?冻结了参数以后,优化器真的不会再动它吗?本章沿着这些问题,把分类微调拆成可检查的步骤。
24.1 从逐词预测改成整段判断
设输入 token 为 X,形状为 B×T,其中 B 是批量大小,T 是补齐长度。GPT 最后一层产生
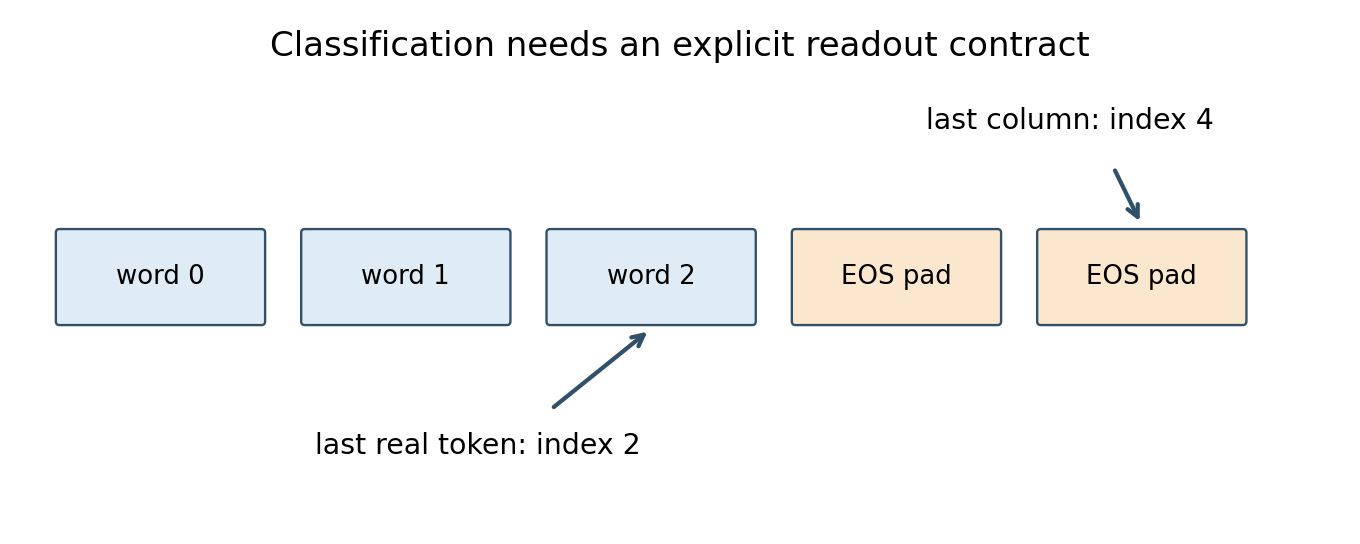
因果注意力使位置 t 只能依赖 0…t 的输入。因此,取第一位置时,模型无法利用后续文字;取最后真实 token,才有机会汇总完整输入。上游主实现使用固定补齐后的最后位置 model(input_batch)[:, -1, :],这个位置虽然可能是 EOS 填充,却仍可看见前面的真实内容。这不是索引错误,但模型会学习“经过若干填充位置之后再判断”的任务,训练与推理的补齐长度必须一致。来源:固定版本 ch06 主实现
独立实验改用显式长度,以便把这个约定看清楚:
python
positions = lengths - 1
selected = logits[torch.arange(batch_size), positions]
loss = cross_entropy(selected, labels)
lengths 是截断后、补齐前的长度,形状为 B;selected 为 B×C;labels 为 B 个整数类别。真实应用中行索引也要放到 logits 所在设备。空文本会让位置变成 −1,必须先拒绝、补一个约定的起始 token,或定义专门空文本路径,不能悄悄使用最后一列。
交叉熵对样本 i 的值为 argmax 则只负责推理时选类别,不能先对 logits 做 argmax 再求损失,因为离散选取切断了所需梯度。
24.2 数据集先确定长度,再划清训练与评估
download_and_unzip_spam_data 负责取得源文件;create_balanced_dataset 抽取与 spam 数量相同的 ham;random_split 固定打乱后切成训练、验证、测试集合。平衡采样便于教学,也改变了类别先验:在真实收件箱里,垃圾短信比例未必是二分之一。由此得到的准确率不能直接解释为上线误报率,应同时看混淆矩阵、precision/recall,并在接近部署分布的数据上校准阈值。
SpamDataset 先分词、截断,再以 token 50256 补齐。训练集最长长度可决定 T;验证集和测试集应沿用这个长度,避免批形状或训练约定变化。让每个集合各自决定最长长度,会把“比较同一个分类器”变成“比较不同补齐任务”。__len__ 决定可抽样条数,__getitem__ 返回 long 类型输入与类别;类别必须在 0…C−1 内。
附加实验的 flexible 位置用 (input_batch != 50256).sum(1)-1 推断长度。它只适用于右补齐且真实文本中没有这个 token 的情况。我们的人工输入第二行 [2,9,4,9] 中,第一个 9 是真实内容,最后一个 9 才是 padding;真实结束位置是 2,按“不等于 9”计数却得到 1。保存长度能避免把数据含义交给 token 身份猜测。上游 no_padding 路径还要求不同长度样本不能被默认 collate 直接堆叠;单条 batch 或显式动态 collate 才能处理。
24.3 冻结不是切断整条计算图
常见起点是冻结骨干,只训练新输出头;然后逐步开放最后一个 Transformer block、最后两个 block 或全模型。上游 instantiate_model 提供 small、medium、large、xl 四组 GPT-2 结构,weights 区分随机初始化与预训练,trainable_layers 决定可训练范围。比较时必须同时记录这些条件,否则“更大的模型更好”可能只是用了不同初始化。
python
for p in backbone.parameters():
    p.requires_grad_(False)
optimizer = AdamW((p for p in model.parameters() if p.requires_grad), lr=lr)
这一顺序使优化器只接收当前要训练的参数。冻结参数仍参与前向计算;如果可训练层位于被冻结层之前,梯度还需要穿过冻结层传回前面,不能把整个冻结模块包进 no_grad()。eval() 与冻结也不是同一件事:前者改变 dropout 等层的行为,后者改变参数是否求梯度。
我们的 CPU 检查发现,冻结骨干权重保持不变、梯度为 None,分类头发生更新。但另一条反例先留下 p.grad=1,再设 requires_grad=False,SGD 仍把 1.0 更新成 0.9。冻结不会清除已经存在的梯度。因此动态切换训练范围时,应清空梯度并重新核对优化器参数组,而不只是更改标志。这个结果来自 examples/finetuning/contracts.py,并非上游大模型训练。
| 范围 | 可修改内容 | 主要成本 | 容易遗漏的条件 |
|---|---|---|---|
| 只训练输出头 | 固定表示上的决策边界 | 小 | 骨干表示可能不适合任务 |
| 最后一或两层加头 | 高层任务表示 | 中 | 最终归一化是否也开放 |
| 全模型 | 所有表示 | 大 | 过拟合、优化器状态、遗忘 |
| LoRA | 指定线性层的低秩增量 | 随 rank 变化 | 缩放约定与替换范围,见第28章 |
24.4 附加实验怎样构成有意义的对照
additional_experiments.py 把输出位置、平均池化、因果掩码、上下文长度、训练层数、LoRA、模型大小、batch 和梯度累积放到命令行。每个开关改变的不是同一种成本。扩大 T 增加注意力矩阵;开放更多参数增加梯度和优化器状态;累计若干 microbatch 改变一次更新所见样本数,却不会增加单次前向的 batch。
平均时间轴上的 logits 是另一种读出方式。若包含 padding,长短文本受到不同程度的稀释;若先掩码再平均,必须除以有效长度。关闭因果掩码则使每个位置可以读取右侧输入,对纯分类未必造成目标标签泄漏,但它改变了预训练时的注意力模式。不能把这种比较称为“只改分类位置”。
梯度累积还有一个尾组问题。源码每个microbatch都除以固定 accumulation_steps,最后不足一整组也执行更新;若仅剩k个batch而设定累积a个,且k<a,尾组梯度会按a而非k归一化,更新幅度偏小。batch大小不等时还需按样本数加权。随机dropout存在时,“大batch一次更新”与“小batch累积”也不保证逐位相同。比较前先固定目标分母、随机行为和尾组策略。命令行 --ignore_index 在固定版本中被解析,但main调用训练函数时未转发 args.ignore_index;不要仅凭帮助文本就认定更改该参数已生效。
calc_loss_loader、calc_accuracy_loader 在评估模式和无梯度状态下遍历有限 batch;evaluate_model 把训练循环中的评估集中处理;train_classifier_simple 负责清梯度、反传、更新和定期记录;plot_values 仅可视化历史,不参与优化。若最后一个 batch 较小,简单平均 batch loss 不等于按样本加权平均。严谨比较要累计 loss 总和与样本数。
24.5 IMDb:先问表示是否值得付出成本
IMDb 扩展把同一训练接口应用于影评。download_prepare_dataset.py 的下载、逐文件读入、分区保存对应三个不同责任:网络取得、标签解释、集合边界。不得因为目录已下载就重新随机混合原始测试集来挑模型。这里没有下载完整 IMDb,也没有运行大型训练。
train_sklearn_logreg.py 与 sklearn-baseline.ipynb 用词袋特征和逻辑回归建立廉价基线。词袋忽略词序,却能利用很多强烈情感词;它的失败例是复杂否定、讽刺和跨句依赖。这里的CountVectorizer词表必须只在训练集拟合;若另行改用TF-IDF,其IDF也必须仅在训练集拟合,否则测试集信息已经参与特征构造。dummy 多数类基线则告诉我们类别失衡本身能带来多少准确率。
train_bert_hf.py 使用双向编码器的分类接口;train_bert_hf_spam.py 把该路线用于短信。train_gpt.py 沿用解码器读出思路。train_gpt_muon.py 的 create_muon_optimizers 把适合矩阵更新的参数与其他参数分组,优化器原理见第17章;不能把优化器变化误记成模型结构收益。横向比较必须固定集合、截断预算、调参机会、训练次数,并报告耗时与显存,不只挑最高准确率。来源:IMDb 扩展目录
24.6 保存、恢复与检查
load-finetuned-model.ipynb 先重建 GPT,再把输出头改成两类,最后载入 state_dict;若先载入两类权重到词表头,形状会不匹配。推理 classify_review 必须使用训练时的 tokenizer、截断长度、padding 和读出位置。只保存权重而不保存这些约定,模型文件不能独立说明自己在做什么。
运行本章小实验:在书目录执行 python examples/finetuning/contracts.py。环境要求 PyTorch 2.6 CPU;完整命令和实际输出见 qa/finetuning/README.md。人工 logits 在最后真实位置预测 [0,0],最后一列预测 [1,1],证明索引会改变结论;它不证明哪种读出在真实数据上准确率更高。
练习与答案
补充题:两个样本有效长度分别为 2、4,右补齐到 4。写出最后有效位置,并解释第一位置为什么不能完整分类。答案:位置为 1、3;因果第一位置看不到后来三个 token。若改双向注意力,这个论证的前提就不成立。
公开解答复盘:ch06 习题6.1改上下文长度,6.2改全量训练,6.3改第一 token。先预测计算量和信息范围,再读官方解答的实验记录。不要把原记录的准确率当成本书复现,也不要从单次差值推出普遍结论。代码入口以当前文件 additional_experiments.py 为准,旧示例中的连字符文件名不是实际文件名。
来源
本章依据固定源码原创解释;重复骨干 previous_chapters.py 对应第3–6、13–15章,新增分类数据与目标在本章逐步说明。完整文件、函数和单元映射见 research/finetuning/source_coverage.json。主 notebook;附加实验;CrossEntropyLoss 官方文档。