主题
第 04 章 从加权平均推导自注意力与因果掩码
上一章把 token ID 和位置变成了输入向量,但每个位置得到的仍只是自身的信息。要预测后续文本,模型还需要结合上下文来理解这个位置。注意力就负责这一步:当前位置提出查询,给各个可见位置打分,再把分数转成权重,按权重汇总这些位置提供的信息。
本章沿着上游 ch03 的顺序,从一个不含可训练投影的点积例子开始,逐步加入 Q、K、V、因果限制、dropout、批次和多头。先把每一步为什么需要、形状如何变化弄清楚,第 5 章再比较不同实现如何完成同一计算。主 notebook
4.1 先把加权平均写清楚
设三个输入向量为
softmax 可以完成这一步。对分数
变换后的权重每项非负、总和为 1。此例得到
这个结果混合了三个输入向量的信息,作为第二个位置的新表示;注意力并没有只从中挑出一个向量。代码里的两层循环可被 scores = X @ X.T 取代,全部上下文向量则是 softmax(scores, dim=-1) @ X。最后一维对应各个提供信息的位置,沿这一维归一化,才能让每个查询分配出去的权重之和为 1。
若
4.2 为什么拆成查询、键和值
前面的例子直接用输入向量完成匹配,也用它传递内容。这两项工作被绑在了同一套表示上。为了让模型分别学习怎样查找信息、怎样被匹配,以及传递什么内容,可以引入三个可训练矩阵:
这里
行
上游 SelfAttention_v1 直接保存 [D_in,D_out] 的 Parameter,用 x @ W;v2 使用 nn.Linear,保存的是转置布局。两版的初始化方式不同,即使用相同 seed,结果也不一定相同。上游习题把 v2 的三份权重转置后交给 v1,这样先对齐权重,再比较输出,才能检查两种布局是否实现了相同计算。
4.3 缩放因子来自点积的方差
有了 Q、K、V,还需要控制点积分数的尺度。先作一个便于分析的假设:查询和键的每个分量近似独立、均值为零、方差为 1。点积
除以
上述推导说明了为什么要控制初始化时的尺度,并不保证训练过程中的各个分量始终独立。多头注意力要用每个头的宽度
4.4 因果掩码为什么应放在 softmax 前
到这里,每个位置都能汇总整段输入。但在下一 token 预测中,未来内容正是模型要预测的答案,不能提前参与计算。预测位置
于是 torch.triu(..., diagonal=1) 标记严格上三角,再 masked_fill(..., -torch.inf)。
如果先 softmax 再把未来位置置零,剩下的权重通常不再和为 1。上游先展示这种中间状态,再除以每行剩余和,最后换成 softmax 前的掩码。精确算术下,后掩码并重新归一化可得到相同结果;实际程序还需要考虑数值稳定性,也没有必要先计算随后就要丢弃的未来概率。
在这里的因果掩码中,要保留对角线,让当前位置能看见自己;位置 0 尤其依赖这个条件。如果整行全是负无穷,普通 softmax 会出现 NaN。padding mask 与因果 mask 叠加后也可能产生空行,尤其是左 padding。因此,检查时既要核对掩码形状,也要确认每一行是否还留有允许访问的位置。
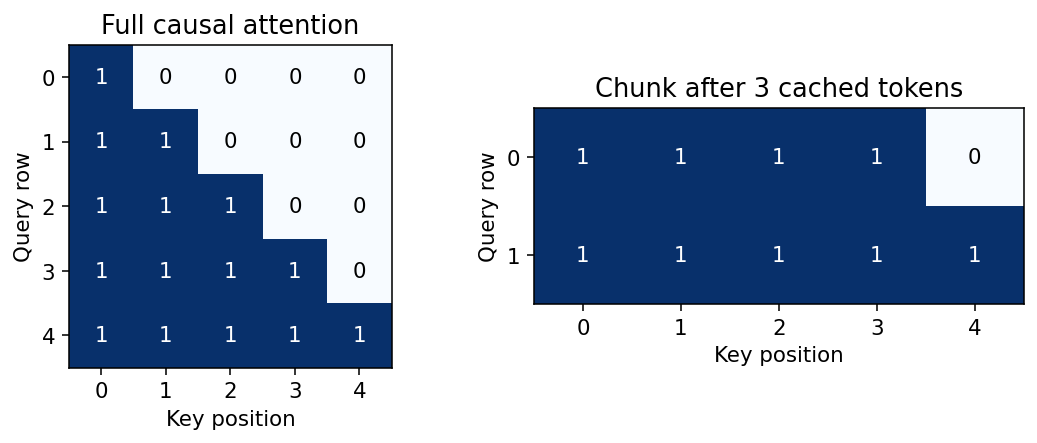
图中 1 表示允许参与注意力。左图每一行只能看见对角线及其左边;右图提前展示第 8 章的缓存场景:已有三个位置时,新块第一行可看见四个位置,而不是从第一列重新开始画三角形。
交互实验:注意力权重与因果掩码
让一个查询走完注意力的五步
改一组 Q、K、V,追踪某个查询如何筛掉未来位置,再把可见的值混合成输出。这里实际计算单头注意力;不包含投影、多头或 dropout。
01
先选一个要观察的问题
02
调输入,看同一条计算链怎样改变
每行一个位置,空格或逗号分列,换行或分号分行。范围 −100~100,最多 4 × 4;数字只用于教学,不是模型的语义向量。
03
沿着五步,查看真实中间结果
1 / 5 · 修改参数会重新演算
第 1 步:点积打分。当前查询 q1 = (0.0000, 1.0000)。 逐个计算 q 与每把键 k 的点积,得到匹配分数。
当前查询q1向量 (0.0000, 1.0000)
掩码后可见的键待掩码共 3 把键;屏蔽项权重为 0
当前行权重之和待归一化softmax 后检查,不用四舍五入的显示值相加
表格保留完整数值。窄屏可横向滚动;键盘聚焦表格区域后,用左右方向键查看。
| 键位置 | q · k | 缩放后 | 掩码后 | 权重 A |
|---|---|---|---|---|
| 0 | 0.0000 | 待计算 | 待计算 | 待计算 |
| 1 | 1.0000 | 待计算 | 待计算 | 待计算 |
| 2 | 1.0000 | 待计算 | 待计算 | 待计算 |
04
带着一个问题再试一次
试一试:怎样验证因果性?
使用三位置因果例,跟踪位置 1,走到最后一步。只改 K、V 的最后一行,位置 1 的输出应保持不变;关闭因果掩码后再比较。零分数例的权重三行分别是 (1,0,0)、(½,½,0)、(⅓,⅓,⅓)。掩码发生在 softmax 前,不能直接删掉概率而不重新归一化。
这里只演示等长序列的因果掩码,不模拟 padding 或缓存偏移;关闭掩码时 Q 与 K 可以不等长。一般注意力中 dᵥ 也不必等于 dₖ。所有屏蔽行都没有有效概率分布,本例保留对角线以避免这种情形。
不操作也能读懂:两键例中 q=(1,0)、k₀=(1,0)、k₁=(0,1)、V=(10,20)。缩放后权重约 (0.6698,0.3302),输出约 13.3024。
公式依据:Attention Is All You Need,§3.2。输入数字仅为本书教学示例。
4.5 通过修改未来输入来验收
掩码写好后,怎样确认模型没有偷看未来?可以固定前四个位置,只给后两个位置加上很大的扰动,再比较前四个输出。如果因果限制正确,这些输出就不应改变。配套实验用 [B,T,D]=[2,6,12],3 个头,在 float64、评估模式下执行此检查,最大前缀差为 0。
这个测试还可以检查输入梯度:早期位置的损失不应依赖未来输入。测试前需要关闭 dropout,或者让两次计算使用同一随机掩码,否则随机变化也会造成输出差异,干扰判断。与只看注意力矩阵是否呈三角形相比,这样的测试直接检查了未来输入会不会影响过去的输出。
4.6 dropout 并不保持每行权重和恰好为 1
因果测试中暂时关闭的 dropout,是训练时的另一项处理。上游把它放在 softmax 之后,对注意力权重进行随机丢弃。以概率
推理时 dropout 应关闭。nn.Dropout 会服从 model.eval();某些函数式接口需要调用者显式把概率设为 0,第 5 章将说明。两种掩码在这里也要分清:dropout 在训练时随机丢弃部分权重;因果掩码限制未来信息,在生成时仍然需要遵守。
交互实验:dropout 单次结果与期望
这一行没有加到 1,dropout 就算错了吗?
softmax 后的一行权重原本和为 1。训练时,dropout 会独立丢弃其中的项,再把保留项乘以 1/(1−p)。换一个掩码,看看这一行的和怎样变化。
01
同一行权重,两种运行模式
保留项乘以 1/(1−p)。训练 p=1 会报错,不会自动截断。
02
选一个掩码,逐项计算
位从左到右对应权重 0、1、2……;1 表示保留,0 表示丢弃。这里手动选掩码,不调用随机数;依次查看掩码也不等于随机抽样。
第 1 步:检查原权重。 原权重之和为 1.000000。训练模式有效 p=0.5。
表格可左右滑动;键盘聚焦后用左右方向键查看。
| 位置 | 原权重 a | 掩码 m | m × a / (1−p) | 概率加权期望 |
|---|---|---|---|---|
| 0 | 0.200000 | 待选择 | 待计算 | 待计算 |
| 1 | 0.300000 | 待选择 | 待计算 | 待计算 |
| 2 | 0.500000 | 待选择 | 待计算 | 待计算 |
试一试,以及本例的边界
默认权重 [0.2,0.3,0.5]、p=0.5:掩码 101 的行和为 1.4,010 为 0.6,001 为 1,000 为 0。把 p 改成 0.2,再比较各掩码的概率。切换评估模式,有效 p=0,权重保持原样。
本例只讨论固定权重上的独立 dropout。它不模拟训练、梯度或训练效果,也不把 dropout 当作因果遮挡。原先为 0 的权重仍为 0。本例排除训练 p=1,因为这里使用的 1/(1−p) 公式会除零;这是教学范围限制,不是声称 PyTorch 不接受 p=1。
不操作也能读懂:保留时的放大,抵消了丢弃造成的期望损失。要检查 softmax 行和,应在 dropout 前检查;评估模式则关闭 dropout。
算法语义依据:PyTorch nn.Dropout 官方文档。掩码枚举与教学数字由本例提供。
4.7 加上批次和多个头
前面的计算可以同时用于一批序列,也可以拆成多个注意力头。每个头各自计算一组权重,再把结果合并。设批次输入 [B,T,D_o],再改形状为 [B,T,H,d],交换中间两轴得到 [B,H,T,d]。
此时矩阵乘法自动对每个批次、每个头独立进行:
分数形状是 [B,H,T,T],上下文是 [B,H,T,d]。交换回 [B,T,H,d],把最后两维合并为 [B,T,D_o],再用输出投影混合不同头的信息。
上游最早的 MultiHeadAttentionWrapper 实例化多个独立 CausalAttention 并拼接,它的 d_out 表示每个头宽度;后来的 MultiHeadAttention 中 d_out 表示所有头的总宽度。这两个参数虽然同名,指的却不是同一个宽度。若直接照搬数值而不核对形状,输出宽度就可能扩大
交互实验:多头张量拆分与合并
拆成多个头以后,同一个元素去了哪里?
给投影后的张量每个元素一个唯一编号,再跟着它走过 reshape、transpose 和合并。编号只用来识别元素,不是 Q、K、V 的实际数值。本例用 D 表示总投影宽度,对应正文的 Dₒ。
01
设定形状,选择跟踪对象
教学规模:B≤2、T≤4、D≤12、H≤4,且 D 必须能被 H 整除。所有下标从 0 开始。
02
五步布局,编号始终不变
第 1 步:投影后的张量。轴 [B, T, D],形状 [1, 3, 4]。元素 e2 现在的坐标是 [0, 0, 2]。 它原来属于批次 0、位置 0、特征 2。
当前形状 · [B, T, D][1, 3, 4]轴的顺序是布局的一部分
每头宽度 · d=D/H2总宽度均分到各头
唯一元素总数12每一步保持数量和身份
e2:原坐标 [b,t,c] = [0,0,2];h = floor(c/d) = 1,r = c mod d = 0。
张量可左右滑动;键盘聚焦后用左右方向键查看。双线框标记当前跟踪元素。
按 B → T → D 的顺序展示;每组固定前 2 个下标,最后一维从 0 排列。可点任意编号跟踪它。
[0, 0, :]
[0, 1, :]
[0, 2, :]
共 12 个唯一元素;每一步数量相同,身份没有丢失。这是逻辑坐标展示,不承诺实际内存连续,也不表示发生了数据复制。
试一试:形状相同,元素就一定相同吗?
默认 [B,T,D]=[1,3,4]、H=2、d=2。e2 的坐标依次是 [0,0,2] → [0,0,1,0] → [0,1,0,0] → [0,0,1,0] → [0,0,2]。比较中间两轴,就能看到 T、H 的交换与还原。
合并阶段打开错误对照:e2 会错到 [0,1,2];点选 e6,则会看到它从正确坐标 [0,1,2] 错到 [0,2,0]。再把 D 改为 5,会因无法均分成两个头而停止计算。这里未模拟 batch 广播、不同 Q/K/V 宽度、缓存或 GPU 性能。
不操作也能读懂:reshape 把特征下标 c 拆成 h 和 r;transpose 交换 T、H 两个轴。合并前必须先换回,才能把同一位置的各头拼接起来。
操作语义依据:PyTorch 官方 reshape 与 transpose。reshape 可能返回视图或副本,不应依赖其中一种;本例只检验元素的逻辑顺序。
4.8 配套实现怎样对照每一行
回到配套代码,可以按刚才的形状变化逐步对照。core.py 的 Attention 把三份投影合成一个 Linear(D,3D,bias=False)。chunk(3,-1) 分成 Q、K、V,再 reshape 和 transpose 分头。scores 用最后两轴乘法,布尔 future buffer 截出需要的行列,softmax 后乘 V,最后合并头并输出投影。第 8 章解释它额外接受的 cache 参数;不传 cache 就是本章的普通因果注意力。
压缩版 multihead-attention.ipynb 的 Variant A 把单头类命名为 CausalSelfAttention,并在 wrapper 拼接后额外加入输出投影;主 notebook 最早的 wrapper 没有这一层。Variant B 则使用一次投影后拆头的 MultiHeadAttention。压缩版还接上了第 3 章的数据、token 与位置 embedding,可以一起检查从输入到注意力的接口。
主检查脚本还直接比较手写注意力和 PyTorch SDPA,使用 Q、K、V 形状 [2,3,5,4]。已有检查记录中,float64 最大前向差约
4.9 练习与答案
上游习题依次检查权重布局、每头宽度和参数数量。习题 3.1 要把 v1/v2 的权重转置对齐,见 4.2。习题 3.2 要让两个独立头拼接后的总宽度为 2,因此每头 d_out 应为 1。习题 3.3 用 D=768、H=12 构造 GPT-2 尺寸的注意力,QKV 无偏置时参数为
再用下面几道补充题检查对权重、形状和掩码的理解。
- 三个分数全为 0,因果掩码后的三行权重分别是什么?
,列出 Q、分数、合并头输出的形状。 - 为什么
softmax(scores, dim=-2)可能不报错却不正确? - 试把因果掩码的
diagonal=1改成 0。预测第一行会发生什么,再运行一个小例子。
答案:三行分别为 [1,0,0]、[1/2,1/2,0]、[1/3,1/3,1/3]。Q 分头后 [2,3,5,4],分数 [2,3,5,5],合并后 [2,5,12]。错误 softmax 沿查询行归一化,不能保证每个查询对键的权重和为 1。遮住对角线后第一行没有合法键,普通 softmax 出现 NaN。
参考与覆盖
- 主 notebook:点积循环、矩阵化、两版投影、掩码的两种推导、dropout、批次、wrapper 和拆头。
- 压缩版实现:同一 MHA 的集中实现,映射到 4.7—4.8。
- 习题:权重布局对照。