主题
第 06 章 把注意力组装成 GPT:归一化、残差与输出头
注意力已经能让一个位置汇总上下文,得到新的向量。要把它组装成 GPT,还需要回答几个问题:特征尺度怎样控制?每个位置的向量怎样做非线性变换?多层之间怎样传递信息?最后,又怎样把向量变成词表中每个 token 的分数?本章沿着这些问题,把完整的计算路线接起来。
上游先搭出 DummyGPTModel,用不做计算的占位 block 和归一化层检查接口,再逐项换成实际模块。这样可以先发现维度接不上的地方。不过,占位模型验证的只是外壳,尚未执行真正 Transformer 的计算。固定版本 ch04 主代码
6.1 配置是一组互相约束的尺寸
先约定几个尺寸:词表
为了方便逐项核对,本书从小配置开始:[2,6],应得到 [2,6,16] 的 logits,也就是每个位置对应的词表分数。后面的参数计数和数值对照都以这些约定为前提;文中实验数字来自已有记录,本次文字修订没有重新运行模型。
6.2 LayerNorm 沿最后一个特征轴工作
先看尺度控制。LayerNorm 在每个位置内部计算统计量;对向量
[B,T,D],均值和方差形状为 [B,T,1],不同批次和不同位置各自归一化,不跨 token 混合。
用一个小例子就能看清方差约定的影响。设 [-1,1]。若改用无偏样本方差,分母变为 var 的默认设置观察统计量,正式 LayerNorm 则明确设置 unbiased=False。核对正式层时,要使用后者的约定。
这个例子还不能直接变成训练后的断言。加入
6.3 GELU 与逐位置前馈网络
GELU 的常见定义为
ReLU 会把所有负输入截成零;GELU 则允许部分负输入产生小的负输出,过渡也更平滑。上游把两条曲线画在一起,是为了说明函数形状,不能据此判断训练效果孰优孰劣。对于要载入预训练权重的模型,激活函数还是兼容性的一部分,随意更换就改变了模型计算。
有了激活函数,就可以组成逐位置的前馈网络:先把每个位置从
按这里的数学布局,
数值对照时还会遇到一个小差别。上游 GELU 在前向中创建 torch.tensor(2.0 / torch.pi),常数精度受默认浮点类型影响;本书则使用 nn.GELU(approximate="tanh")。两者使用相同近似公式,但 float64 输出未必逐位一致,后面的误差阈值考虑了这个差异。
6.4 残差提供一条直接传递的路径
若层输出为
式中的恒等项让反向传播多出一条直接路径,信号不必全部穿过层内变换。不过,这并不保证梯度永远不会消失或爆炸:分支函数
上游 ExampleDeepNeuralNetwork 只在输入、输出形状相同的层启用 shortcut,再用 print_gradients 比较各层权重的平均绝对梯度。最后一层从宽度 3 变为 1,不能直接做残差相加;跨维度连接需要额外投影。
要从这个例子看出残差的影响,应保持 seed 和架构相同,尽量只改变是否添加残差。重复调用梯度打印函数前也应清零,避免把旧梯度算进本次观察。
6.5 一个完整 block 的先后顺序
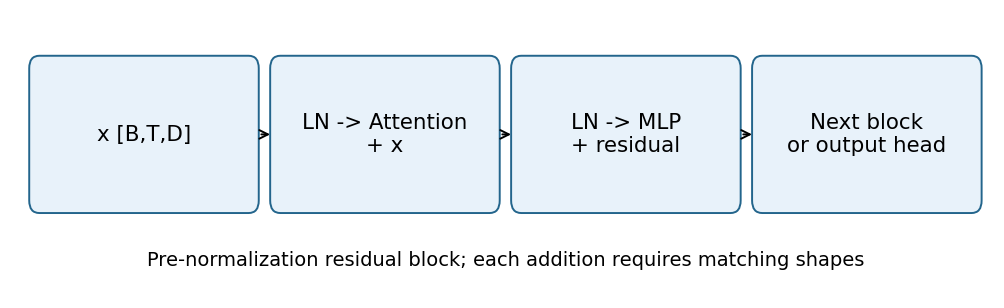
把归一化、注意力和 FFN 放进同一个 block 时,顺序同样重要。上游使用 pre-norm,也就是先归一化,再进入子层:
两个归一化层分别拥有自己的参数。注意力和 FFN 的输出都回到 [B,T,D],才能与各自的残差相加。尤其要顺着更新后的状态往下走:FFN 应加回的是经过注意力残差更新的
主配置用同一个 drop_rate 控制 embedding、注意力权重和残差分支上的 dropout。上游练习把它们拆成 drop_rate_emb、drop_rate_attn、drop_rate_shortcut,方便分别调节。实际修改时要同时更新构造器和调用处;只新增配置键,某条路径可能仍在读取旧值。
6.6 从 ID 到 logits 的完整路线
GPTModel 把这些模块串成一条完整路线:先查 token embedding,加上位置 embedding,经过 embedding dropout,再依次通过 [B,T,D],直到输出头才改变最后一维。
本书 TinyGPT 使用 ModuleList,是为了在第 8 章逐层传递缓存;普通上游版本使用 Sequential,因为每个 block 只接收一个 x。两种容器都能注册子模块,区别在于怎样组织调用。
得到 logits 后,模型内部不必再做 softmax。训练损失会完成稳定的归一化计算,而贪心生成只需要用 argmax 找到分数最高的项。
输入 embedding 与输出头权重都是 [V,D],因此可以共享同一个 Parameter。不过,计算参数总数时减掉一份输出头,只是在估算共享后的数量,并没有实际建立共享。要让两处共同更新,必须使两个属性指向同一参数;只复制数值,训练后它们仍可能各自变化。上游主代码默认使用独立参数,只额外打印了共享情况下的数量供比较。
6.7 用参数数量检查有没有漏层
模块接好以后,参数数量可以帮助排查是否漏层或多加了一层。在 QKV 无偏置、注意力输出有偏置、FFN 有偏置的约定下,每个 block 包含:
- QKV 与输出投影:
; - FFN:
; - 两个 LayerNorm:
。
合计
代入小配置:
上游练习还比较注意力与 FFN 的参数量,并配置 small/medium/large/xl。其 get_config 会先复制基础字典,再改宽度、层数和头数;遇到未知名字就抛错。对于大配置,可以先代入公式估算,不必仅为了数参数就把所有张量分配出来。
6.8 与上游对齐,误差应该怎样解释
参数总数相同,仍不能证明计算相同,还要把权重对齐后比较输出。配套 run_checks.py --upstream runtime_sources/upstream 会读取固定版本的 gpt.py,只执行六个经过检查的类定义,不运行下载、分词或大模型 main。随后将本书的 token/position embedding、LayerNorm、FFN 和输出头参数逐项复制到上游模型,再把合并 QKV 权重沿输出轴拆成三份。
已有 results.json 记录显示:在相同小配置、float64、dropout 0、输入 [2,6] 下,最大 logits 差为
上游的 tests.py 采用另一种检查方式:先规范换行和行尾空白,再对大默认配置的完整终端输出做字符串回归。它有助于发现输出格式或随机序列的变化,但结果也依赖版本、初始化和生成设置。本书没有直接运行这个大配置测试,也没有把它输出的随机乱码当成本书实验结果。
6.9 生成循环是外层程序
generate_text_simple 每次截取最后 context_size 个 ID,前向后取最后位置 logits,argmax 得到 [B,1],拼回序列。主 notebook 先 softmax 再 argmax,集中脚本省去 softmax,二者在有限、非 NaN logits 下的最大位置一致。
随机初始化模型也能完成这个循环,说明调用流程可以走通,却不能证明它已经学会语言。生成前应调用 model.eval(),并使用 no-grad,避免训练态 dropout 和不必要的梯度记录。
另一个需要留到第 8 章处理的条件是上下文窗口:截断会改变模型看到的输入,绝对位置也会每次从零编号。这与持续保留全部历史的缓存计算不同,不能直接假定两者等价。
6.10 练习与答案
可以用下面三题检查整条路线。第一题:
第二题:为何位置 embedding 不能与 token embedding 混成同一个索引表?同一 token 可以出现在多个位置,因此输入要同时表达内容和位置这两个独立索引。直接混用一个 ID,无法保留这两项信息。
第三题:把 LayerNorm 方差的分母从
参考与覆盖
- ch04 主 notebook:占位骨架、LayerNorm、GELU 图、FFN、shortcut、完整 GPT、计数与生成。
- 集中脚本 gpt.py:本书小配置对照目标;其中复用的数据和注意力代码见第 3—4 章。
- 习题与变体:模块计数、四档尺寸、三种 dropout。