主题
第 17 章 学习率、梯度裁剪、超参数与 Muon
一个训练循环能下降,不代表它已经适合更长训练或更大模型。学习率决定每步更新幅度,裁剪限制异常梯度,超参数搜索决定怎样比较实验,优化器则规定如何利用梯度历史。这些机制最好逐项引入,每加一项都先检查边界。
上游 ch05 的 scheduler 目录指向 Appendix D,另有网格搜索脚本和 Muon 双优化器示例。本章覆盖这些路径,不把短文本上的一次结果当作优化器排名。Appendix D
17.1 先约定 step 表示什么
设
当
上游 Appendix D 用 global_step 从 -1 开始、更新前加一;网格搜索从 0 开始、每次先加一,且 warmup 条件使用 <=。两者都能定义合理日程,但第一步学习率不同,不能只比较相同 warmup 数字就说完全一样。
17.2 为什么先升后降
初始参数和优化器统计尚未适应数据时,较小的学习率可以限制早期更新;warmup 逐步达到目标步幅。后期降低学习率则缩小每次移动,帮助在当前区域细调。这是机制解释,不是保证每个任务都需要相同 warmup 比例。
本书示例
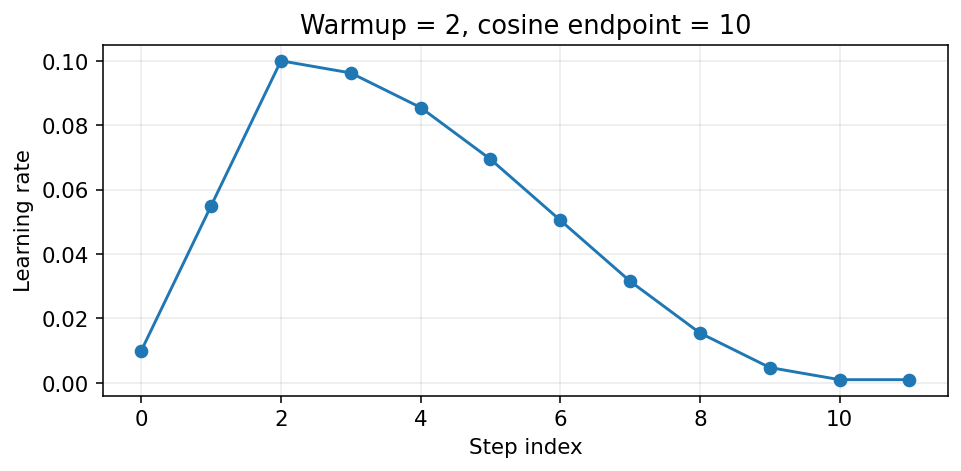
上游前两个日程展示循环只记录 learning rate,计算 loss 和更新权重处是注释。这是可视化日程,不是已经训练了模型。最终 train_model 才把日程、反向、裁剪、更新和评价放在一起。
17.3 梯度裁剪缩放整组向量
把所有参数梯度拼成一个向量
若 (0.6,0.8)。方向保持,长度被限制。逐元素 clamp 到 [-1,1] 则得到 (1,1),方向已经改变,二者不能混称同一种裁剪。
clip_grad_norm_ 在 backward 后、optimizer.step 前执行,并返回裁剪前的总范数。配套实测为 5,裁剪后因实现 epsilon 得到约 [0.5999999,0.7999998]。检查时用容差,不要求十进制打印恰好等于 0.6、0.8。
上游 find_highest_gradient 找的是各梯度中的最大有符号元素,不是最大绝对值,也不是总范数。如果梯度全为负,打印出的“最高”值尤其不能代表最大幅度。可用它观察某种变化,但不能据此判断全局裁剪是否正确。
17.4 日程和裁剪的边界要一起测
固定 Appendix D 保留 ORIG_BOOK_VERSION 分支,说明 > 与 >= 的一位差别会跳过 warmup 结束后的某次裁剪。当前默认分支在 global_step >= warmup_steps 时裁剪。是否应该 warmup 时也裁剪属于训练设计,不是数学必需;如果目标是始终限制梯度,可以每次 backward 后都裁剪。
空 loader、总步数不大于 warmup、零 warmup 都需要处理。把 warmup 占总步数 20% 后取整,小实验可能得到零。梯度非有限时还应先排查 loss 与数据,而不是假定裁剪能把 NaN 修好。
混合精度若使用梯度缩放,应先 unscale 再按真实梯度阈值裁剪;梯度累积则在所有 microbatch 累积完成后裁剪一次,才对应整批梯度。否则每个 microbatch 各自改变方向和比例,结果不再等同于整体裁剪。
17.5 网格搜索的乘法预算
上游网格有批量 4 档、dropout 3 档、warmup 3 档、weight_decay 3 档、peak_lr 4 档、initial_lr 2 档、min_lr 3 档、epoch 5 档,总计
组。每组都重新建模型、数据 loader 和优化器,训练后按验证 loss 更新 best 配置。这个数量说明:随意增加一个维度的档位会乘法放大成本,不能把一个教学网格直接当成可接受的默认任务。
比较时还要统一预算。不同 batch_size 在相同 epoch 下更新次数不同,warmup_iters 占比也不同;不同 n_epochs 又改变总 token 次数。若目标是比较计算效率,应按同 token 或同计算预算评价,而不只看最终最低 loss。
上游把每组 seed 重设为 123,有助于控制初始化;但数据顺序、批量、dropout 的随机数消费仍不同。eval_iter=1 只看一个验证 batch,噪声与偏差都可能很大。调参反复看同一验证集后,最终报告还需要未参与选择的测试集合。
17.6 搜索脚本的失败路径也属于实验
warmup 大于总步数时,训练可能始终在 warmup;warmup 等于总步数时余弦分母为零的边界要避免;initial_lr 高于 peak_lr 时所谓 warmup 实际在下降。应在生成配置时先过滤不合意组合,并记录被过滤原因。
上游打印最优配置时,有的训练 loss 变量来自最后一次运行,不一定是最佳验证配置对应的训练 loss。中断也可能发生在第一次成功结果之前。稳健记录应把配置、训练/验证指标、步数、seed 和状态保存在同一条结果里,而非依靠多个全局变量碰巧同步。
本书不执行 12,960 组搜索。它保留搜索空间计算与日程边界断言,读者可以先用小模型、少数组合验证整个记录流程,再决定实际预算。hparam_search.py
17.7 Muon 改变的是矩阵更新方向
Muon 针对二维矩阵参数,使用动量并对矩阵更新方向做正交化处理。上游引用的研究强调权重衰减和更新尺度对大模型训练的重要性;其大规模结果属于论文实验,本书没有复现。Muon is Scalable for LLM Training
用一个独立数学例子理解“正交化”:以满秩矩阵的薄 SVD
本书用 float64 SVD 验证这个小例子,并检查方向转置乘自身为单位矩阵。这个程序只是解释矩阵方向,不是完整 Muon:实际优化器还包含动量、可选 Nesterov、近似正交化迭代、尺度规则和权重衰减。PyTorch 的 Muon 接口使用 Newton–Schulz 相关设置及学习率调整选项;具体参数以所用版本为准。PyTorch Muon 文档
17.8 两个优化器必须不重不漏地分参数
上游 create_muon_optimizers 先遍历 Embedding 模块收集其参数名,再遍历所有可训练参数:二维、且不属于 embedding 的参数交给 Muon;其他交给 AdamW。于是注意力与 FFN 矩阵进入 Muon,embedding、偏置和归一化向量进入 AdamW。独立输出头也是二维非 embedding,因此在这个具体示例中进入 Muon,这不是所有 Muon 配方统一的选择。双优化器源码
本书按参数对象身份做同样的分组审计,小 GPT 的 Muon 候选共 6,400 个元素,AdamW 候选 864 个,总和 7,264,交集为空。权重共享时更应按身份去重,防止同一参数被两个优化器各更新一次。冻结参数不应进入任一组。
训练每步对两个优化器都清零,只 backward 一次,再依次 step;保存续训时必须保存两份优化器状态。每组可以有不同学习率,调度器也要分别管理,不能用一个 lr 无意覆盖两组比例。max_steps 在更新后检查,若允许 0,需要定义是否真的零步,否则简单后检查会先更新一次。
本书环境 PyTorch 2.6.0+cpu 实测没有 torch.optim.Muon,上游函数会明确抛出 RuntimeError。我们没有升级共享环境,没有运行 Muon 训练,也没有用自写 SVD 例子冒充其实现。分组与数学方向检查是已完成部分,正式 Muon 优化器路径保留为未运行。
17.9 练习与答案
补充题一:
补充题二:把两个 microbatch 的梯度各自裁剪再相加,是否总等于相加后裁剪?答案:不等,裁剪是非线性操作。例如两个梯度方向不同、范数不同,各自缩放比例会改变合成方向。
补充题三:embedding 是二维矩阵,为何没有自动分给 Muon?答案:分组是优化配方的选择,不能只看维数;上游明确排除 embedding,并为它使用 AdamW。补充题四:只保存主模型权重后恢复双优化器训练会缺什么?答案:两组动量/统计、各自学习率与调度阶段,以及数据和 RNG 进度。
执行 python examples/core_training/optimizer_numerics.py qa/core_training/optimizer_numerics.json 可复查分组、SVD 示例和日程非法边界;主检查脚本记录完整日程与梯度裁剪值。
参考与覆盖
- Appendix D:日程展示、梯度检查、修正分支、综合训练和绘图。
- scheduler 入口、网格搜索。
- Muon baseline 与变体:复用训练、评价、图和生成见第 13—14 章,新增分组与双优化器在本章。